登录社区云,与社区用户共同成长
邀请您加入社区
本文介绍了Flutter三方库http_cache_hive_store在鸿蒙系统(OpenHarmony)中的应用指南。该库通过将HTTP缓存协议与Hive数据库深度整合,为鸿蒙应用提供极速网络响应缓存能力。文章详细解析了其工作原理、核心API及典型应用场景,包括启动优化和IoT状态同步等。针对鸿蒙平台的适配挑战,特别强调了缓存雪崩防护和并发读写处理。该方案能显著提升鸿蒙应用的网络性能,实现&q
在开发大型或复杂的鸿蒙(OpenHarmony)应用时,组件间的通信往往是一个棘手的问题。当两个距离很远的页面(例如:个人设置页与首页通知图标)需要共享一个状态更新时,传统的构造函数传参或单纯的状态管理可能显得过于繁重。event提供了一种优雅的基础事件总线(Event Bus)实现。它基于 Dart 的Stream机制,允许不同组件通过订阅特定的事件类来监听消息,从而实现完全解耦的通信模式。
什么是 HTTP Cache Hive Store?它不仅是简单的数据保存,而是一个将“HTTP 缓存原语(RFC 7234)”与“Hive 极速 KV 引擎”深度融合的适配器。它支持自动处理缓存头的过期逻辑(Max-Age),并提供毫秒级的物理检索性能。在 Flutter for OpenHarmony 的实际开发中,利用该库,我们可以让鸿蒙应用以“零网络损耗”的方式加载已存取的 API 资源。
Flutter Hive 数据持久化实战:血压记录本地存储指南 本文介绍了使用Hive实现Flutter血压记录应用的数据持久化方案。作为NoSQL数据库,Hive相比SQLite具有性能优异(快10倍以上)、零配置、类型安全和跨平台等优势。文章详细展示了如何配置Hive依赖、创建自定义适配器存储血压记录对象,并实现完整的存储服务类,包含初始化Hive、保存记录(单条/批量)、按日期范围查询等功能
Flutter Hive数据持久化实战:血压记录本地存储指南 本文介绍了如何使用Hive实现Flutter血压记录应用的本地数据持久化。作为一款NoSQL数据库,Hive相比SQLite具有更快的速度、更简单的配置和更好的类型安全性。文章详细讲解了Hive的安装配置流程,并通过创建BloodPressureRecord适配器演示了如何存储自定义对象。核心实现包括初始化Hive、注册适配器、打开Bo
本文详细介绍了Spark在Local和StandAlone两种模式下的安装配置过程。实验环境基于三台CentOS 7节点,依赖Hadoop 3.3、MySQL 8和JDK 8。Local模式安装包括解压Spark包、创建Python虚拟环境、配置环境变量及测试PySpark运行。StandAlone模式扩展为集群部署,详细说明了多节点环境配置、Spark参数调优、HDFS日志目录创建及历史服务器设
#!/bin/bash#set -xsource /etc/profilekinit -kt /etc/security/keytabs/smokeuser.headless.keytab ocdp-goertekvn@GOERTEK.VNPRIMARY_NODE=“vn-ns-bpit-dp-nn-17-6”SECONDARY_NODE=“vn-ns-bpit-dp-nn-17-7”PORT=“
Hive中的表分为内部表(Managed Table)和外部表(External Table),主要区别在于数据管理方式。内部表由Hive完全管理,数据存储在Hive仓库目录,删除表时会同时删除数据;而外部表仅管理表结构,数据可存放在HDFS任意位置,删除表时不删除数据文件。内部表适合Hive专有数据,外部表适合多系统共享数据场景。两者查询方式相同,但外部表能防止误删数据,更适合生产环境。关键区别
当 Hive 使用 Spark 引擎执行任务失败时,通常源于配置兼容性问题。:以上步骤覆盖 90% 的兼容性问题。若问题持续,请提供完整的 YARN 应用日志和。关键配置片段进一步分析。
为什么说Hive是基于Hadoop的呢?首先Hive映射成的数据表是存储在HDSF中的;其次Hive要将SQL语句在底层解析成MapReduce程序来进行计算;最后Hive的运行程序是在Yarn的管理下执行的。Hive是一个基于Hadoop的数据仓库工具。它能够将结构化的数据文件映射为一张表,并提供类SQL查询的功能。
│ 数据分析师/大数据开发 ││ 写SQL查询 │↓│ Hive ││ 把SQL翻译成分布式计算任务 ││ │ Metastore: 知道数据在哪、什么结构 │ ││ │ HiveQL: SQL方言 │ ││ │ 驱动层: 解析-优化-执行 │ │↓│ Hadoop ││ │ HDFS: 实际存储数据文件 │ ││ │ YARN: 分配CPU/内存资源 │ ││ │ MapReduce/Spark
构建在hadoop之上的数据分析工具,没有数据存储能力,只有使用数据的能力,操作数据交互采用sql,元数据存放在Derby或者Mysql上,数据存储在HDFS中,分析数据库底层实现的是MapReduce,执行程序实在Yarn上。
摘要: 本文介绍了一个用于管理Hadoop/YARN+Hive+Spark集群的一键启停脚本。脚本支持start/stop命令,严格按照组件依赖顺序执行操作,包含启动状态检测功能。关键特性包括:环境变量检查(HADOOP_HOME/SPARK_HOME/JAVA_HOME)、权限控制要求(必须使用hadoop用户执行)、带状态检测的启停函数、以及详细的执行日志输出。脚本按照HDFS→YARN→Hi
【基于html,python,django,hadoop,mapreduxe,yarn,hdfs,hive,推荐协调过滤,mysql,大数据,在线招聘信息分析系统-哔哩哔哩】 https://b23.tv/jSIXyF4。基于html,css,jquery,echart,python,django,hadoop,mapreduxe,yarn,hdfs,hive,推荐算法协调过滤,mysql数据库,
集成 YARN 3.0,支持 GPU 资源调度(需配置。
技术范围:uniapp框架,Android,Kotlin框架,koa框架,express框架,go语言,laravel框架,thinkphp框架,springcloud,django,flask框架,SpringBoot、Vue、SSM、HLMT、Jsp、PHP、Nodejs、Python、爬虫、数据可视化、小程序、安卓app、大数据、物联网、机器学习等设计与开发。(2)性能上应合理考虑运行环境、
本文介绍了如何在鸿蒙系统中适配高性能NoSQL数据库Hive,实现轻量级本地数据存储与治理。Hive通过内存映射和二进制序列化技术,提供了远超SQLite的读写速度,特别适合鸿蒙高刷场景下的数据持久化需求。文章详细解析了Hive的核心原理、初始化流程、Box操作和TypeAdapter使用,并给出典型应用场景示例。同时针对鸿蒙平台的沙箱路径和多进程访问等适配挑战提供了解决方案,最后通过资产管理组件
本文介绍了在Flutter for OpenHarmony应用开发中使用Hive CE实现数据持久化的方案。Hive CE作为纯Dart编写的键值存储库,具有高性能和良好兼容性优势。文章详细讲解了环境配置、三种典型使用场景(简易配置存储、自定义模型映射、响应式UI),并针对OpenHarmony平台提供了避坑指南。最后通过构建一个具备AES-256加密能力的鸿蒙安全账户保险箱实例,展示了Hive
摘要: Hive作为纯Dart实现的NoSQL数据库,是鸿蒙(OpenHarmony)应用本地持久化的高效解决方案。其核心优势包括毫秒级查询(基于内存索引)、支持AES加密及适配鸿蒙沙箱环境。通过Box容器存储数据,结合Type Adapters实现自定义对象映射。 关键点: 初始化适配:需处理鸿蒙启动时序问题,推荐异步预加载与沙箱路径降级策略。 极简API:支持键值读写、数据监听自动刷新UI,适
摘要:本文提出ClouderaCDP7(华为鲲鹏版)与银行五大核心业务平台的技术对接方案。该方案通过统一数据湖仓架构,实现核心银行系统、渠道平台、风控平台、数据中台和开放银行平台的数据融合与治理。方案采用Iceberg表格式、实时流处理和安全治理等技术,支持批流一体数据处理、字段级权限控制和动态脱敏,满足金融行业合规要求。通过混合云部署和信创适配(鲲鹏+国产OS),为银行数字化转型提供安全可控的数
网易数帆EasyData可与华为CloudCMP构建定制化ChatBI方案,通过JDBC/ODBC实现异构集成。该方案保留CMP作为数据底座,利用EasyData提供智能交互层,适用于需国产化改造且保留现有数据架构的企业。实施需解决元数据同步、权限映射等技术适配问题,虽非官方标准方案,但技术可行,尤其适合多云环境和信创要求场景。典型应用案例包括金融机构在合规要求下实现中文智能数据分析。
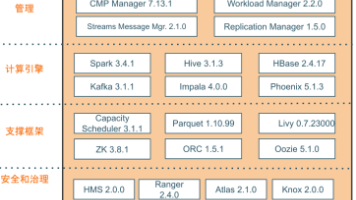
摘要: Cloudera CDP7.3(国产CMP鲲鹏版)为银行五大核心平台(核心系统、渠道平台、风控平台、数据中台、开放银行)提供统一数据湖仓与治理方案。通过CDC、实时流处理(Kafka/Flink)及批量ETL实现多源数据安全入湖,依托Iceberg表格式、Spark/Flink计算引擎及CML特征服务支撑智能风控、客户洞察等场景。方案强调金融级合规,通过Ranger权限控制、Atlas血缘
于是,我们调查了这家知名公共托管服务的 ASN,但仅发现了两个相关性有限的 IP 地址,这两个 IP 地址都位于同一国家。组织应优先确保配置的正确性,尽量减少敏感端口的暴露,并实施强有力的身份验证机制,以防止类似此次案例中发现的漏洞。通过 Censys 搜索,我们确定了两个自主系统号(ASN)——一个属于 Digital Ocean,另一个属于我们之前提到的主要提供商之一,这是一家知名的公共托管服
Why Kotlin?ConciseDrastically reduce the amount of boilerplate code/*Create a POJO with getters, setters, `equals()`, `hashCode()`, `toString()` and `copy()` in a single line:*/data cla...
本文系统对比了Flutter开发中三种主流本地存储方案:SharedPreferences适用于简单键值对存储,如用户配置和Token;Hive适合复杂对象和本地缓存,提供高性能NoSQL解决方案;SQLite则擅长处理结构化数据和复杂查询。文章详细介绍了每种方案的企业级实现方法,包括代码封装、分层架构设计和最佳实践,强调应根据数据类型和访问模式选择合适的存储方案。同时提出了分层架构、错误处理、性
本文详细介绍了在国产麒麟aarch64系统上安装Cloudera CDP 7.3和CMP v7.13的完整流程。主要内容包括:1)安装前的准备工作,如关闭防火墙、设置主机名、互信配置等;2)关键组件安装步骤,包括Python 3.9.14、PostgreSQL、MySQL 8.0.39等;3)Cloudera Manager的安装与配置;4)通过WEBUI进行集群设置和服务安装。文档还提供了详细的
本文介绍了从CDH平台迁移到国产化CMP7.13平台的Hadoop实战方法,聚焦海量数据处理到AI决策落地的全流程。核心内容包括:1)Hadoop作为数据与算力双底座的架构设计;2)分阶段实操指南(数据采集、存储优化、特征工程、模型训练、决策落地);3)国产化迁移脚本示例;4)企业级保障体系。文章强调通过工具化、标准化和闭环化方法,实现AI决策从数据输入到业务输出的完整链路,并提供了具体的配置参数
2025年AI时代数据中台BI技术转型建议:随着AI原生、大模型驱动的自然语言交互(NLQ)和实时决策成为主流,Hadoop生态组件需从传统SQL引擎转型为智能数据服务支撑层。Hive应聚焦元数据治理,成为可信数据注册中心;Impala适用于高安全私有化场景的高性能查询;Spark作为通用计算基座,支撑语义层与AI集成;Flink则专精实时BI与智能决策。建议企业将CDH平台迁移至CMP7.13类
2025年数据中台BI架构演进建议:Hadoop生态组件(Hive、Impala、Spark、Flink)将从"前台查询引擎"转型为"后台数据服务"。Hive定位历史数据仓库,Spark作为通用计算引擎构建语义层,Flink成为实时BI核心组件,Impala仅适用于私有化高性能场景。建议企业迁移至CMP7.13平台,实现与AI增强型BI工具(支持NLQ、实时
摘要:过去十年,Hadoop作为大数据核心引擎曾引发技术狂热,但其"万能底座"的承诺在现实中暴露出诸多泡沫。技术层面,数据湖沦为沼泽、批处理无法满足实时需求、存算耦合导致资源浪费;经济层面,开源不等于低成本,人力运维成本远超预期;组织层面,IT与业务脱节,数据分析未能真正普及;生态层面,组件割裂难成体系;时代层面,AI浪潮下Hadoop无法满足新需求。如今企业正转向云原生架构和
腾讯云TBDS与Cloudera CMP在大数据平台选型中存在明显差异:TBDS优势在于深度国产化支持(信创适配、等保合规)、AI原生能力及低成本模型,特别适合国内金融政务场景;而CMP强项在于全球合规认证、Impala的OLAP性能及多云统一管理能力,更适合跨国企业。主要缺陷对比:TBDS存在生态封闭(绑定腾讯云)、跨云能力弱的问题;CMP则面临在华落地困难、许可成本高昂(约5千美元/核/年)及