【强化学习】强化学习原理及相关概念介绍
强化学习介绍
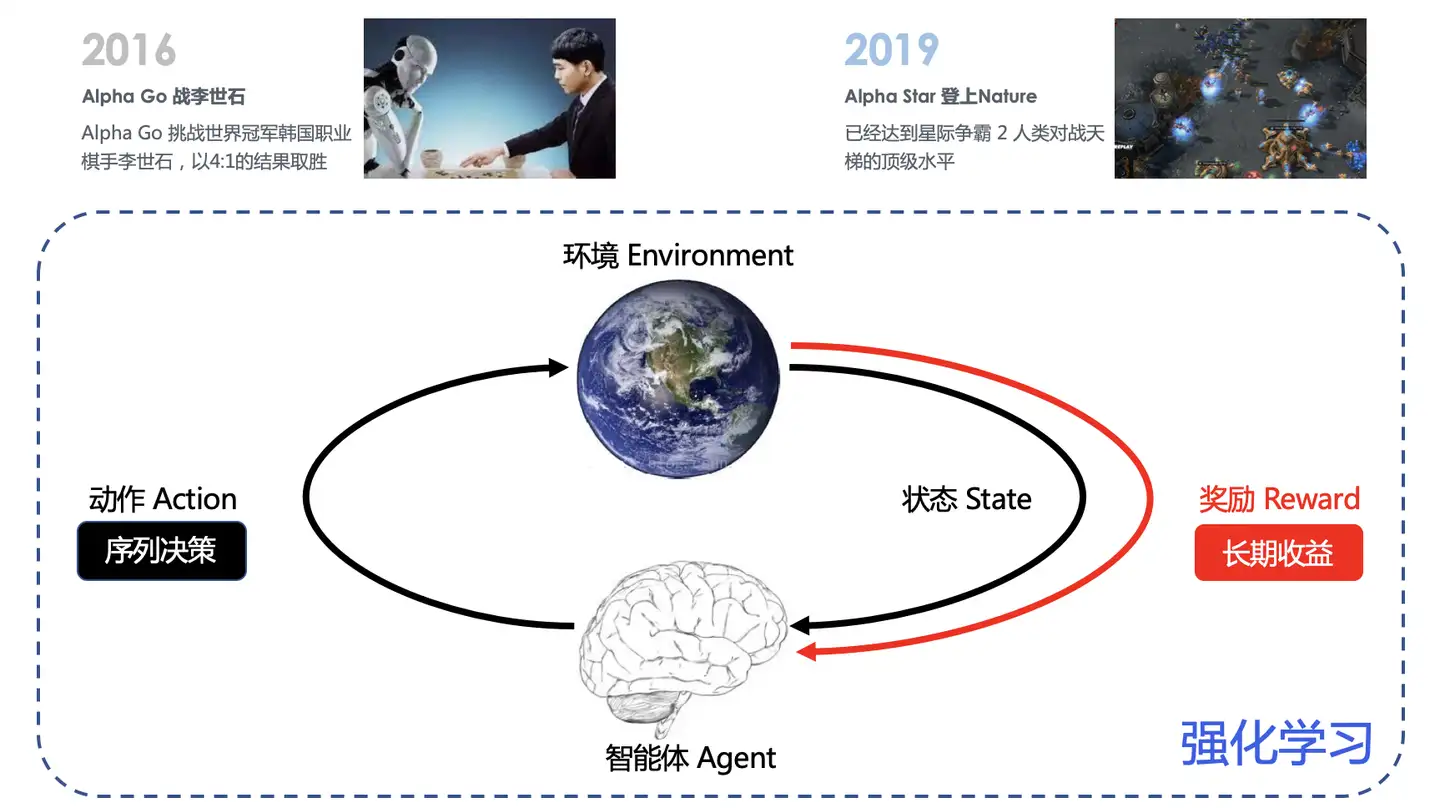
强化学习(Reinforcement Learning, RL)是一种机器学习方法,它通过智能体(Agent)与环境(Environment)交互来学习策略(Policy),使得在不同状态(State)下采取的动作(Action)能够最大化累积奖励(Reward)。强化学习的核心思想是试错学习(Trial-and-Error Learning)和延迟奖励(Delayed Reward)。
强化学习有几个关键概念:
-
智能体(Agent):做出决策的实体,它与环境进行交互。
-
环境(Environment):智能体所处的外部系统,智能体的行动会影响环境的状态,环境会根据智能体的行为给予反馈。
-
状态(State):环境在某一时刻的情况或配置,智能体基于这些状态做出决策。
-
动作(Action):智能体在特定状态下可以采取的行为。
-
奖励(Reward):智能体采取某个动作后,从环境中获得的反馈,奖励可以是正面的(促进目标的实现)或负面的(阻碍目标的实现)。
-
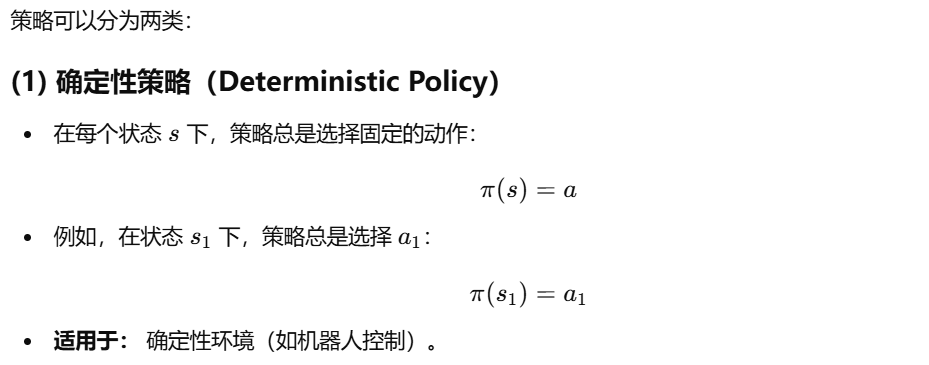
策略(Policy):智能体在给定状态下选择动作的规则或函数,策略可以是确定性的也可以是随机的。
-
价值函数(Value Function):衡量状态或动作的长期回报,评估某个状态或状态-动作对的好坏,价值函数帮助智能体了解在某个状态下采取行动的长期收益。
强化学习的特点:
- 无监督学习:不需要标注数据,智能体通过试错学习。
- 延迟奖励:智能体的动作可能在未来才获得奖励。
- 动态环境:环境可能随时间变化,智能体需要适应。
强化学习的目标是找到最优策略,使得智能体在长远来看能够获得最大的累计奖励。
价值函数
强化学习中的环境由一个马尔可夫决策过程(MDP) 建模。价值函数有状态价值函数和状态-动作价值函数之分:
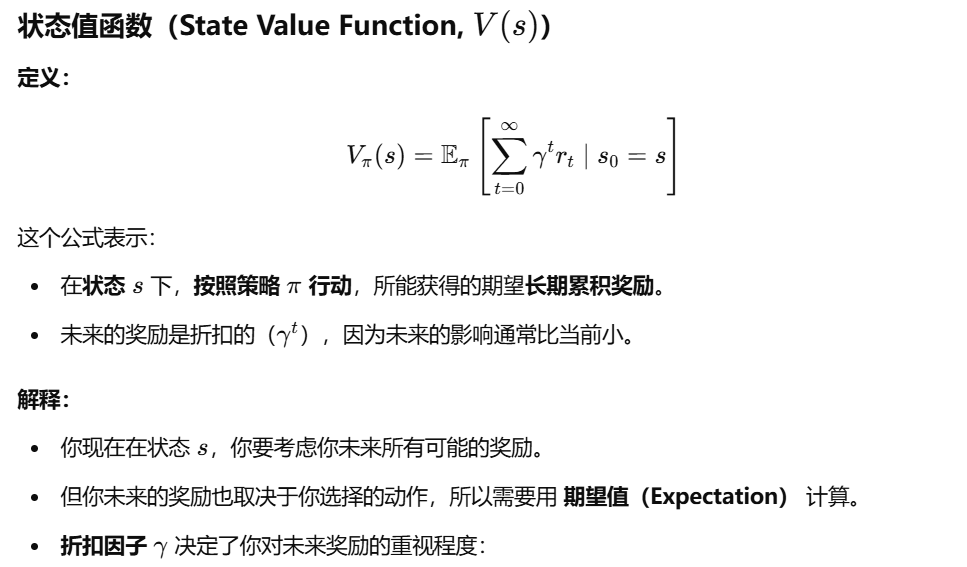
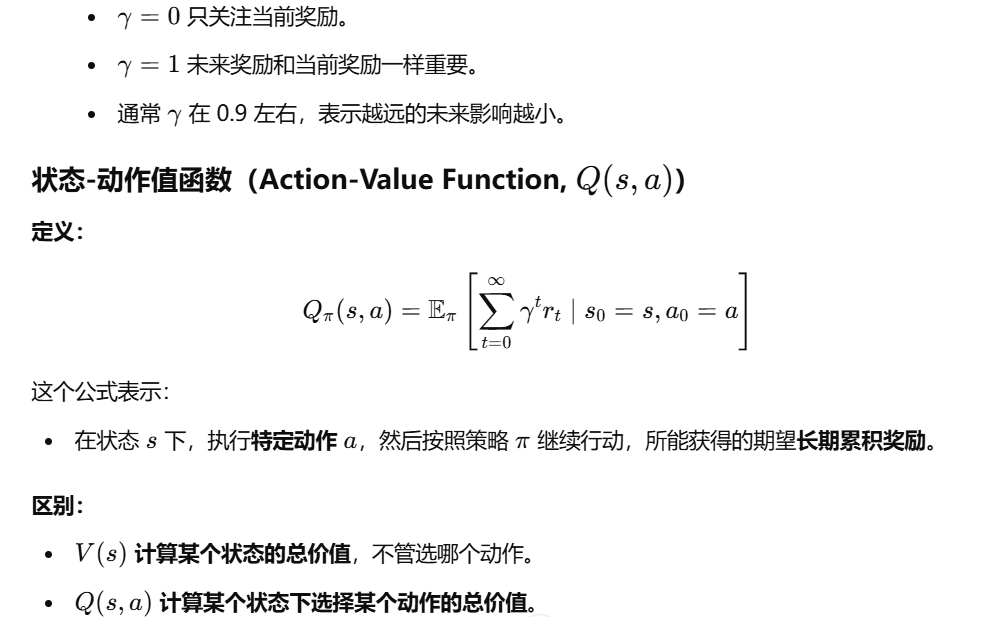
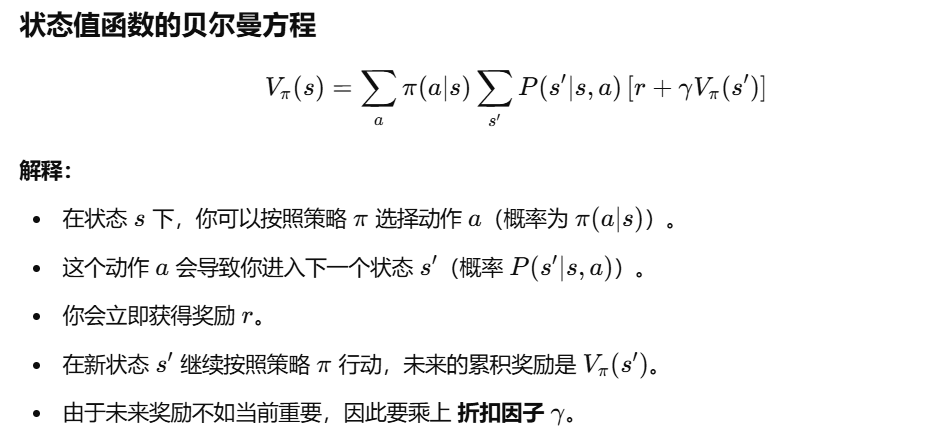
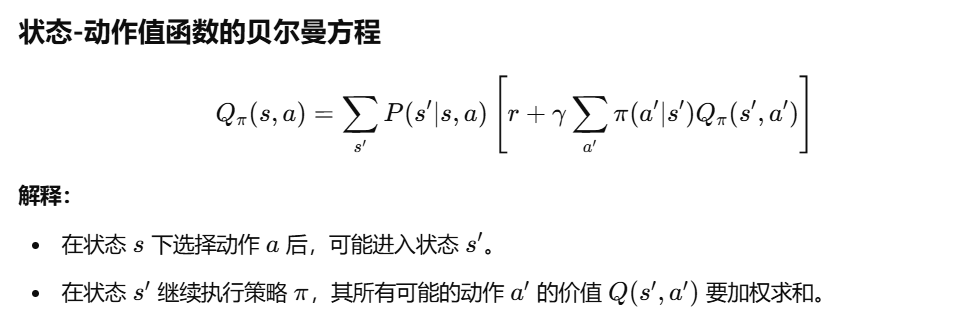
贝尔曼方程(Bellman Equation) 是强化学习的核心概念,它描述了一个状态的价值如何递归地依赖于 当前奖励 和 未来状态的价值。(价值函数的核心公式是贝尔曼方程,它通过递归的方式计算长期收益。)它的核心思想是:当前的价值 = 直接奖励 + 未来可能的价值。贝尔曼方程将价值函数和价值-动作对函数 递归地表示 为:
策略函数
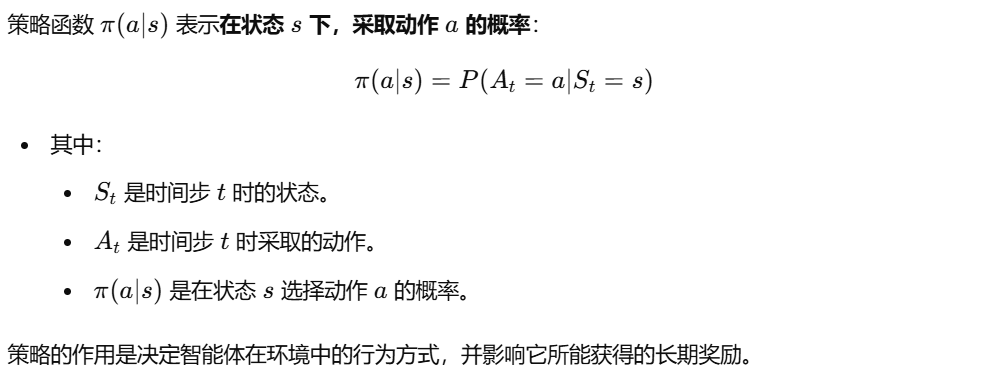
策略函数是智能体(Agent)在某个状态 s 下选择动作 a 的规则。策略函数决定了智能体的行为方式
开源鸿蒙跨平台开发社区汇聚开发者与厂商,共建“一次开发,多端部署”的开源生态,致力于降低跨端开发门槛,推动万物智联创新。
更多推荐
 3
 0
- 0


 已为社区贡献1条内容

所有评论(0)