大模型算法,入职两个月,不想干了
本文分享大模型学习路径与职业规划,建议新人从基础做起,毕业生优先选择互联网企业。详解RAG技术流程、优势与限制,对比RAG与微调适用场景,介绍大模型自定义方式,并提供面试常见问题解答及学习资源获取方式。
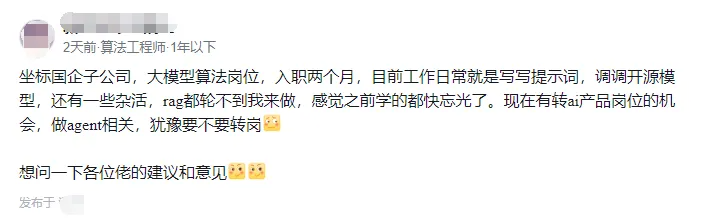
很多同学觉得,我学了这么多AI算法,还学了大模型训练、微调、推理优化,最后入职就是写写Prompt,调调开源模型,干一些杂活儿,就像下面这个同学一样。
不过这里我想说两点:
第一,新人进公司其实 90% 都不会直接让你干模型调优的活,大部分可能还是配环境,搭链路,处理数据。这些都干熟以后,才会让你跑一些模型实验。其中比较出色的同学,才会慢慢让你们接触线上业务。
第二,刚毕业的同学,尽量不要选择国企(家里有矿除外),大模型的岗位,或者说其他 IT 方向的技术岗,在国企都是学不到东西的,这个懂得都懂。国企比较适合在互联网打拼多年之后躺平养老,刚毕业的同学尽量还是去互联网学技术,刷背景,攒能力。上面这个兄弟,刚毕业选择去国企,结果发现学不到东西,算是跳坑里了。
继续来看今天的内容,这段时间我不是在集中招聘嘛,面了很多候选人,清华,北大,华五,包括一些海外的学校都有,所以也准备给大家集中分享一些面试的情况,帮助大家备战秋招。
就拿昨天面的一个复旦女生来说吧,大模型方向,简历还不错,做过 RAG 项目,因此围绕着 RAG 问了一些问题。
01
如何提高大模型的准确性和可靠性并且使回答可验证?
我们可以使用 RAG 来做,通过在生成回答之前,从外部的知识库中检索相关信息来优化输出。
RAG 包括三个步骤:检索、增强和生成。
首先是检索(Retrieval),当用户提出一个查询时,我们会从知识库中检索相关的信息。知识库可以是外部的数据库,也可以是企业内部的专有知识库,这一步可以让我们获取最新最相关的内容。
接下来,我们将检索到的相关信息作为上下文增强(Augmented)到 LLM 中,这一步是关键,因为它为模型提供了生成答案所需的具体背景信息,减少了模型产生错误或虚假信息的风险。
最后我们将增强后的上下文和用户查询一起输入到 LLM 中,模型会基于这些信息生成(Generation)一个适合该上下文的答案。这样生成的答案不仅准确,还可以根据检索到的上下文进行验证。
02
RAG如何解决LLM的局限性?
LLMs 虽然训练在大量数据上,并使用数十亿个参数来生成回答,但有一些局限。
例如当没有答案时,模型可能会生成虚假信息;当用户需要最新、具体的回答时,模型可能会提供过时或通用的信息;以及由于术语混淆导致的错误回答。
RAG 通过引入外部的、相关的知识来增强模型的回答解决了这些问题。例如通过检索最新的数据,我们可以提供最新的回答;通过引用具体的文档,我们可以减少错误和虚假信息,并提供可以验证的回答。
这里你可以边画图边给面试官讲:
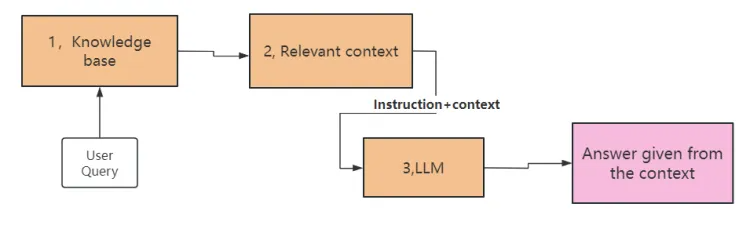
用户提出查询(User Query),然后我们从知识库中检索相关信息,得到相关的上下文,然后将"Instruction + context"输入到大模型中,最后大模型基于此生成答案,这样就确保了回答的准确性和可靠性,并使回答基于具体的上下文,可以进行验证。
03
RAG的工作流程,能画图解释一下吗?
RAG 的过程可以分为三个主要阶段:数据准备,索引,产品上线服务。
我们可以结合这张图来详细解释一下:
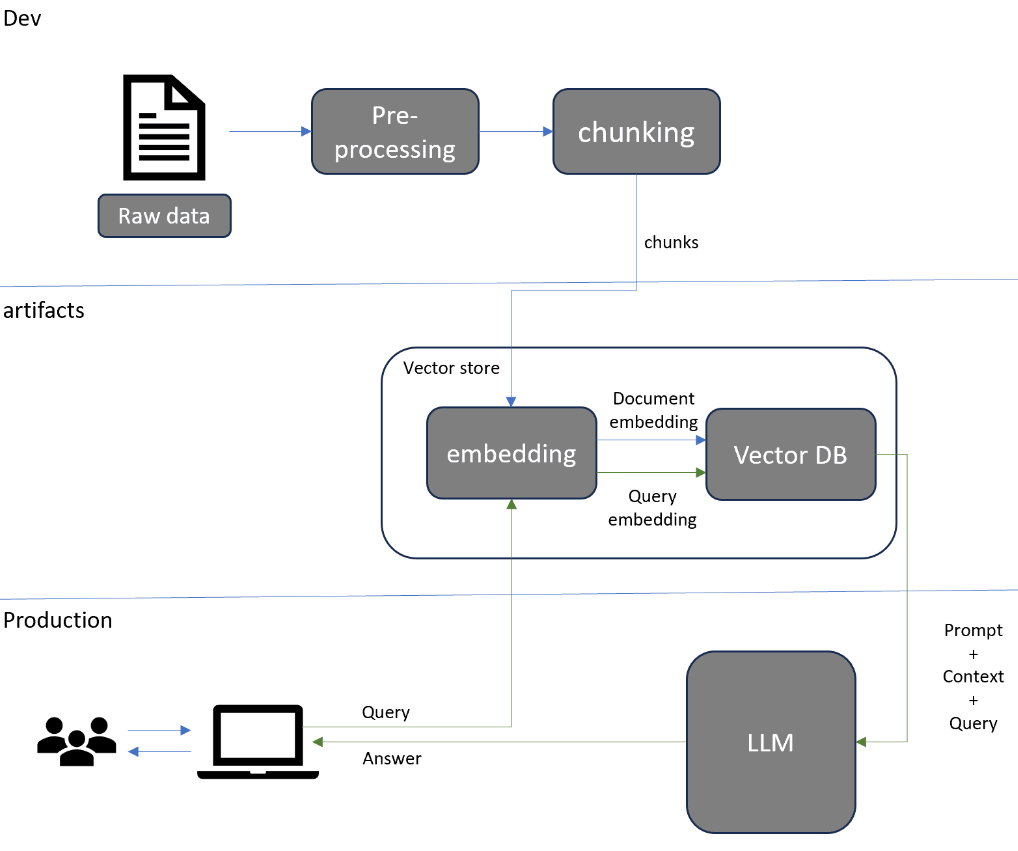
首先是数据准备,这个阶段我们从原始数据开始,对数据进行预处理和分块,将大块的数据或文本,切分成更小更容易管理的"块",方便处理和理解。
大模型应用开发中,分块对于提高从向量数据库中检索到的内容的相关性非常重要,因为我们会用 LLM 来做内容的 embedding。
如上图,我们从"Raw data"(原始数据)开始,经过"Pre-processing"(预处理)和"Chunking"(分块),将数据分成更小的块。
然后是索引阶段,我们会将这些数据块通过 embedding 模型进行嵌入,生成 document embedding。它们会存储在一个向量数据库中。
这个步骤非常关键,因为它决定了后续检索的效率和准确性。看图中的 Embedding 部分,我们将分块的数据进行 embedding,生成的“Document embedding”存储在向量数据库中。
然后是产品上线服务阶段,当我们收到用户的查询时,会对这个查询做 embedding,然后使用 query embedding 来从向量数据库中检索相关的文档或上下文,常用的相似性度量方法包括余弦相似度或欧几里得距离。
检索到的上下文和原始查询会一起输入到大语言模型(LLM)中,模型会生成一个适合该上下文的答案。
用户提出"Query",我们对其进行"Query embedding",并从向量数据库中检索相关的 document embedding。这些检索到的上下文和查询一起作为输入提供给 LLM,生成最终的答案。
总结一下:
- **数据准备:**原始数据开始,经过预处理和分块
- **索引:**将分块数据通过 Embedding 生成“Document embedding,存储在向量数据库中
- **产品上线服务:**当有用户查询时,对查询进行“Query embedding,并使 用query embedding 从向量数据库中检索相关文档。检索到的上下文和查询一起作为输入提供给 LLM,生成最终的答案
04
说一下使用RAG的好处?
第一,可以提供最新且准确的响应,RAG 利用最新的外部数据源,而不仅仅依赖于静态的训练数据。这样即使模型的训练数据已经过时,通过 RAG 我们仍然能够提供最新的信息和回答。
第二,减少模型幻觉,由于 LLM 有时会在没有足够信息的情况下生成虚假或错误的回答,RAG 通过引入相关的外部知识来减少这种风险,降低了出现“幻觉”回答的概率。
第三,提供领域特定的相关回答,RAG 可以让 LLM 利用特定领域的专有数据来生成回答。对于需要访问专有知识库或特定行业数据的应用来说非常有用。
例如医疗领域,RAG 可以帮助模型使用最新的医学研究和病例数据来提供专业的建议和回答。
此外,RAG 相比其他需要重新训练模型的方法成本更低操作更简单,重新训练一个大模型需要大量的资源和时间,而 RAG 只需要更新知识库并检索相关信息即可。
所以 RAG 特别适合那些需要频繁更新数据的场景,如新闻资讯和动态行业数据。
同时你这里也可以给面试官提一些 RAG 的限制和挑战,比如知识检索依赖相似度检索而非精确检索,因此可能出现检索到的文档与问题不太相关。
比如向量数据库技术还不成熟,数据量大时速度和性能存在挑战等等,体现出你的技术广度。
05
如果想用垂域数据自定义大模型,有哪些方式?
incontext learning,通过设计特定提示(零样本和少样本)来引导 LLM 的行为,比如构建聊天机器人。速度快,不需要训练,但是比起微调不太容易控制
RAG,将大模型和外部知识检索结合,比如构建基于专有知识和动态数据集的机器人。
内容可以动态更新,且减少模型幻觉,但是推理成本会增加,并且还需要外部知识库和数据库(比如向量数据库)
微调(Fine-Tuning),将预训练的模型适应到特定数据集或者特定领域,然后根据特定领域的任务,对模型进行调整和优化,微调可以做到精细化控制,但是需要数千条特定领域或任务的指令,计算成本高。
最后是预训练,也就是从头训练 LLM,需要大型数据集(上亿级的 tokens)。
06
RAG和微调的区别?什么时候用微调而不是RAG?
RAG通过整合外部信息来改进语言处理,使模型能够更好理解查询上下文,生成更准确的回复。
而微调的目的则是利用有限的训练数据集,针对特定领域任务,对预先训练好的基础模型进行专门调整。
看下图 RAG 和微调的比较维度可以更加直观,如果我们需要倾向于获取外部知识,RAG 是首选。
另一方面,如果我们正在使用稳定的标记数据,并想要使模型更接近特定需求,则微调是更好的选择。
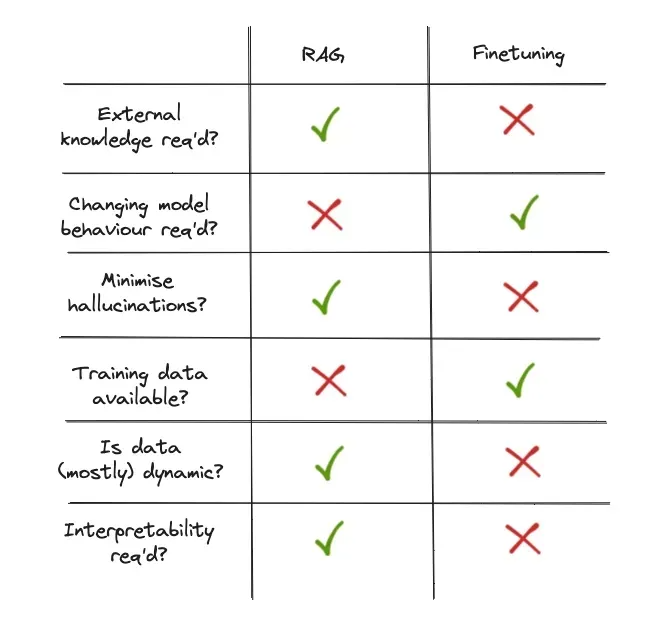
什么时候应该使用微调(Fine-tuning)而不是 RAG?生产中我们通常会先微调模型,再使用 RAG 来提高回答的质量和相关性。
哪些情况需要微调模型呢?
比如业务有特定需求,或者模型需要处理特定领域语言如行业术语/技术术语,或者需要提高模型在特定任务上的性能,或者需要使响应更加符合事实,减少有害内容。这些情况下我们需要微调模型。
总结来说,微调能够更细致地定制模型,使其在特定领域任务上表现更优,而 RAG 提供了一种灵活动态更新的方法,在实际生产中,两者一般会结合使用。
学习专场
“最先掌握AI的人,将会比较晚掌握AI的人有竞争优势”。
这句话,放在计算机、互联网、移动互联网的开局时期,都是一样的道理。
为了帮助大家打破壁垒,快速了解大模型核心技术原理,学习相关大模型技术。从原理出发真正入局大模型。在这里我和MoPaaS魔泊云联合梳理打造了系统大模型学习脉络,这份 LLM大模型资料 分享出来:包括LLM大模型书籍、640套大模型行业报告、LLM大模型学习视频、LLM大模型学习路线、开源大模型学习教程等, 😝有需要的小伙伴,可以 扫描下方二维码免费领取🆓**⬇️⬇️⬇️

【大模型全套视频教程】
教程从当下的市场现状和趋势出发,分析各个岗位人才需求,带你充分了解自身情况,get 到适合自己的 AI 大模型入门学习路线。
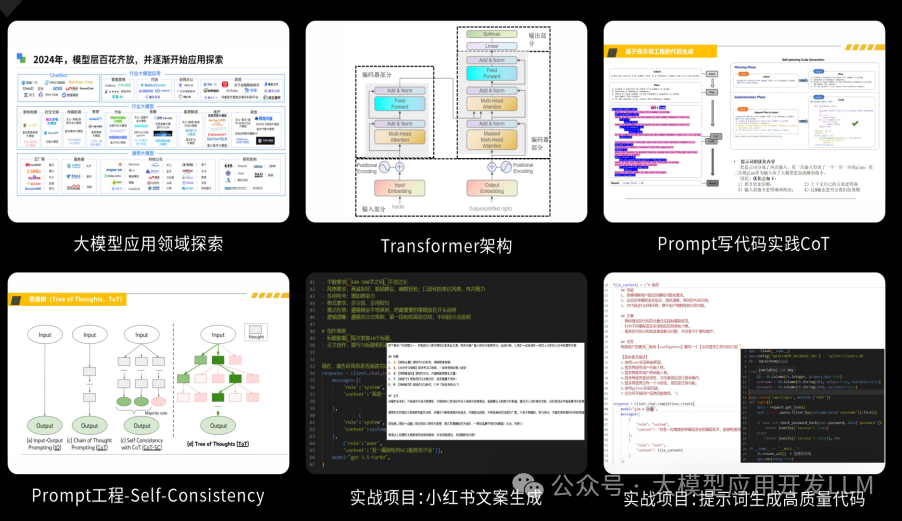
从基础的 prompt 工程入手,逐步深入到 Agents,其中更是详细介绍了 LLM 最重要的编程框架 LangChain。最后把微调与预训练进行了对比介绍与分析。
同时课程详细介绍了AI大模型技能图谱知识树,规划属于你自己的大模型学习路线,并且专门提前收集了大家对大模型常见的疑问,集中解答所有疑惑!
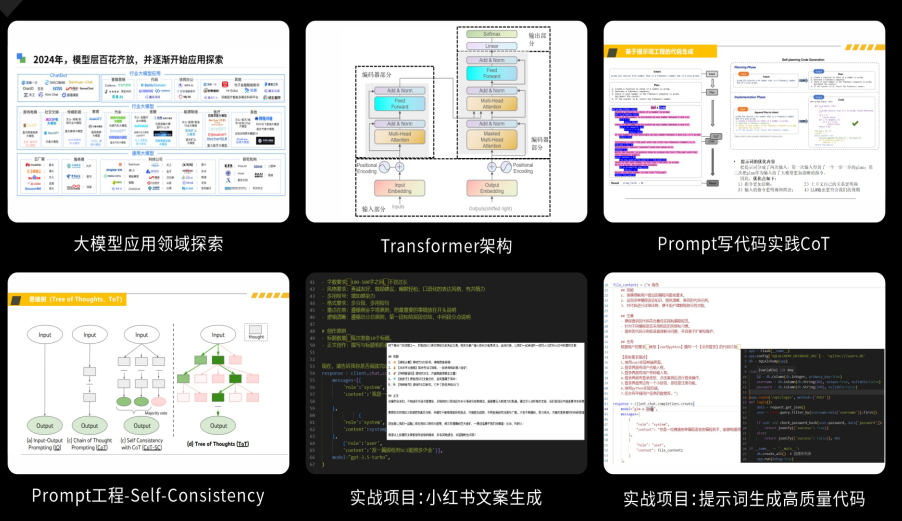
深耕 AI 领域技术专家带你快速入门大模型
跟着行业技术专家免费学习的机会非常难得,相信跟着学习下来能够对大模型有更加深刻的认知和理解,也能真正利用起大模型,从而“弯道超车”,实现职业跃迁!

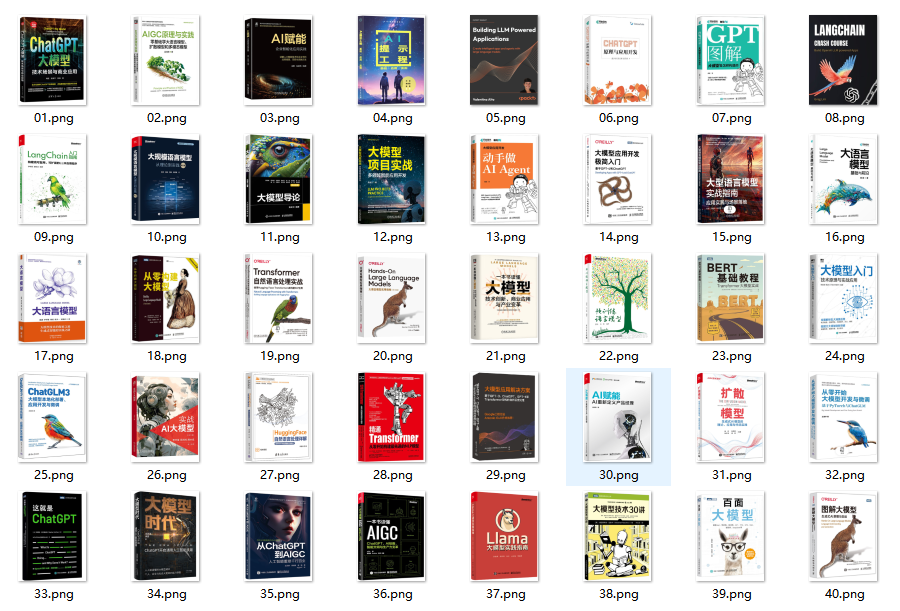
【精选AI大模型权威PDF书籍/教程】
精心筛选的经典与前沿并重的电子书和教程合集,包含《深度学习》等一百多本书籍和讲义精要等材料。绝对是深入理解理论、夯实基础的不二之选。
【AI 大模型面试题 】
除了 AI 入门课程,我还给大家准备了非常全面的**「AI 大模型面试题」,**包括字节、腾讯等一线大厂的 AI 岗面经分享、LLMs、Transformer、RAG 面试真题等,帮你在面试大模型工作中更快一步。
【大厂 AI 岗位面经分享(92份)】
【AI 大模型面试真题(102 道)】
【LLMs 面试真题(97 道)】
【640套 AI 大模型行业研究报告】
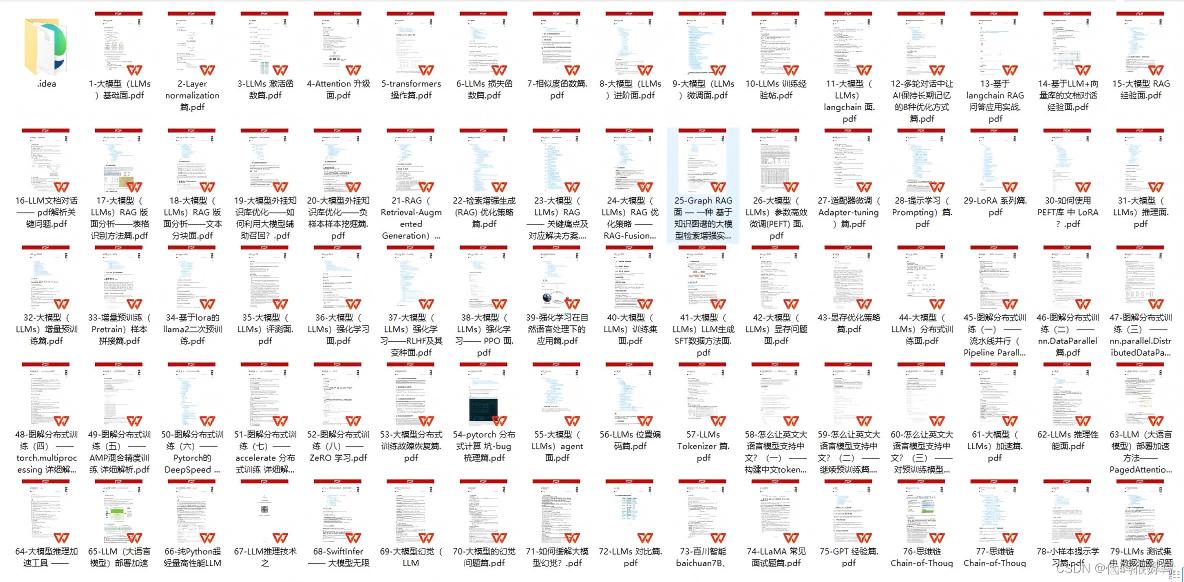
【AI大模型完整版学习路线图(2025版)】
明确学习方向,2025年 AI 要学什么,这一张图就够了!
👇👇点击下方卡片链接免费领取全部内容👇👇
抓住AI浪潮,重塑职业未来!
科技行业正处于深刻变革之中。英特尔等巨头近期进行结构性调整,缩减部分传统岗位,同时AI相关技术岗位(尤其是大模型方向)需求激增,已成为不争的事实。具备相关技能的人才在就业市场上正变得炙手可热。
行业趋势洞察:
- 转型加速: 传统IT岗位面临转型压力,拥抱AI技术成为关键。
- 人才争夺战: 拥有3-5年经验、扎实AI技术功底和真实项目经验的工程师,在头部大厂及明星AI企业中的薪资竞争力显著提升(部分核心岗位可达较高水平)。
- 门槛提高: “具备AI项目实操经验”正迅速成为简历筛选的重要标准,预计未来1-2年将成为普遍门槛。
与其观望,不如行动!
面对变革,主动学习、提升技能才是应对之道。掌握AI大模型核心原理、主流应用技术与项目实战经验,是抓住时代机遇、实现职业跃迁的关键一步。
01 为什么分享这份学习资料?
当前,我国在AI大模型领域的高质量人才供给仍显不足,行业亟需更多有志于此的专业力量加入。
因此,我们决定将这份精心整理的AI大模型学习资料,无偿分享给每一位真心渴望进入这个领域、愿意投入学习的伙伴!
我们希望能为你的学习之路提供一份助力。如果在学习过程中遇到技术问题,也欢迎交流探讨,我们乐于分享所知。
*02 这份资料的价值在哪里?*
专业背书,系统构建:
-
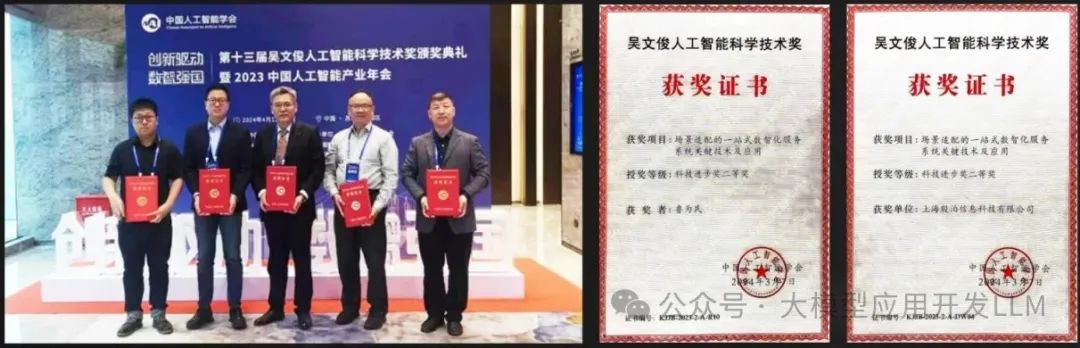
本资料由我与MoPaaS魔泊云的鲁为民博士共同整理。鲁博士拥有清华大学学士和美国加州理工学院博士学位,在人工智能领域造诣深厚:
-
- 在IEEE Transactions等顶级学术期刊及国际会议发表论文超过50篇。
- 拥有多项中美发明专利。
- 荣获吴文俊人工智能科学技术奖(中国人工智能领域重要奖项)。
-
目前,我有幸与鲁博士共同进行人工智能相关研究。
内容实用,循序渐进:
-
资料体系化覆盖了从基础概念入门到核心技术进阶的知识点。
-
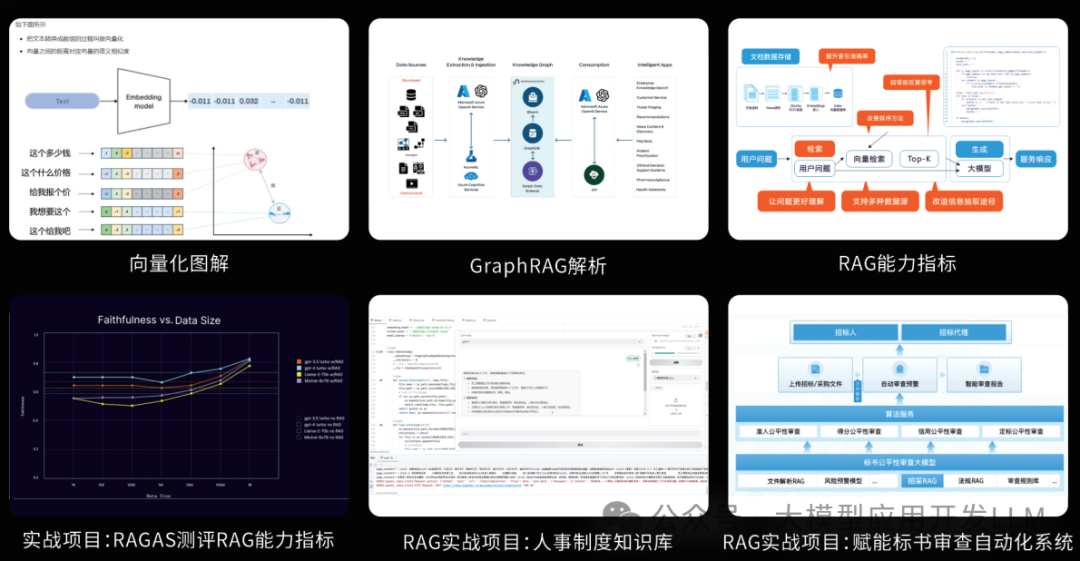
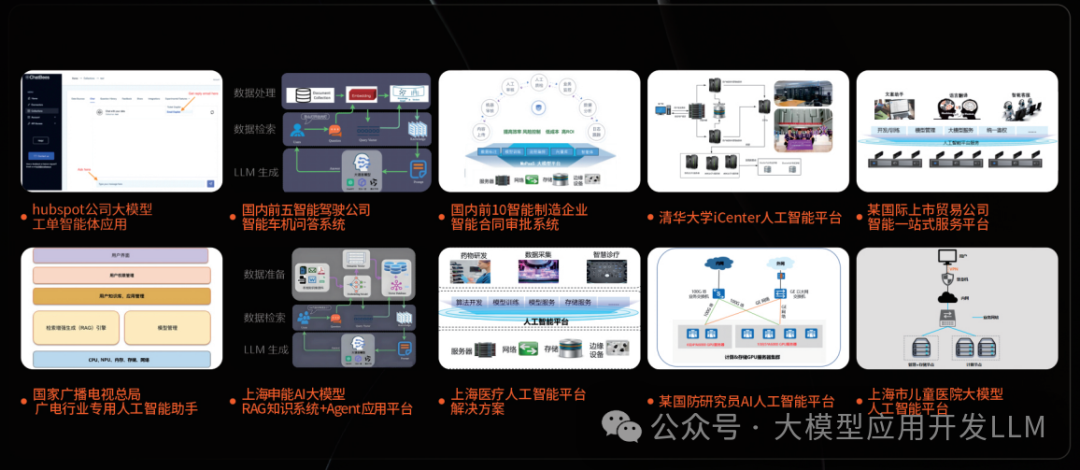
包含丰富的视频教程与实战项目案例,强调动手实践能力。
-
无论你是初探AI领域的新手,还是已有一定技术基础希望深入大模型的学习者,这份资料都能为你提供系统性的学习路径和宝贵的实践参考,助力你提升技术能力,向大模型相关岗位转型发展。
抓住机遇,开启你的AI学习之旅!

开源鸿蒙跨平台开发社区汇聚开发者与厂商,共建“一次开发,多端部署”的开源生态,致力于降低跨端开发门槛,推动万物智联创新。
更多推荐
 24
 0
- 0


 已为社区贡献3条内容

所有评论(0)