React Native for OpenHarmony 实战:三方库 react-native-base64 的鸿蒙化适配指南
前面讲的都是"库里有原生代码、需要把 iOS/Android 实现换成鸿蒙实现"。但社区里大量的 RN 三方库其实一行原生代码都没有——纯 JavaScript,跨平台全靠同一份 JS。
react-native-base64 就是这类库:它只有 112 行 JS,做 Base64 编解码。它不需要鸿蒙化适配。
但"不需要适配"是一个需要证明的结论,不是一个可以随口下的判断。本文要讲三件事:
- 怎么判断一个 RN 库要不要鸿蒙化(三步法,可复用);
- 怎么证明它真的不需要(与上游逐字节比对 + 零接线实测);
- “不需要适配"不等于"不需要验证”——实测这个库有 4 类行为边界,其中 3 类连它自己的 README 都没覆盖到或说得偏轻。
环境准备:本文不重复环境搭建步骤。RNOH(React Native for OpenHarmony)开发环境的完整配置见官方开发者指南:
https://atomgit.com/CPF-RN/docs/blob/main/开发者指南/02-搭建准备/环境初始化.md
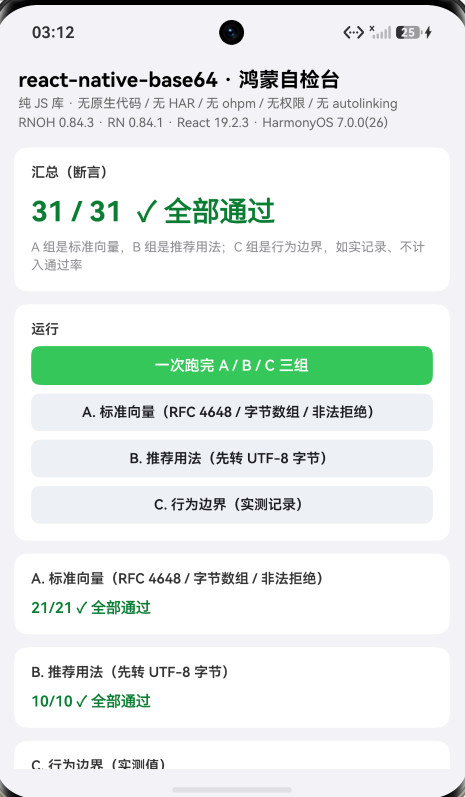
一、先说结论:这个库不需要适配
判定依据(每条都实测过):
| 判定项 | 结果 |
|---|---|
有没有 harmony/ 目录 | ❌ 没有 |
| 有没有原生代码(C++ / ArkTS / HAR) | ❌ 没有 |
有没有平台分支(Platform.OS 判断) | ❌ 没有 |
| 有没有原生依赖 | ❌ 没有(npm view react-native-base64 dependencies 为空) |
有没有 harmony.autolinking 声明 | ❌ 没有(package.json 里连 harmony 字段都没有) |
| 结论 | ✅ 纯 JS 库,直接可用 |
所以本文没有"六步适配步骤"那一节——因为没有适配可做。取而代之的是"判定过程"和"验证方法"。
二、判定过程:三步判断一个 RN 库要不要鸿蒙化
这个方法在选库阶段就能用,不用先装进来:
第一步:看 package.json 有没有 harmony 字段
npm view <包名> harmony --json
有 harmony.autolinking(那四个身份名)的,一定是带原生实现的适配包,必须走 link-harmony + ohpm + hvigor。
react-native-base64 的情况:
$ npm view react-native-base64 main dependencies --json
"base64.js"          # main 指向一个 JS 文件,且 dependencies 为空
第二步:看仓库里有没有 harmony/
$ git clone https://atomgit.com/oh-react-native/react-native-base64.git
$ ls react-native-base64
base64.js  package.json  LICENSE
README.OpenHarmony.md  README.OpenHarmony_CN.md
spec.json  __tests__/
没有 harmony/、没有 src/ —— 全部实现就是根目录那一个 base64.js。
第三步:读代码里有没有平台分支或原生调用
搜三个关键词就够了:
NativeModules/TurboModuleRegistry—— 有的话在调原生Platform.OS—— 有的话在按平台分叉行为requireNativeComponent—— 有的话是原生视图
base64.js 里一个都没有,就是纯字符串处理。
一个容易误判的点:
node_modules里出现android/或ios/目录,不代表"有原生实现"。很多库把平台工程放在包里但实际不参与 RN 运行;判断要看有没有被 JS 侧真实调用(第一步的harmony.autolinking是最可靠的信号)。
三、这个交付包长什么样
react-native-base64/
├── base64.js                    # 上游纯 JS 实现(★ 与 npm 上游逐字节一致)
├── package.json                 # main 指向 base64.js,无依赖
├── spec.json                    # 机器可读规格
├── README.OpenHarmony.md        # 双语说明
├── README.OpenHarmony_CN.md
├── RN_react-native-base64+代码检查报告.md
└── __tests__/base64.test.cjs    # 契约测试(node --test)
spec.json 里把性质写得很明确:
{
  "implementation": "pure JavaScript; no native module or HAR required",
  "upstream": "https://github.com/eranbo/react-native-base64",
  "upstreamCommit": "c2a2c952bfb9e458c7db2c8548a75de3be5e8e3c"
}
既然不需要适配,为什么还要建这个仓库? 我认为有三个实际价值:
- 可寻址:OpenHarmony 社区有统一的组织(
oh-react-native)可以找到"这个库在鸿蒙上能不能用、验证到什么程度",不用每个人自己去翻上游源码判断; - 可追溯:
spec.json锁死了上游 commit,说明"我验的是哪一版"; - 有验证记录:契约测试 + 真机场景 + 结论,比"我用过,没问题"有用得多。
但它不是改造仓库——这一点下一节会证明。
四、接入宿主:零接线
对照前面几个"需要适配"的库,这个库少了一整排接线动作:
| 接线项 | 需要适配的库(带 harmony/) | react-native-base64 |
|---|---|---|
npm install + package.json 加依赖 | 需要 | 需要(这个躲不掉) |
react-native link-harmony | 需要 | 不需要 |
工程级 harmony/oh-package.json5 加 HAR | 需要 | 不需要 |
模块级 harmony/entry/oh-package.json5 加 HAR | 需要 | 不需要 |
harmony/entry/src/main/ets/RNOHPackagesFactory.ets 注册 Package | 需要 | 不需要 |
ohos.permission.* 权限声明 | 视库而定 | 不需要 |
metro.config.js 的 watchFolders | 需要 | 本次需要一行(原因见下) |
实测一:link-harmony 确实跳过了它
$ node_modules\.bin\react-native link-harmony --verbose
[link] expo-system-ui
[link] expo-video-thumbnails
[link] react-native-aes-crypto
[skip] @react-native-oh/react-native-harmony

info updated 4 file(s), linked 5 libraries, skipped 1 libraries
linked 5 libraries——和加入 base64 之前一模一样,react-native-base64 不在列表里。
实测二:Metro 的重定向清单里也没有它
[INFO] Redirected imports to 5 harmony-specific third-party package(s):
[INFO] • expo-keep-awake → expo-keep-awake
[INFO] • expo-localization → expo-localization
[INFO] • expo-system-ui → expo-system-ui
[INFO] • expo-video-thumbnails → expo-video-thumbnails
[INFO] • react-native-aes-crypto → react-native-aes-crypto
注意:这里"不在清单里"才是对的。
前面几篇我一直把这个清单当 autolinking 的自检信号——“清单里没有你的库,就说明没认出来”。对纯 JS 库这个信号要反过来读:Metro 的重定向是给"有鸿蒙变体"的包准备的(把 expo-xxx 解析到它的鸿蒙实现),纯 JS 库没有鸿蒙变体可重定向,出现在清单里反而说明有问题。
实测三:模块级 oh-package.json5 一个字没动
// harmony/entry/oh-package.json5 —— 没有 base64 的条目,构建照样成功
"dependencies": {
  "@rnoh/react-native-openharmony": "file:...",
  "@react-native-ohos/expo-keep-awake": "file:...",
  "@react-native-ohos/expo-localization": "file:...",
  "@react-native-ohos/expo-system-ui": "file:...",
  "@react-native-ohos/expo-video-thumbnails": "file:...",
  "@react-native-ohos/react-native-aes-crypto": "file:...",
}
唯一需要的一行,以及它为什么可以省
// metro.config.js
watchFolders: [
  ...
  path.resolve(__dirname, '../react-native-base64'),
],
这一行不是鸿蒙适配,而是 file: 本地依赖的通病:file: 装进 node_modules 之后是链接(Windows 上是 Junction),metro 需要一个 watchFolders 条目才认得出它的真实目录。
如果从 npm registry 装(npm install react-native-base64@0.2.2,装成真目录),连这一行都不需要——真正的"零接线"。
代价:几乎没有
| 上一个库(aes-crypto,带向量 JSON) | 本库(base64,纯 JS) | |
|---|---|---|
| HAP 增量 | 约 +259 KB | 约 +20 KB |
assembleHap | 6 分 38 秒 | 6 分 30 秒 |
纯 JS 库的接入成本几乎为零——这也是为什么"先判断要不要适配"很值:判断对了,能省掉整套原生接线和一个 30–40 分钟的首次编译。
五、验证方法:证明"真的不需要适配"
“我看了一遍代码,没有原生调用”——这不够。我用两条独立证据来说明:
证据一:交付的 JS 与 npm 上游逐字节一致
$ npm pack react-native-base64@0.2.2       # tarball 2374 字节
$ tar -xzf react-native-base64-0.2.2.tgz

适配仓库 base64.js  SHA256 = 6FE367A7EB5C3BA30EB5B9E32CB2B26EFDF1C48B006A925722CE4B9591F63063
npm 上游 base64.js  SHA256 = 6FE367A7EB5C3BA30EB5B9E32CB2B26EFDF1C48B006A925722CE4B9591F63063
==> 完全一致
哈希对上了,就说明适配仓库一行平台代码都没加——“不需要适配"从"我的判断"变成了"可核对的事实”。
顺带一个实用推论:既然字节一致,npm install react-native-base64@0.2.2 装出来的行为和这个交付仓库完全相同。
证据二:设备侧行为与 PC 端(Node)完全一致
既然是纯 JS、逻辑里没有平台分支,那它在鸿蒙的 JS 引擎上就应该和在 Node 上跑一样。我把同一份代码在两端都跑了一遍:
| 输入 | 设备侧(RNOH/Hermes) | PC 端(Node) | 一致 |
|---|---|---|---|
encode('') | "AA==" | "AA==" | ✅ |
encode('鸿蒙') | "k=" | "k=" | ✅ |
decode('====') | "Ą" | "Ą" | ✅ |
| …(全部 8 条边界) | ✅ |
两端一字不差。这既证明"无需适配"(没有平台差异要处理),也顺带证明:下面那些行为边界是上游实现的问题,跟鸿蒙无关。
这一点很重要:如果两端不一致,那就要怀疑"是不是 JS 引擎有差异";两端一致,问题就锁定在库自己身上。
六、真机验证:31/31 通过,但更要看 C 组
验证环境:Pura X View 模拟器,HarmonyOS 7.0.0(26.0.0) Beta2,API 26,ohos-x64。
测试页分三组,刻意把"标准向量"和"行为边界"分开:
[base64-test] A. 标准向量(RFC 4648 / 字节数组 / 非法拒绝) -> 21/21 全部通过
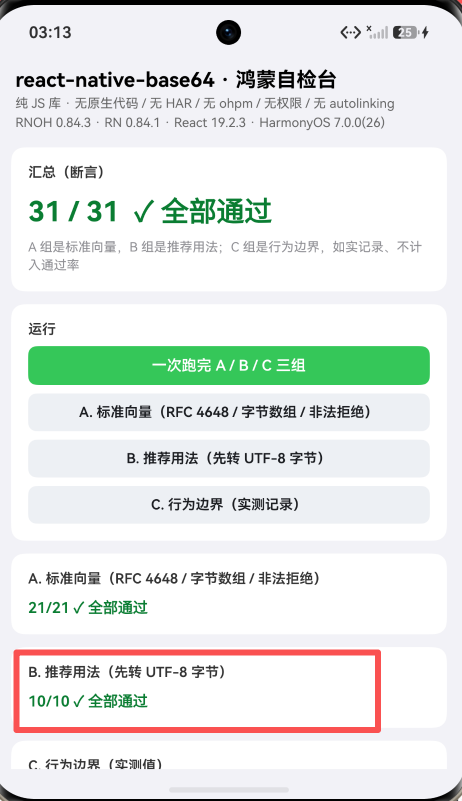
[base64-test] B. 推荐用法(先转 UTF-8 字节) -> 10/10 全部通过
[base64-test] 边界|encode('') = "AA==" (标准期望 "")
[base64-test] 边界|encodeFromByteArray([]) = "AA==" (标准期望 "")
[base64-test] 边界|decode('') = "\0\0\0" (长度 3,标准期望 "")
[base64-test] 边界|encode("鸿蒙") = "k=" 往返不一致(数据丢失) (标准 UTF-8 应为 6bi/6JKZ)
[base64-test] 边界|encode("🔒") = "I=" 往返不一致(数据丢失) (标准 UTF-8 应为 8J+Ukg==)
[base64-test] 边界|encode("a鸿b") = "Y9i" 往返不一致(数据丢失) (标准 UTF-8 应为 Yem4v2I=)
[base64-test] 边界|encode('café') = "Y2Fm6Q==" 往返一致 (说明并非所有非 ASCII 都坏)
[base64-test] 边界|decode('====') = "Ą" (非法填充未拒绝,标准应拒绝)
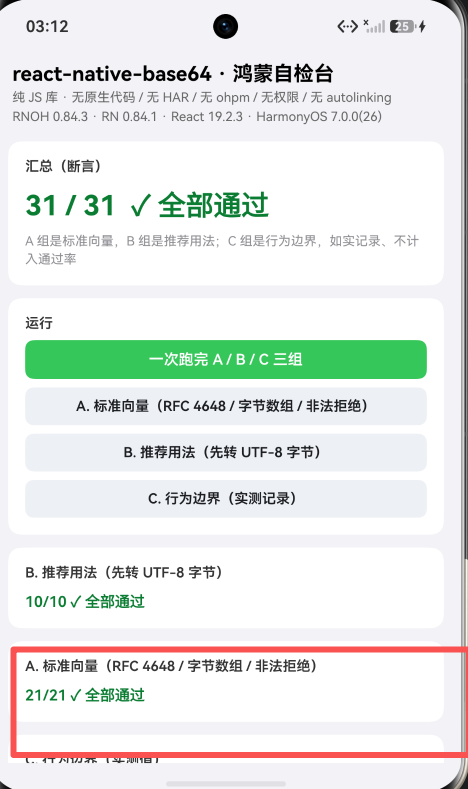
A 组(21 项)——RFC 4648 §10 的 Base64 标准向量(f/fo/foo/foob/fooba/foobar,编码 + 解码双向)、字节数组编码、非法字符拒绝,全部对上。
B 组(10 项)——推荐用法:非 ASCII 先转 UTF-8 字节再编码,以及与标准 UTF-8 Base64 的一致性。
C 组(8 条)——不作为通过条件,而是把实测值原样展示出来。
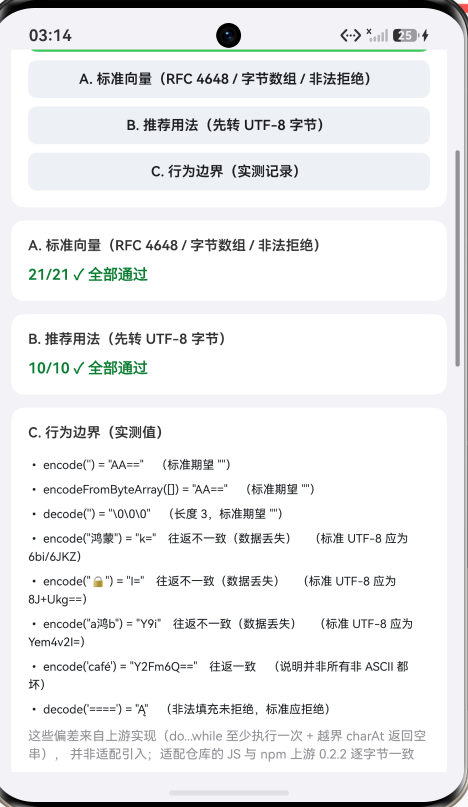
为什么 C 组不算"通过"? 因为如果把已知偏差也塞进"通过"里,就等于把问题藏起来了。验证的目的是发现真相,不是攒一个好看的数字。
七、实测发现:四条行为边界
下面这些都是上游实现的问题(两端行为一致已经证明了),但作为交付方,我认为必须写清楚——因为其中 3 条 README 没覆盖或说得偏轻。
边界一:空串的 encode / decode 都不对
| 调用 | 实测结果 | 标准期望 |
|---|---|---|
base64.encode('') | "AA==" | "" |
base64.encodeFromByteArray([]) | "AA==" | "" |
base64.decode('') | "\0\0\0"(长度 3) | "" |
根因:三个方法都用了 do { … } while (i < input.length) —— do...while 至少会执行一次循环体。空输入时:
// encode('') 的第一次(也是唯一一次)循环:
chr1 = ''.charCodeAt(0);          // NaN
enc1 = NaN >> 2;                  // 0
enc2 = ((NaN & 3) << 4) | (NaN >> 4);   // 0
if (isNaN(chr2)) { enc3 = enc4 = 64; }  // 成立
// keyStr.charAt(0)+charAt(0)+charAt(64)+charAt(64) = "A" + "A" + "=" + "="
// → 返回 "AA=="
decode('') 同理:keyStr.indexOf(''.charAt(0)) 也就是 indexOf('') 返回 0,四个 enc 全 0,而 enc3 != 64、enc4 != 64 都成立,于是输出三个 String.fromCharCode(0)。
这条为什么重要:空串在真实业务里很常见(用户没输入、字段为空)。encode('') 返回 "AA==" 意味着空内容会被编码成一个"看起来正常"的非空 Base64,传到下游很难排查。
边界二:非 ASCII 不是"编码不同",而是丢数据
| 输入 | 实测 encode | 往返 | 标准 UTF-8 Base64 |
|---|---|---|---|
"鸿蒙" | "k=" | ❌ 不一致(数据丢失) | 6bi/6JKZ |
"🔒" | "I=" | ❌ 不一致(数据丢失) | 8J+Ukg== |
"a鸿b" | "Y9i" | ❌ 不一致(数据丢失) | Yem4v2I= |
"café" | "Y2Fm6Q==" | ✅ 一致 | Y2Fmw6k= |
根因:实现按 charCodeAt 取 UTF-16 码元(不是 UTF-8 字节)。当码元值超出 keyStr 的索引范围(0–64)时:
keyStr.charAt(enc1) // enc1 = 40511 >> 2 = 10127 → 越界 → 返回空字符串 ''
数据被静默丢弃,输出还依然是个"合法 Base64 形状"的字符串。
最危险的一点是"有时对有时错":"café" 恰好往返一致(é 的码元 0xE9 落在能处理的范围内),而 "鸿蒙"、"🔒"、"a鸿b" 全部丢失。用小范围样本测试很容易漏过去——这也解释了为什么这个边界容易被忽略。
适配仓库 README 的措辞是"部分 Unicode 字符不能按 UTF-8 字节语义直接转换"。这低估了严重性:它不是"换个字节语义"的问题,而是输出丢数据、往返不一致。做交付时这种措辞应该更明确,比如直接写"非 ASCII 字符串会丢失数据,必须改走字节接口"。
边界三:畸形的填充 = 不被拒绝
base64.decode('====') -> "Ą" (U+0104,长度 1)
根因:校验正则 /[^A-Za-z0-9\+\/\=]/ 把 = 当成了合法字符;随后 keyStr.indexOf('=') 返回 64,于是:
chr1 = (64 << 2) | (64 >> 4)   // 256 | 4 = 260
String.fromCharCode(260)       // "Ą"
非字母表字符确实会抛异常(实测 bad?value / a b / 中文 / Zm9v\n 四种都抛了),但畸形的填充不属于"非法字符",会被静默接受并产出垃圾。README 说"非法 Base64 字符会抛出异常"——这句话本身没错,但会让人以为"输入格式错误一定会被拦下",实际不是。
边界四:decode 返回的是"每字符一字节",不是真正的字符串
decode 内部用 String.fromCharCode(chr) 输出,所以返回的字符串里每个字符的码点就是一个字节(0–255)。对于 ASCII 这没区别;对二进制数据,拿到的是"伪字符串",要继续用就得再按字节还原:
function bytesFromDecoded(decoded: string): Uint8Array {
  const out: number[] = [];
  for (const ch of decoded) out.push(ch.charCodeAt(0) & 0xff);
  return Uint8Array.from(out);
}
这不是缺陷(上游 API 就是这样设计的),但用之前要知道。
八、正确用法:先转 UTF-8 字节
结论很简单:encode / decode 只能用于 ASCII。非 ASCII 必须走字节接口。
import base64 from 'react-native-base64';

// 编码:字符串 → UTF-8 字节 → encodeFromByteArray
const encoded = base64.encodeFromByteArray(toUtf8Bytes('鸿蒙'));   // "6bi/6JKZ",与标准一致

// 解码:decode → 每字符一字节 → 按 UTF-8 还原
const text = fromUtf8Bytes(bytesFromDecoded(base64.decode(encoded)));  // "鸿蒙"
实测 5 组(鸿蒙 / café / 🔒 / a鸿b / Hello 鸿蒙)的编码与解码全部与标准 UTF-8 Base64 一致。
toUtf8Bytes / fromUtf8Bytes 用纯 JS 写就行(别依赖 TextEncoder,RN/Hermes 不保证有全局 TextEncoder):
function toUtf8Bytes(text: string): Uint8Array {
  const out: number[] = [];
  for (const ch of text) {
    const cp = ch.codePointAt(0) ?? 0;
    if (cp < 0x80) out.push(cp);
    else if (cp < 0x800) out.push(0xc0 | (cp >> 6), 0x80 | (cp & 0x3f));
    else if (cp < 0x10000) out.push(0xe0 | (cp >> 12), 0x80 | ((cp >> 6) & 0x3f), 0x80 | (cp & 0x3f));
    else out.push(0xf0 | (cp >> 18), 0x80 | ((cp >> 12) & 0x3f), 0x80 | ((cp >> 6) & 0x3f), 0x80 | (cp & 0x3f));
  }
  return Uint8Array.from(out);
}
空串要调用方自己兜底:
const encode = (s: string) => (s.length === 0 ? '' : base64.encode(s));
const decode = (s: string) => (s.length === 0 ? '' : base64.decode(s));
更省事的做法是换掉它。 如果项目里只是要标准的 Base64,用 js-base64 这类维护活跃、语义正确的库更直接。这个交付仓库的价值是"上游原样 + 已验证可用性边界",不是"推荐优先选它"。我把边界写这么细,正是为了让读者能自己判断该不该用。
九、已知限制
一、encode / decode 不适用于非 ASCII。 会丢数据且往返不一致(边界二)。必须改走 encodeFromByteArray + 自己转 UTF-8 字节。
二、空串 / 空数组行为不正确。 encode('') 与 encodeFromByteArray([]) 返回 "AA==",decode('') 返回 "\0\0\0"(边界一)。需要调用方兜底。
三、畸形填充不被拒绝。 decode('====') 返回 "Ą" 而不是抛错(边界三)。不能依赖这个库做"输入合法性"的第一道防线。
四、没有标准的 Unicode 支持。 这是上游的设计边界——它的定位是"ASCII / 单字节字符串的 Base64",不是完整的 UTF-8 编解码器。
五、本次只验证了三个公开方法。 上游也只有这三个(encode / encodeFromByteArray / decode)。
六、大字符串的吞吐与性能未测。 纯 JS 实现对小字符串没问题,长字符串的性能未做基准测试。
七、其他 ROM / 真机未验证。 本次在 HarmonyOS 7.0.0(26.0.0) Beta2 模拟器上通过;适配方记录的是 OpenHarmony-7.0.0.105。
八、没有修改库代码。 上述行为边界属上游实现,按任务边界只做记录与用法建议。
十、常见问题
Q:这个库为什么不用适配?
A:它是纯 JavaScript 实现——没有 harmony/、没有原生代码、没有平台分支、没有原生依赖。RN 的 JS 代码在 RNOH 上跑的是同一个 JS 引擎(Hermes),不需要"把 iOS/Android 实现换成鸿蒙实现"这一步。实测设备侧行为与 Node 端完全一致。
Q:那我怎么知道别的库要不要适配?
A:三步:① npm view <包名> harmony --json 看有没有 harmony.autolinking;② 仓库里有没有 harmony/;③ 代码里有没有 NativeModules / Platform.OS / requireNativeComponent。第一条最可靠。
Q:既然不需要适配,为什么还有这个仓库?
A:它是交付与验证仓库,不是改造仓库。价值在于"可寻址 + 可追溯 + 有验证记录":社区能查到"这个库在鸿蒙上能不能用、验到什么程度",spec.json 锁死了上游 commit。它的 base64.js 与 npm 上游 SHA256 完全一致,一行平台代码都没加。
Q:我 npm install react-native-base64 装的是这个仓库的版本吗?
A:npm 上的同名包是上游包,但因为交付仓库的 JS 与上游逐字节一致,行为完全相同。从 npm 装反而更省事(真目录,连 metro.config.js 的 watchFolders 都不用加)。
Q:为什么我 encode('') 得到 "AA=="?
A:上游实现的 do...while 循环至少会执行一次,空输入时 charCodeAt 返回 NaN,位运算后落到索引 0 和填充位 64,拼出 "AA=="。这是上游问题,不是鸿蒙问题——Node 端跑同样的代码结果一样。调用方自己兜底空串。
Q:为什么我 encode('鸿蒙') 得到 "k=",而且解不回来?
A:因为它按 UTF-16 码元处理,码元值超出 keyStr 索引范围时 charAt 返回空串,数据被静默丢弃。正确做法是先转 UTF-8 字节再 encodeFromByteArray。注意 'café' 这种恰好能往返——别用小样本判断"支持不支持 Unicode"。
Q:decode('====') 为什么不报错?
A:校验正则把 = 当成合法字符,所以畸形填充绕过了检查,indexOf('=') = 64 参与位运算后产出 "Ą"。别把这个库当作输入校验的手段。
Q:decode 出来的字符串怎么再变成字节?
A:它返回的是"每字符一字节"的 JS 字符串,for (const ch of s) bytes.push(ch.charCodeAt(0) & 0xff) 即可还原成 Uint8Array。
Q:为什么我在 metro.config.js 里加了 watchFolders 却没有在别的库那里加?
A:这一行不是鸿蒙适配,是 file: 本地依赖的通病——file: 装进 node_modules 是链接(Junction),metro 需要 watchFolders 才认真实目录。从 npm registry 装成真目录就不需要这一行。
Q:怎么确认纯 JS 库"真的没被 autolinking 接管"?
A:看 link-harmony 的输出——linked N libraries 的 N 不应该因为它增加;以及 Metro 的 Redirected imports to N ... 清单里不应该出现它。注意这个信号和带原生实现的库是反的:那些库"不在清单里"是坏事,纯 JS 库"不在清单里"是好事。
小结
这篇的结论和前面几篇不一样,收获也不一样:
- "不需要适配"是一个需要证明的结论。 我不满足于"看了一下没有原生调用",而是用两条独立证据把它钉死:① 交付的
base64.js与 npm 上游SHA256 完全一致(一行平台代码都没加);② 设备侧与 PC 端(Node)行为逐字节一致(没有平台差异要处理)。第二条还顺带把"行为边界是上游问题还是鸿蒙问题"这件事一并锁定了。 - “不需要适配"不等于"不需要验证”。 恰恰因为纯 JS 库"看起来一定能用",最容易跳过验证——而这个库实测有 4 类行为边界,其中 3 类连它自己的 README 都没覆盖到:空串会编码成
"AA=="、非 ASCII 会丢数据、畸形填充不被拒绝。"能跑"和"用对"是两件事。 - 判断对了能省很多。 一个纯 JS 库的接入成本是"加一行依赖"(+20 KB HAP、6 分 30 秒编译);一个带原生实现的库是"三处接线 + 一个 30–40 分钟的首次编译"。选库阶段花五分钟做判断,比装进来再发现要适配划算得多。
- 交付措辞要够准。 README 写"部分 Unicode 字符不能按 UTF-8 字节语义直接转换",字面没错,但读者会低估成"结果是另一种编码"。实际是丢数据、往返不一致。做技术交付时,把边界说到位比说得委婉重要。
最后一条关于验证心态:这次我刻意把"C 组行为边界"排除在通过率之外,而不是把它们算进"31/31"。因为把已知偏差塞进"通过"里,就只是把问题藏起来——验证的目的是发现真相,不是攒一个好看的数字。这个习惯在密码学那篇(rn-05)能给出 159/159 的硬结论,在这个库则能给出"31/31 通过,但有 4 条必须知道的边界"这样的完整结论。
本篇用到的库
| 项 | 内容 |
|---|---|
| 三方库 | react-native-base64(上游 0.2.2,纯 JS 实现) |
| 交付仓库 | https://atomgit.com/oh-react-native/react-native-base64 |
| 适配 TAG | 0.2.2-ohos-1.0.0 |
| 是否需要 HAR / ohpm / autolinking | 都不需要 |
| 上游仓库 | https://github.com/eranbo/react-native-base64 |
| 基线 commit | c2a2c952bfb9e458c7db2c8548a75de3be5e8e3c |
| 宿主工程 | RNOH084Demo(测试页 rnAppKey = Base64TestApp) |
"react-native-base64": "git+https://atomgit.com/oh-react-native/react-native-base64.git#0.2.2-ohos-1.0.0"
// 只对 ASCII 安全
import base64 from 'react-native-base64';
base64.encode('Some string');              // "U29tZSBzdHJpbmc="
base64.decode('U29tZSBzdHJpbmc=');         // "Some string"

// 非 ASCII 必须走字节接口
base64.encodeFromByteArray(toUtf8Bytes('鸿蒙'));   // "6bi/6JKZ"

// 空串要自己兜底(否则得到 "AA==")
const encode = (s: string) => (s.length === 0 ? '' : base64.encode(s));
# 换页启动测试页(force-stop 不能省,换页参数只在冷启动生效)
hdc shell aa force-stop com.rnoh084.demo
hdc shell aa start -b com.rnoh084.demo -a EntryAbility --ps rnAppKey Base64TestApp
验证环境
| 项 | 版本 |
|---|---|
| React Native | 0.84.1 |
| React | 19.2.3 |
| RNOH(npm / ohpm) | @react-native-oh/react-native-harmony / @rnoh/react-native-openharmony 0.84.3 |
| Node.js | v24.14.0 |
| DevEco Studio | 26.0.0.621 |
| HarmonyOS SDK | API 26(26.0.0.32) |
| 设备 | HarmonyOS 7.0.0(26.0.0) Beta2 模拟器 Pura X View(ohos-x64) |
| 宿主 HAP 产物 | entry-default-signed.hap(80.0 MB) |
| 本次增量构建 | assembleHap 6 分 30 秒(改 JS 后重编 6 分 25 秒) |
| 验证规模 | 设备侧 31 项断言全通过 + 8 条行为边界实测;与 npm 上游 SHA256 一致 |
欢迎加入 CPF-RN 鸿蒙社区:https://atomgit.com/CPF-RN
React Native for OpenHarmony 组织:https://atomgit.com/oh-react-native
RN 三方库鸿蒙适配清单:https://atomgit.com/oh-react-native/rn-ohos-adaptation-overview
开源鸿蒙跨平台开发社区汇聚开发者与厂商,共建“一次开发,多端部署”的开源生态,致力于降低跨端开发门槛,推动万物智联创新。
更多推荐
 2
 0
- 0


 已为社区贡献30条内容

所有评论(0)