EHVC: Efficient Hierarchical Reference and Quality Structure forNeural Video Coding
时间:2025/9/24
会议:ACM MM 2025
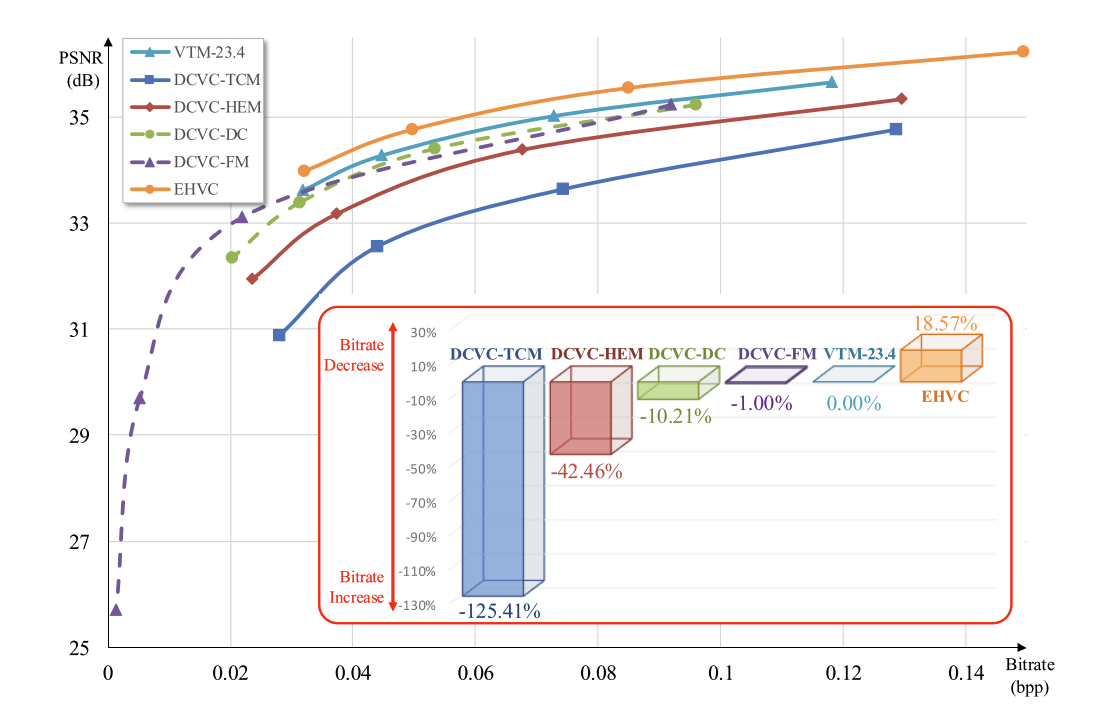
I.Background
NVCs的分层结构大致分为质量结构(quality structure)和参考结构(reference structure)两种。
质量结构:视频中不同帧被分配的重构分层质量,通常通过量化参数QP和损失权重来控制。对于质量结构而言,SOTA NVCs采用有损神经网络作为其编码主干,其网络非线性变换的固有属性容易导致压缩质量下降。
参考结构:参考结构指的是当前帧在编码时,允许参考哪些帧以及其相应权重(即哪些帧可以作为预测依据,重要程度如何)。对于参考结构而言,SOTA NVCs使用基于条件编码的框架,其中帧间信息在特征域中隐式传递,从而形成隐式参考结构。
近期研究主要关注NVCs中的质量结构,并通过引入显式分层设计对其进行优化。例如微软提出的DCVC-DC和DCVC-FM均采用高低质量帧交替的质量结构。这种设计源于它们都使用的层级拉格朗日乘子权重([0.5,1.2,0.5,0.9]),如公式1中的所示。此外,DCVC-FM首先发现了NVCs的随着帧索引的增加而出现显著的误差传播(error propaganda)问题,并试图通过在较长的序列上进行训练来缓解这一问题,并通过周期性刷新时间上下文生成来提高重建帧的质量。
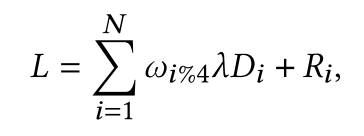
然而,对于参考结构设计的关注较少,并且参考结构设计从根本上应与分层质量结构保持一致。此外,分层质量结构仍有很大的进一步优化空间。这与传统视频编解码器形成鲜明对比,在传统视频编解码器中,数十年的发展不仅优化了模块级算法,还优化了总体分层结构——这是实现其稳健高效性能的关键因素。
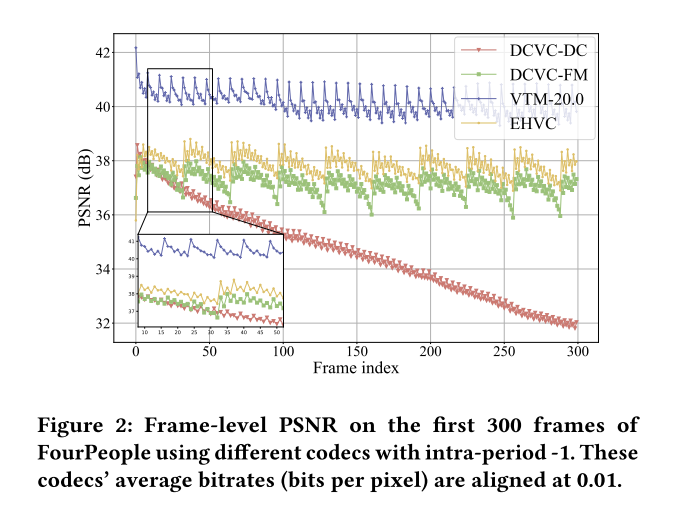
- 训练-测试不匹配(train-test mismatch):理论上,经过充分训练的NVC应该能够学习到近似最优的隐式分层结构。然而,训练资源的实际限制使得多帧训练阶段只能处理短视频序列,这导致训练和推理条件之间出现严重不匹配,如下图2所示。这种限制使学习到的隐式层次结构无法在推理时有效泛化到可变长度序列。更重要的是,在涉及长预测链的场景中,这种训练-测试不匹配(train-test mismatch)可能导致性能显著下降,甚至引发错误传播,严重影响编解码器的实际适用性。
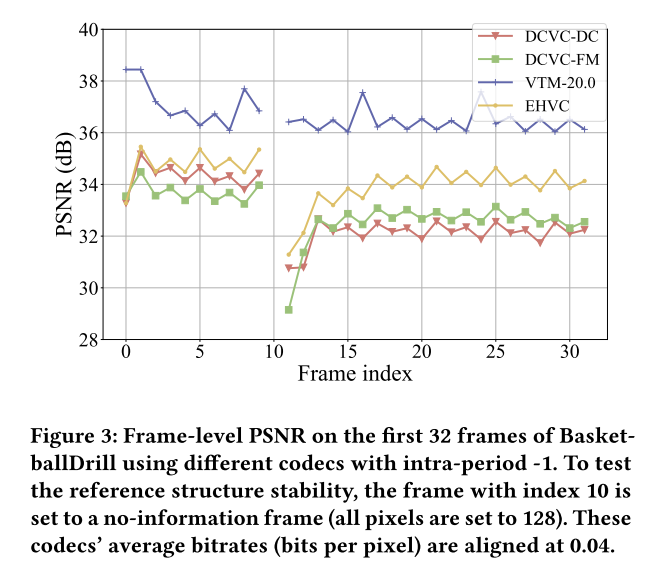
- 不稳定的隐式参考结构:如图3所示,无信息帧之后所有帧的质量都维持在较低水平。这一结果表明,时间上下文没有从t-1之前的帧中保留足够的信息,这说明隐式参照结构是脆弱的。因此,NVCs中的参考结构也需要像质量结构一样引入显式约束,并且应该避免参考结构与质量结构不匹配(reference-quality mismatch)。
II.Motivation
尽管最近的研究已开始优化NVCs中的分层质量结构,本文提出目前仍然存在的两个挑战:
- 参考-质量不匹配(reference-quality mismatch):现有NVCs仅专注于优化质量结构,采用纯隐式的参考结构,忽略了参考结构和质量结构之间保持严格的对应关系。这是因为高质量帧具有更高的参考价值,并且应有更大的概率被后续帧参考。
- 分层质量结构的效率仍然不高:神经网络视频编码中层级质量结构的效率和稳定性还有很大的提升空间。具体来说,第一,现有NVCs的分层质量结构完全依赖于后向时间信息,而没有前向信息。第二,分层权重的设计仅通过约束训练目标来优化模型参数中隐藏的质量结构,缺乏对量化参数的层级化设计。
III.Contribution
本文提出了具有更高效分层结构的EHVC,具体贡献为:
- 针对参考-质量不匹配问题:为低延迟配置下的EHVC设计了一种分层参考结构并提出了相应的分层多参考帧方案,使参考结构和质量结构对齐。
- EHVC提出前瞻(lookahead)策略,利用前向特征丰富编码器侧的上下文,从而实现了更好的率失真性能。
- 为了学习更灵活高效的质量结构,EHVC提出了具有随机质量训练策略的层级量化尺度。
- EHVC在intra-period -1设置下性能优于VTM。EHVC比以往的NVC具有更好的层次结构。此外,在intra-period为32和-1的情况下,与DCVC-FM相比,EHVC相对VTM-23.4低延迟B(LDB)设置下分别减少了10.98%和12.88%的码率。
IV.Methodology
A.总体框架
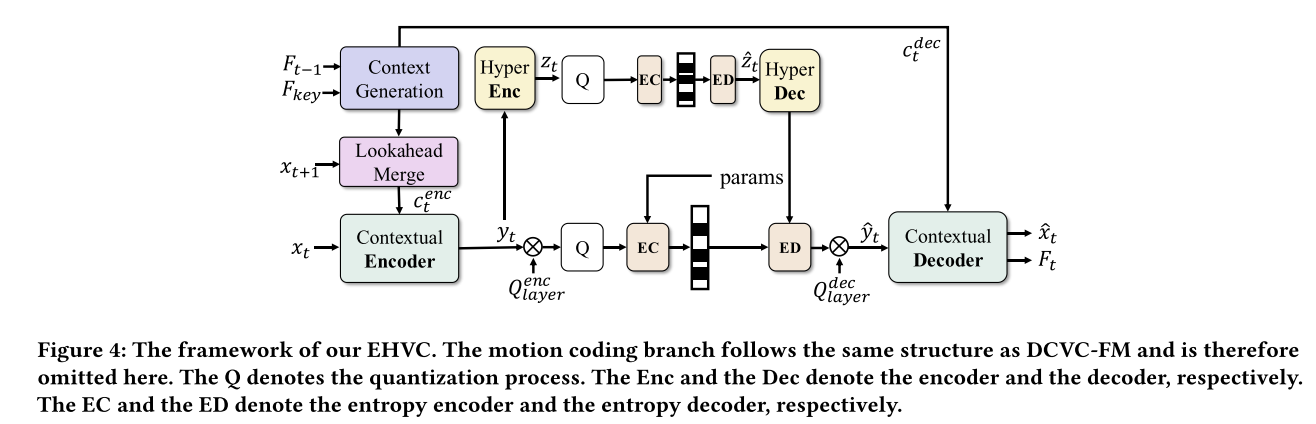
总体框架基本上是在DCVC-DC上改进的,并非文章所提的DCVC-FM,但是训练方式采用DCVC-FM并且具有刷新策略。
B.分层参考结构
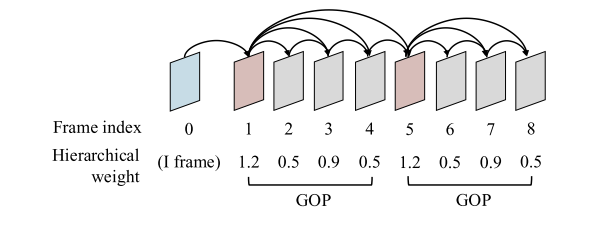
图5展示9帧序列设计的分层参考结构示例。将分层权重为1.2(高重建质量)的帧定义为关键帧(红色帧)。除了帧内编码帧和第一个关键帧,每个帧均参考其相邻的前一帧和前一个关键帧。与将相邻帧设为单一参考相比,我们的EHVC在保留相邻帧作为参考的同时,还融入了高质量的关键帧参考。当质量结构中的相邻帧质量较低时,关键帧参考可为当前帧提供高质量的参考信息。
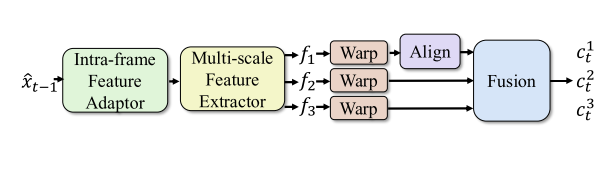
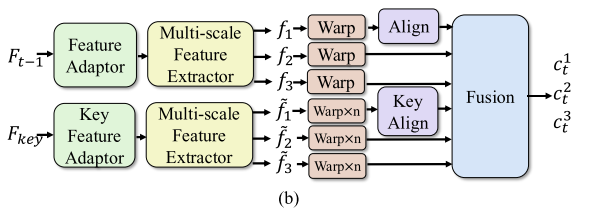
为实现分层参考结构,帧内编码帧对应的多尺度上下文生成模块如图6(a)所示(DCVC-DC的实现方式)。对于除帧内编码帧之外的其他帧,上下文生成分为两个分支:相邻帧分支和关键帧分支,如图6(b)所示。相邻帧分支与帧内编码帧的上下文生成几乎完全相同,唯一的变化是输入从重建帧变为解码器端特征
。关键帧分支的架构继承自相邻帧分支,不同之处在于其输入是关键帧的解码器端特征,并且需要进行n次扭曲以实现从关键帧到当前帧的对齐(文中说n是关键帧与当前帧之间的距离,实际上是Gop数)。融合模块最终对两个分支得到的特征进行融合,以获得三个不同尺度的时间上下文。
def motion_compensation(self, dpb, mv, index):
    # t-1 branch
    warpframe = flow_warp(dpb["ref_frame"], mv)
    mv2 = bilineardownsacling(mv) / 2
    mv3 = bilineardownsacling(mv2) / 2
    ref_feature1, ref_feature2, ref_feature3 = self.multi_scale_feature_extractor(dpb, index)
    context1_init = flow_warp(ref_feature1, mv)
    context1 = self.align(ref_feature1, torch.cat(
        (context1_init, warpframe, mv), dim=1), mv)
    context2 = flow_warp(ref_feature2, mv2)
    context3 = flow_warp(ref_feature3, mv3)

    # Line 421-446 is modified by ByteDance
    # key frame branch
    mvs_cat = mv
    mvs_add = mv
    key_feature1, key_feature2, key_feature3 = self.multi_scale_key_feature_extractor(dpb, index)
    key_feature1_before_warp = key_feature1.clone()
    if len(dpb["key_mvs"]):
        for key_mv in dpb["key_mvs"]:
            key_mv2 = bilineardownsacling(key_mv) / 2
            key_mv3 = bilineardownsacling(key_mv2) / 2

            key_feature1 = flow_warp(key_feature1, key_mv)
            key_feature2 = flow_warp(key_feature2, key_mv2)
            key_feature3 = flow_warp(key_feature3, key_mv3)

            mvs_cat = torch.cat((mvs_cat, key_mv), dim=1)
            mvs_add = mvs_add + key_mv

    while mvs_cat.shape[1] < 2*4:
        mvs_cat = torch.cat((mvs_cat, torch.zeros_like(mv)), dim=1)

    key1_init = flow_warp(key_feature1, mv)
    key1 = self.key_align(key_feature1_before_warp, torch.cat((key1_init, warpframe, mvs_cat), dim=1), mvs_add)
    key2 = flow_warp(key_feature2, mv2)
    key3 = flow_warp(key_feature3, mv3)

    # fusion
    context1, context2, context3 = self.context_fusion_net(context1, context2, context3, key1, key2, key3)
    return context1, context2, context3, warpframe
C.前瞻(Lookahead)策略
为了维持低延迟设置,EHVC仅为编码器融入一帧未来的前瞻信息。如图4所示,前瞻模块通过前瞻融合将后续帧与当前时间上下文进行融合,生成最终的编码器侧上下文
。然而,解码器使用的是前瞻融合之前的原始上下文
。
context1, context2, context3, _ = self.motion_compensation(dpb, mv_hat, frame_idx)
# Line 528-532 is modified by ByteDance
context1_merge = context1
if x_next is not None:
    feature_next = self.forward_feature_extractor(x_next)
    context1_merge = feature_next+context1
y = self.contextual_encoder(x, context1_merge, context2, context3, y_q_enc)
D.分层量化尺度与随机质量训练
基于传统视频编解码器的经验,分层质量结构的设计不仅包括控制率失真优化的分层拉格朗日乘子,还包括控制量化的分层量化参数。因此,引入了分层量化尺度,并结合分层拉格朗日乘数,以共同实现更稳定、更高效的质量结构。具体而言,在编码器和解码器中为不同层的帧(使用不同分层权重的帧)引入了不同的可学习逐层量化尺度(图4中的和
)。
def get_q_for_inference(self, q_in_ckpt,q_index,frame_idx):
    # Line 491-493 is modified by ByteDance
    frame_idx = frame_idx % 4
    index_map = [0, 1, 0, 2]
    layer_idx = index_map[frame_idx]

    mv_y_q_scale_enc = self.mv_y_q_scale_enc if q_in_ckpt else self.mv_y_q_scale_enc_fine
    mv_y_q_enc = self.get_curr_q(mv_y_q_scale_enc, self.mv_y_q_basic_enc, q_index=q_index)
    mv_y_q_scale_dec = self.mv_y_q_scale_dec if q_in_ckpt else self.mv_y_q_scale_dec_fine
    mv_y_q_dec = self.get_curr_q(mv_y_q_scale_dec, self.mv_y_q_basic_dec, q_index=q_index)

    y_q_scale_enc = self.y_q_scale_enc if q_in_ckpt else self.y_q_scale_enc_fine
    y_q_enc = self.get_curr_q(y_q_scale_enc, self.y_q_basic_enc, q_index=q_index)
    # Line 503 is modified by ByteDance
    y_q_enc = self.get_curr_q(self.y_q_layer_enc, y_q_enc, q_index=layer_idx)
    y_q_scale_dec = self.y_q_scale_dec if q_in_ckpt else self.y_q_scale_dec_fine
    y_q_dec = self.get_curr_q(y_q_scale_dec, self.y_q_basic_dec, q_index=q_index)
    # Line 507 is modified by ByteDance
    y_q_dec = self.get_curr_q(self.y_q_layer_dec, y_q_dec, q_index=layer_idx)

    return mv_y_q_enc, mv_y_q_dec, y_q_enc, y_q_dec
考虑到质量结构在推理过程中无法保持严格稳定,引入随机质量训练策略,使模型适应质量结构的波动。具体而言,训练期间第一关键帧(索引为1的帧)的量化尺度会被随机缩放,即训练期间第一关键帧的量化尺度通过图7所示。其中,𝜔是一个随机尺度,其值范围为0.8至1.2。
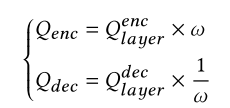
开源鸿蒙跨平台开发社区汇聚开发者与厂商,共建“一次开发,多端部署”的开源生态,致力于降低跨端开发门槛,推动万物智联创新。
更多推荐
 5
 0
- 0


 已为社区贡献1条内容

所有评论(0)