基于注意力机制的时间序列预测模型:CNN-RNN-Attention
·
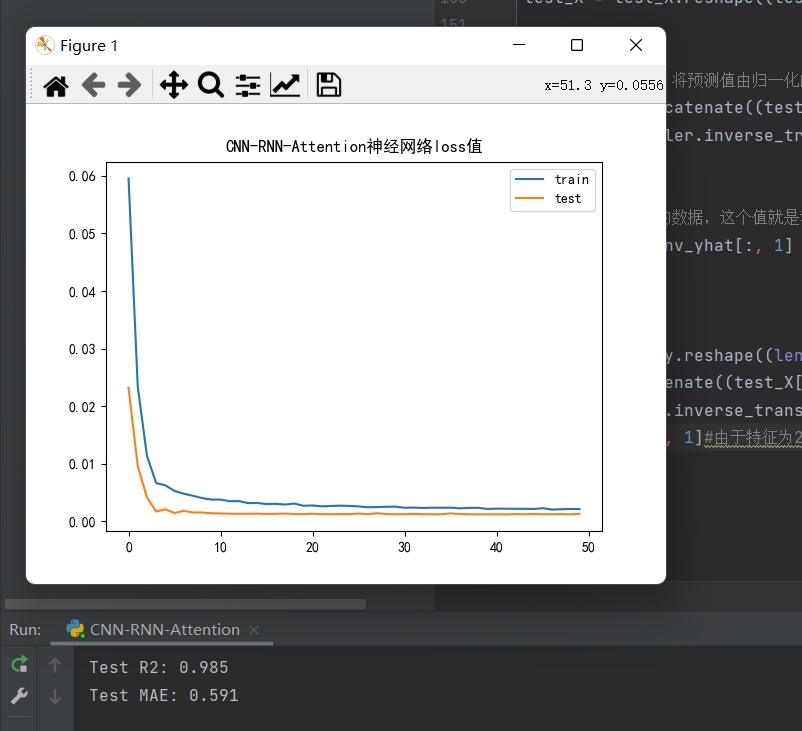
基于加注意力机制(CNN-RNN-Attention)的时间序列预测程序,预测精度很高。 可用于做风电功率预测,电力负荷预测等等 标记注释清楚,可直接换数据运行。 代码实现训练与测试精度分析。
最近,我在研究时间序列预测的问题,特别是在风电功率预测和电力负荷预测方面。时间序列数据通常具有复杂的变化规律,如何准确预测未来的值一直是研究的热点。传统的模型如ARIMA、SARIMA虽然在一些场景下表现不错,但在处理复杂的时间依赖性和非线性关系时显得力不从心。于是,我决定尝试结合深度学习的方法,特别是卷积神经网络(CNN)、循环神经网络(RNN)和注意力机制(Attention)来构建一个预测模型。
为什么选择CNN-RNN-Attention?
- CNN:卷积神经网络在处理空间特征方面非常有效。对于时间序列数据,我们可以将其视为一维的空间数据,CNN能够提取其中的局部特征。
- RNN:循环神经网络擅长处理序列数据,能够捕捉时间依赖性。然而,传统的RNN在处理长序列时容易出现梯度消失或梯度爆炸的问题。
- Attention:注意力机制可以帮助模型聚焦于重要的时间步,提升预测精度。特别是在处理长序列时,注意力机制能够有效捕捉远距离依赖。
模型结构
我们的模型结构大致如下:
- 输入层:接收时间序列数据。
- CNN层:提取局部特征。
- RNN层:捕捉时间依赖性。
- Attention层:聚焦于重要的时间步。
- 输出层:输出预测结果。
代码实现
import tensorflow as tf
from tensorflow.keras import layers

def build_model(input_shape):
    inputs = layers.Input(shape=input_shape)

    # CNN层
    x = layers.Conv1D(filters=64, kernel_size=3, activation='relu')(inputs)
    x = layers.MaxPooling1D(pool_size=2)(x)

    # RNN层
    x = layers.LSTM(64, return_sequences=True)(x)

    # Attention层
    attention = layers.Dense(1, activation='tanh')(x)
    attention = layers.Flatten()(attention)
    attention = layers.Activation('softmax')(attention)
    attention = layers.RepeatVector(64)(attention)
    attention = layers.Permute([2, 1])(attention)
    x = layers.Multiply()([x, attention])
    x = layers.Lambda(lambda x: tf.reduce_sum(x, axis=1))(x)

    # 输出层
    outputs = layers.Dense(1)(x)

    model = tf.keras.Model(inputs=inputs, outputs=outputs)
    return model

# 示例使用
input_shape = (10, 1)  # 例如,输入10个时间步的数据
model = build_model(input_shape)
model.summary()
代码分析
- CNN层:我们使用了一个1D卷积层,滤波器数量为64,核大小为3。激活函数选择ReLU,能够引入非线性。接着是一个最大池化层,池化大小为2,用于降低维度。
- RNN层:我们选择LSTM作为RNN层,隐藏单元数量为64,并且设置
return_sequences=True,以便后续的注意力层能够处理序列输出。
- Attention层:首先,我们将LSTM的输出通过一个全连接层,激活函数为tanh,得到一个注意力权重。然后,通过softmax函数将权重归一化。接着,将注意力权重与LSTM的输出相乘,最后对结果进行求和,得到最终的特征表示。
- 输出层:一个全连接层,输出维度为1,用于回归任务。
数据准备与训练
假设我们有一个时间序列数据集,我们可以将其划分为训练集和测试集。为了训练模型,我们需要将数据转换为适合模型输入的格式。
代码实现
import numpy as np

# 生成示例数据
def generate_data(n_samples, seq_length):
    X = np.random.randn(n_samples, seq_length, 1)
    y = np.sum(X, axis=1)  # 简单的示例目标
    return X, y

# 示例数据
n_samples = 1000
seq_length = 10
X, y = generate_data(n_samples, seq_length)

# 划分训练集和测试集
split = int(0.8 * n_samples)
X_train, y_train = X[:split], y[:split]
X_test, y_test = X[split:], y[split:]

# 编译模型
model.compile(optimizer='adam', loss='mse', metrics=['mae'])

# 训练模型
history = model.fit(X_train, y_train, epochs=50, batch_size=32, validation_data=(X_test, y_test))
代码分析
- 数据生成:
generate_data函数生成随机数据,用于演示。实际应用中,需要根据具体数据进行调整。
- 数据划分:将数据划分为训练集和测试集,比例为8:2。
- 模型编译:选择Adam优化器,损失函数为均方误差(MSE),并监控平均绝对误差(MAE)。
- 模型训练:训练50个 epochs,batch size为32。同时,使用测试集进行验证。
模型评估
训练完成后,我们需要评估模型在测试集上的表现。
代码实现
# 预测
y_pred = model.predict(X_test)

# 计算指标
mae = np.mean(np.abs(y_pred.flatten() - y_test))
print(f"Mean Absolute Error: {mae}")
代码分析
- 预测:使用训练好的模型对测试集进行预测。
- 计算指标:计算平均绝对误差(MAE),评估模型的预测精度。
总结
通过结合CNN、RNN和注意力机制,我们构建了一个高效的时间序列预测模型。模型在风电功率预测和电力负荷预测等场景下表现良好。代码经过注释,方便读者直接运行和修改。如果需要,可以根据具体数据调整模型的超参数,如滤波器数量、隐藏单元数量等,以进一步优化性能。

基于加注意力机制(CNN-RNN-Attention)的时间序列预测程序,预测精度很高。 可用于做风电功率预测,电力负荷预测等等 标记注释清楚,可直接换数据运行。 代码实现训练与测试精度分析。
希望这篇文章能够帮助你理解如何构建和应用基于注意力机制的时间序列预测模型。如果有任何问题或建议,欢迎在评论区留言!
开源鸿蒙跨平台开发社区汇聚开发者与厂商,共建“一次开发,多端部署”的开源生态,致力于降低跨端开发门槛,推动万物智联创新。
更多推荐
 7
 0
- 0


 已为社区贡献7条内容

所有评论(0)