k8s中的控制器的使用
官方文档:
控制器也是管理pod的一种手段
-
自主式pod:pod退出或意外关闭后不会被重新创建
-
控制器管理的 Pod:在控制器的生命周期里,始终要维持 Pod 的副本数目
Pod控制器是管理pod的中间层,使用Pod控制器之后,只需要告诉Pod控制器,想要多少个什么样的Pod就可以了,它会创建出满足条件的Pod并确保每一个Pod资源处于用户期望的目标状态。如果Pod资源在运行中出现故障,它会基于指定策略重新编排Pod
当建立控制器后,会把期望值写入etcd,k8s中的apiserver检索etcd中我们保存的期望状态,并对比pod的当前状态,如果出现差异代码自驱动立即恢复
负责整个集群中对于数量的监控的软件就是控制器,当有一台主机出现了错误,控制器会立刻,找一台新的主机来顶替它的工作
控制机常用类型
| 控制器名称 | 控制器用途 |
|---|---|
| Replication Controller | 比较原始的pod控制器,已经被废弃,由ReplicaSet替代 |
| ReplicaSet | ReplicaSet 确保任何时间都有指定数量的 Pod 副本在运行 |
| Deployment | 一个 Deployment 为 Pod 和 ReplicaSet 提供声明式的更新能力 |
| DaemonSet | DaemonSet 确保全指定节点上运行一个 Pod 的副本 |
| StatefulSet | StatefulSet 是用来管理有状态应用的工作负载 API 对象。 |
| Job | 执行批处理任务,仅执行一次任务,保证任务的一个或多个Pod成功结束 |
| CronJob | Cron Job 创建基于时间调度的 Jobs。 |
| HPA全称Horizontal Pod Autoscaler | 根据资源利用率自动调整service中Pod数量,实现Pod水平自动缩放 |
查看容器名称

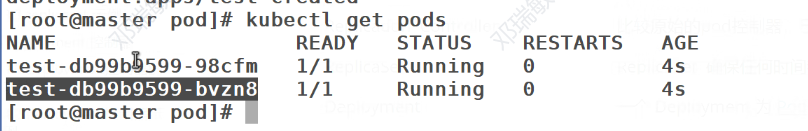
名字不会一直叫这个
如果出现了故障退出,那每次启动时,名字都会变化,那这里就做不了主从复制,要解决就要把他的名字固定住,每次登录还是一样的名字
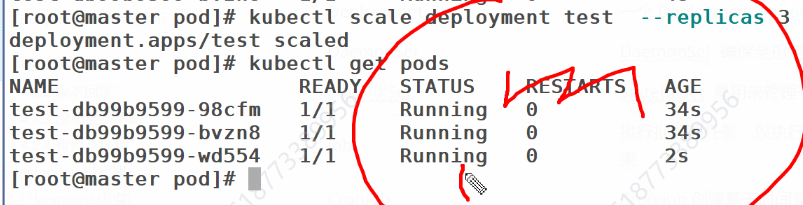
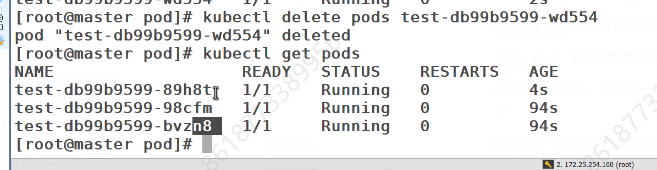
replicaset控制器
-
ReplicaSet 是下一代的 Replication Controller,官方推荐使用ReplicaSet
-
ReplicaSet和Replication Controller的唯一区别是选择器的支持,ReplicaSet支持新的基于集合的选择器需求
-
ReplicaSet 确保任何时间都有指定数量的 Pod 副本在运行
-
虽然 ReplicaSets 可以独立使用,但今天它主要被Deployments 用作协调 Pod 创建、删除和更新的机制
replicaset 示例
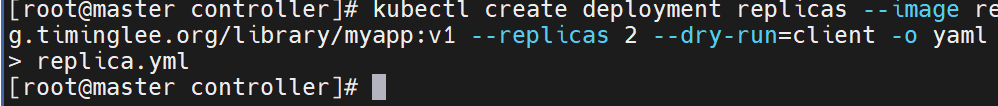
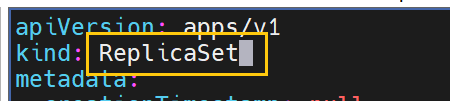
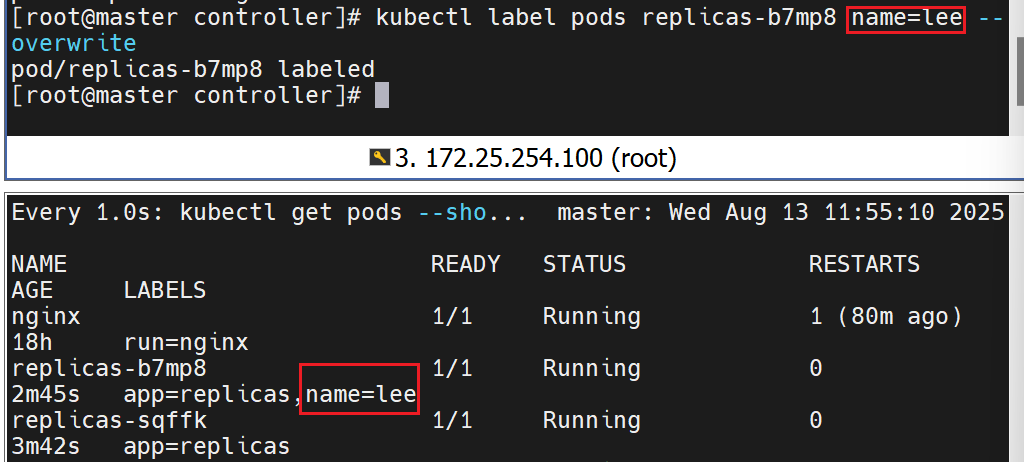
这里给控制器里做标签,是为了让微服务可以发现它
给容器写标签,是为了让控制器可以检测到它
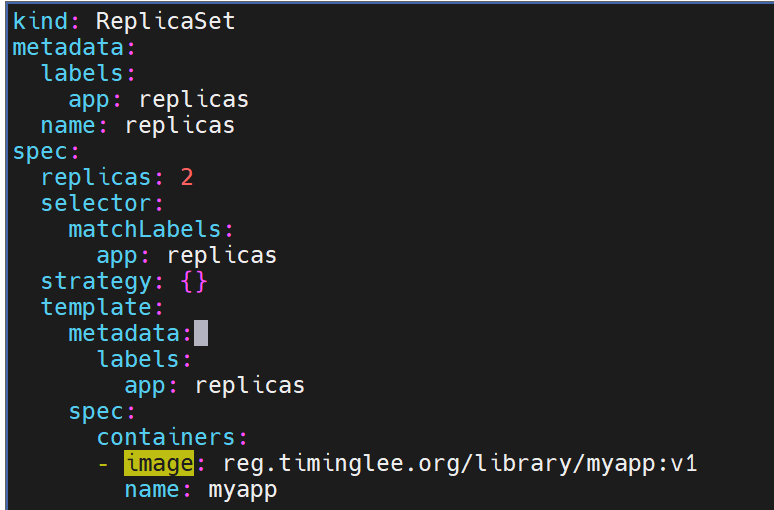
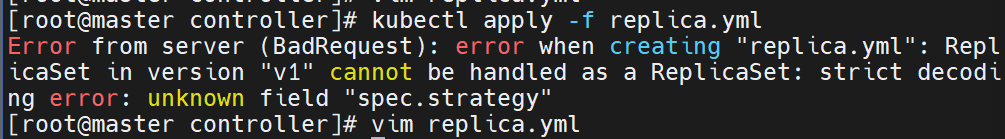
strategy(更新策略)是 Deployment 资源的字段,用于定义 Pod 滚动更新的策略(如RollingUpdate或Recreate)。而 ReplicaSet 作为更基础的控制器,并不支持strategy配置,因此在 ReplicaSet 的 YAML 中声明该字段会被 Kubernetes 拒绝
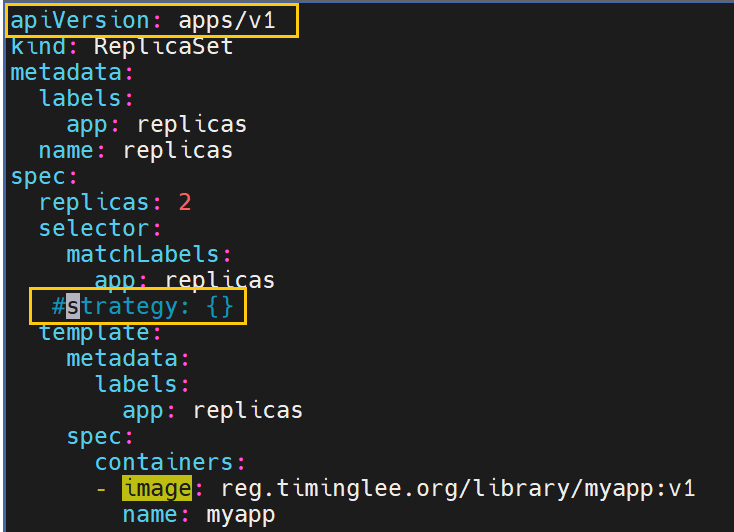
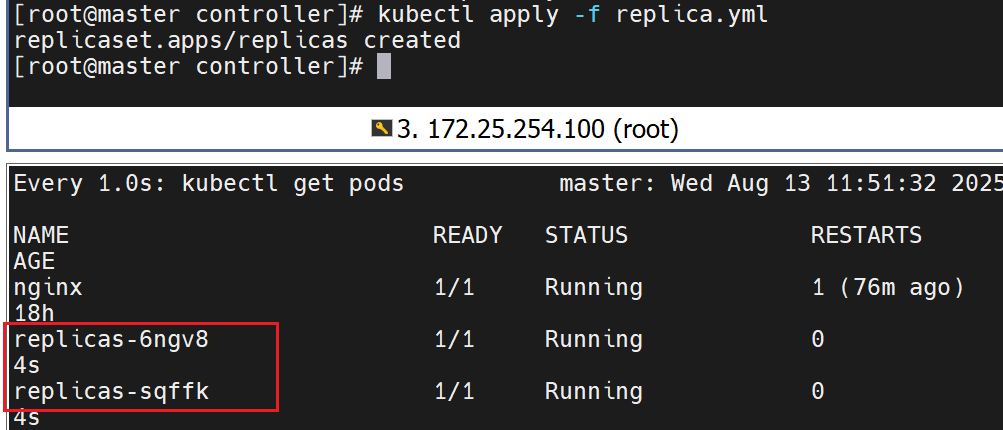
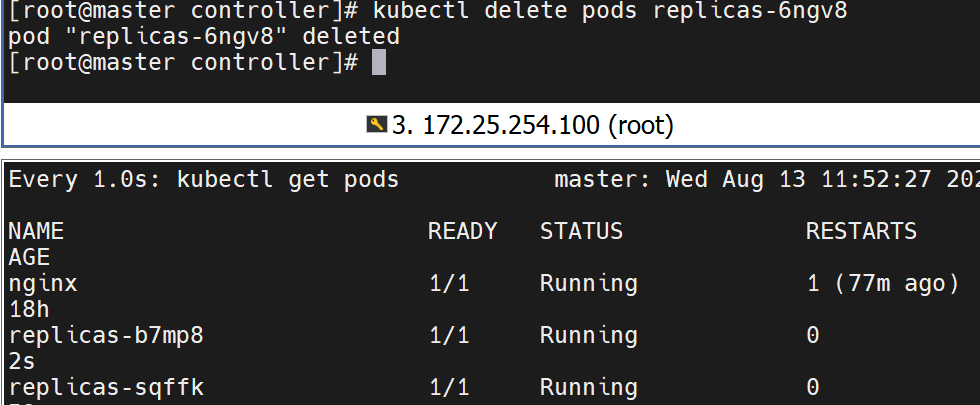
删除pods还会重新建一个
指定的标签不一致,就不算上这个不一致的了
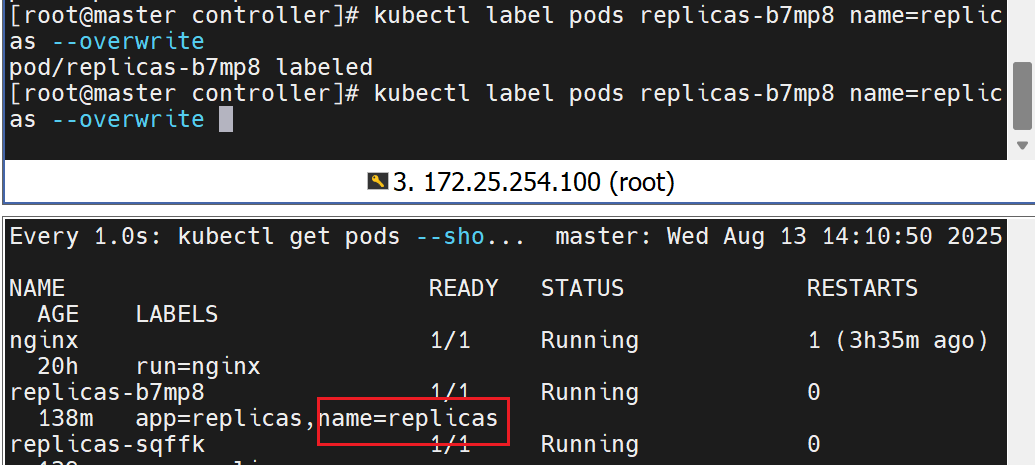
将其修改回去
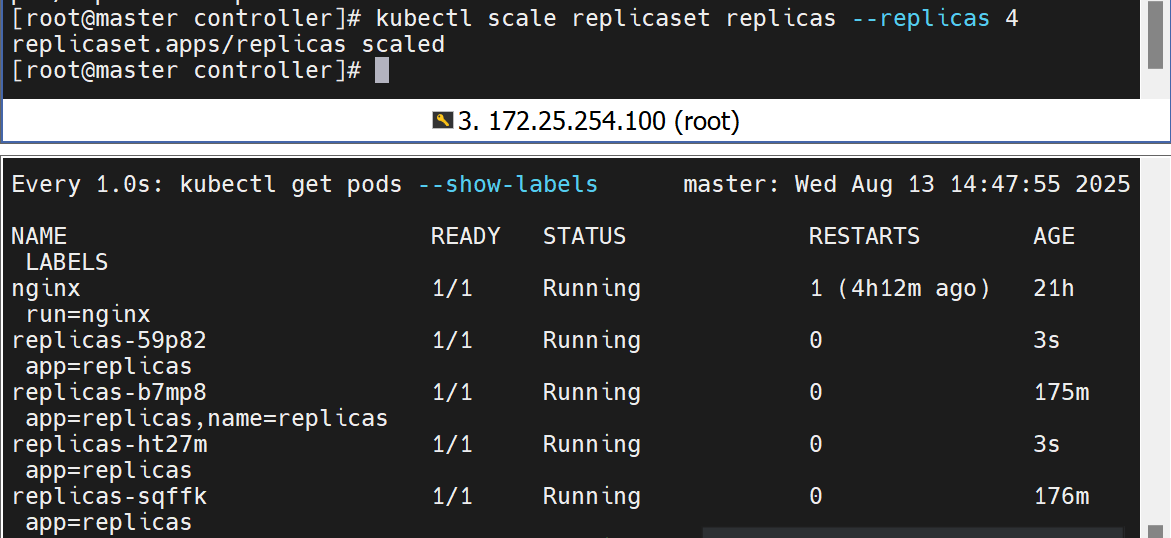
修改个数,可以拉伸也可以声明
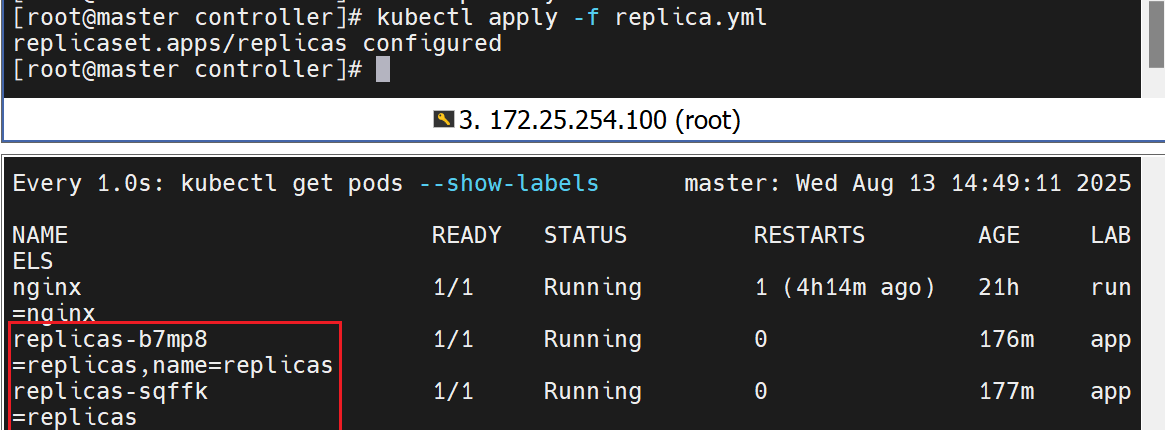
再次重启yml,会根据yml中的内容再次刷新个数
deployment 控制器


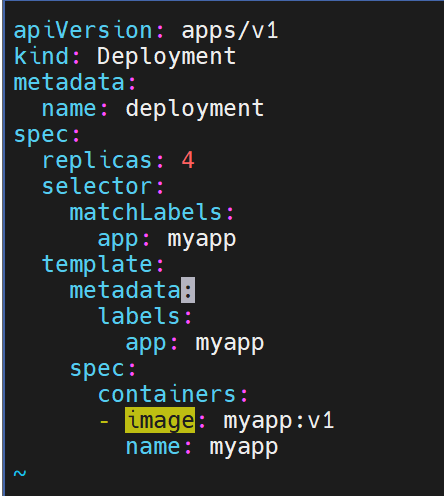
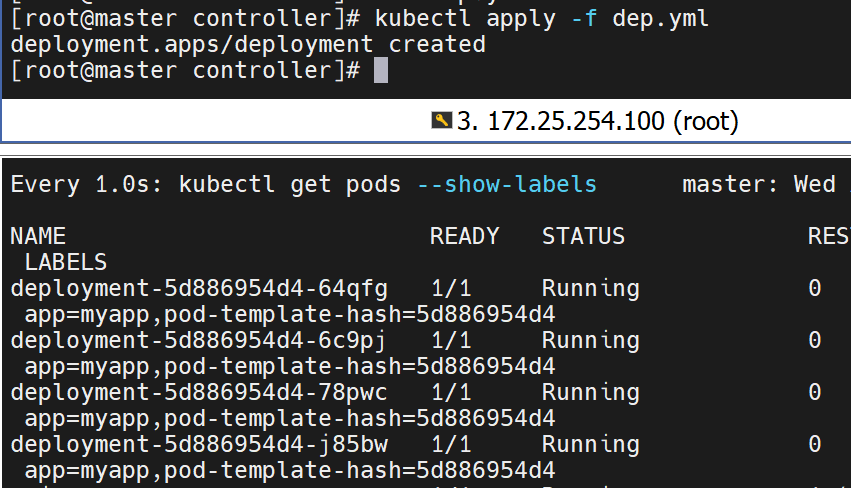

版本更新
直接在编辑文件里声明就行
#pod运行容器版本为v1
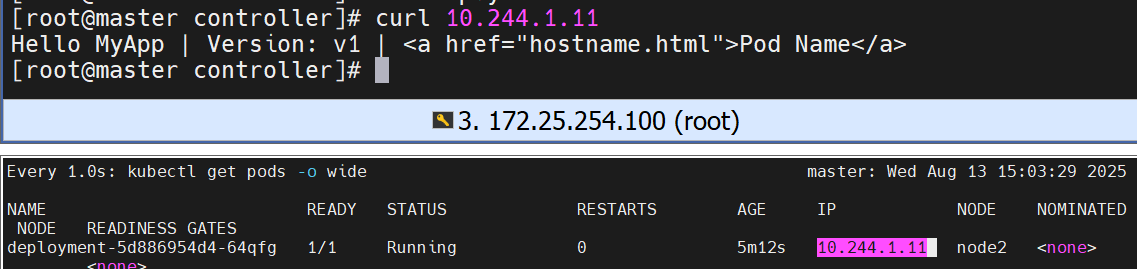
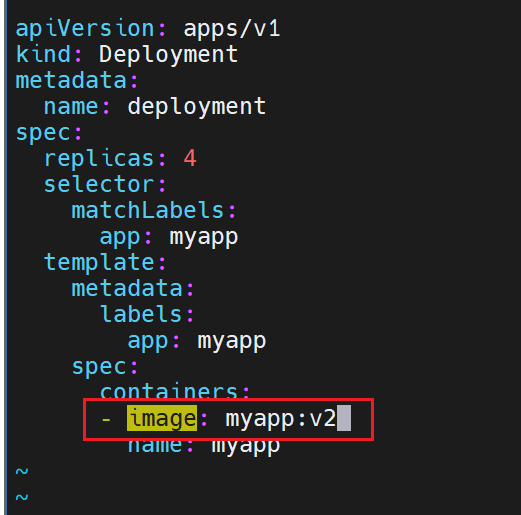
查看更新效果
更新的过程是重新建立一个版本的RS,新版本的RS会把pod 重建,然后把老版本的RS回收
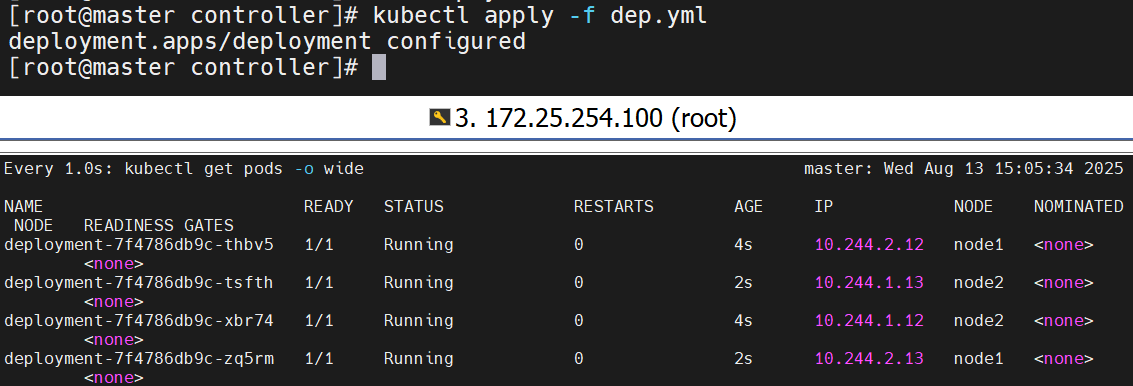
可以看到版本变化了
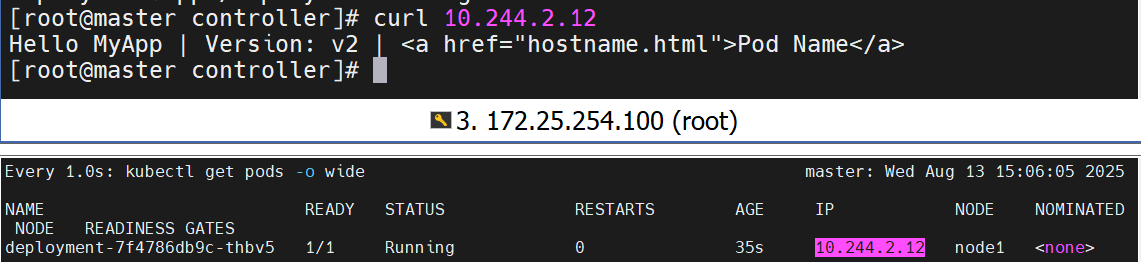
版本回滚
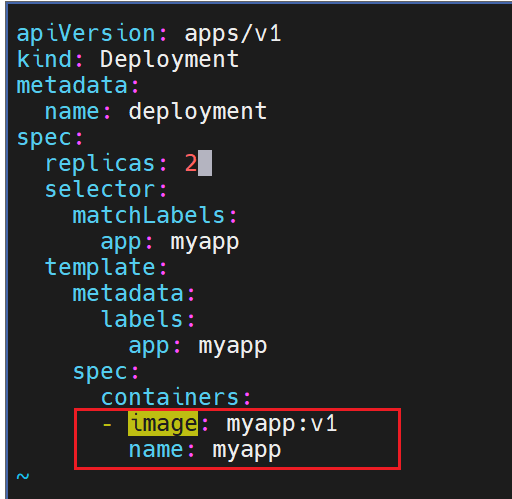
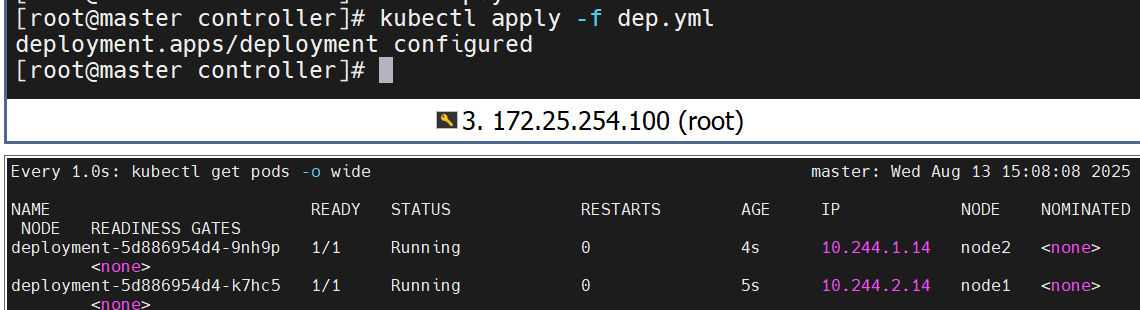
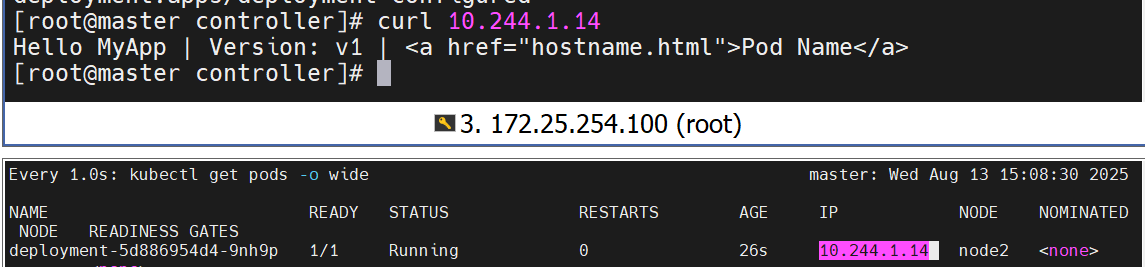
滚动更新策略
这次更新了一部分,下次更新就5秒一次,一共要更新8个
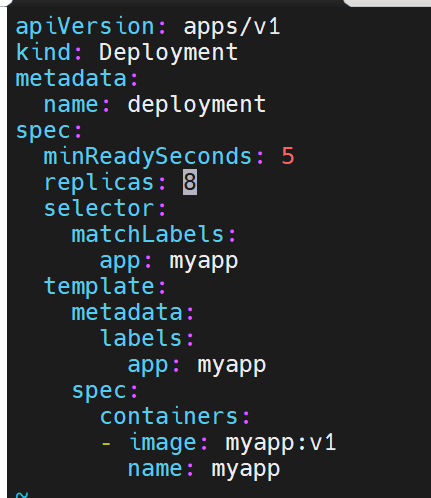
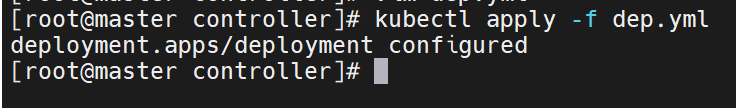
影响最小的,最丝滑的更新策略
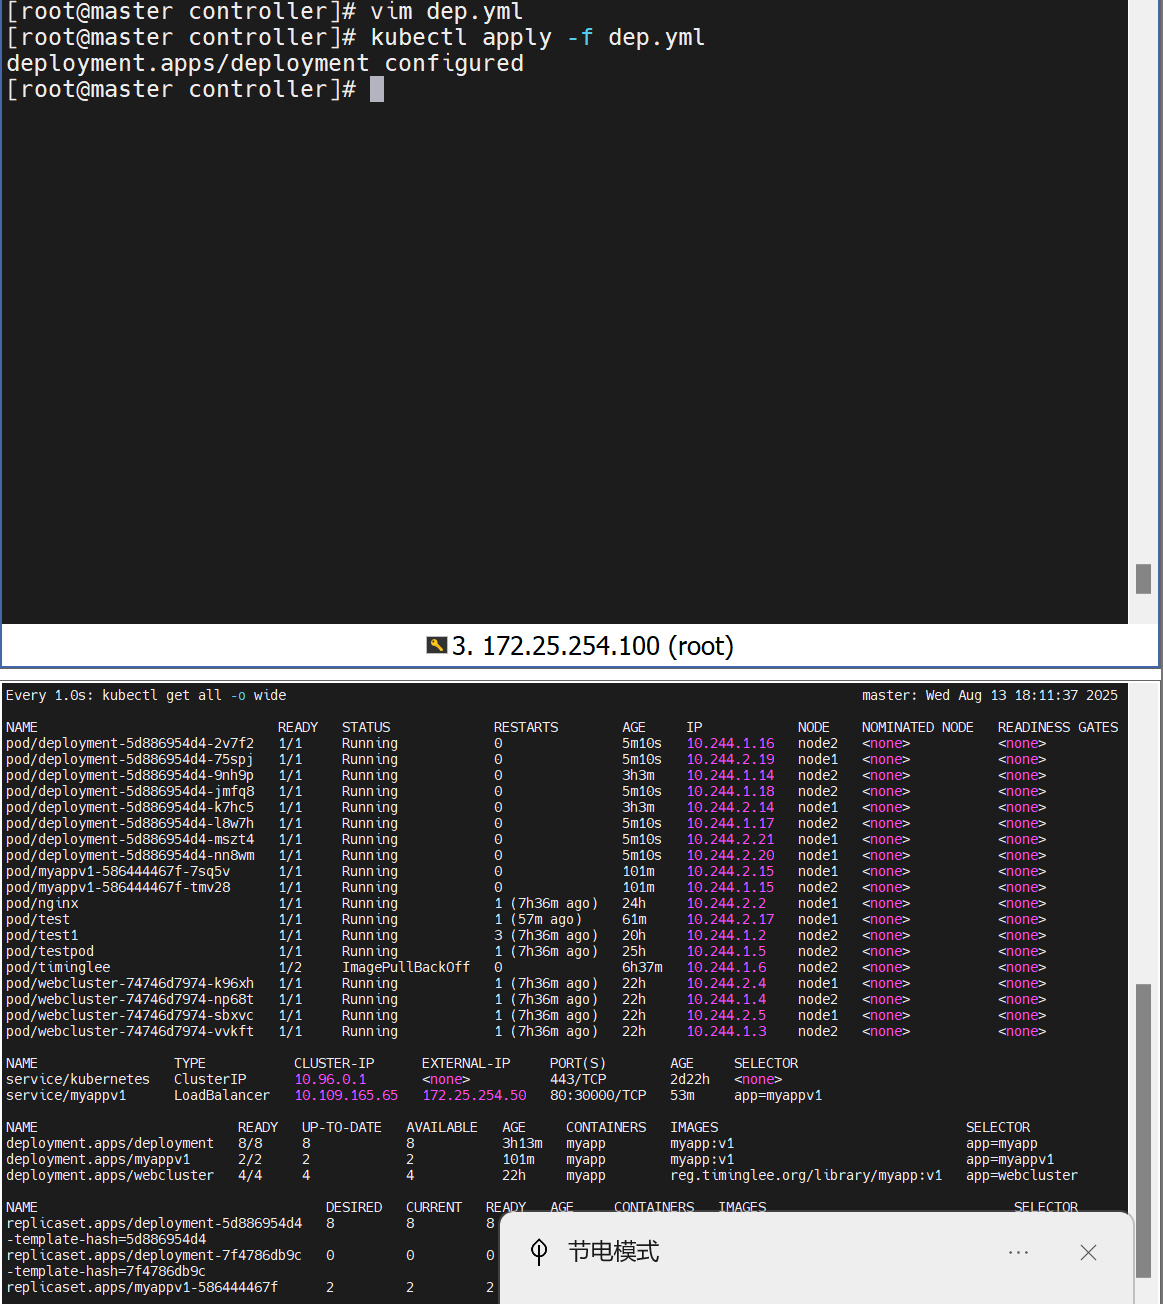
更一个关一个
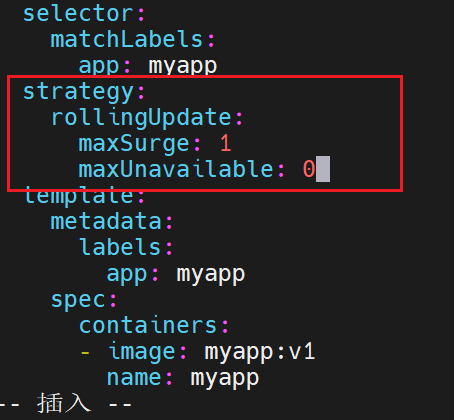
maxUn~~更新中不能用的是0个,这里就是不能有不能用的
暂停及恢复
在实际生产环境中我们做的变更可能不止一处,当修改了一处后,如果执行变更就直接触发了
我们期望的触发时当我们把所有修改都搞定后一次触发
暂停,避免触发不必要的线上更新


[root@k8s2 pod]# kubectl apply -f deployment-example.yaml
#调整副本数,不受影响
[root@k8s-master ~]# kubectl describe pods deployment-7f4786db9c-8jw22
Name: deployment-7f4786db9c-8jw22
Namespace: default
Priority: 0
Service Account: default
Node: k8s-node1/172.25.254.10
Start Time: Mon, 02 Sep 2024 00:27:20 +0800
Labels: app=myapp
pod-template-hash=7f4786db9c
Annotations: <none>
Status: Running
IP: 10.244.1.31
IPs:
IP: 10.244.1.31
Controlled By: ReplicaSet/deployment-7f4786db9c
Containers:
myapp:
Container ID: docker://01ad7216e0a8c2674bf17adcc9b071e9bfb951eb294cafa2b8482bb8b4940c1d
Image: myapp:v2
Image ID: docker-pullable://myapp@sha256:5f4afc8302ade316fc47c99ee1d41f8ba94dbe7e3e7747dd87215a15429b9102
Port: <none>
Host Port: <none>
State: Running
Started: Mon, 02 Sep 2024 00:27:21 +0800
Ready: True
Restart Count: 0
Environment: <none>
Mounts:
/var/run/secrets/kubernetes.io/serviceaccount from kube-api-access-mfjjp (ro)
Conditions:
Type Status
PodReadyToStartContainers True
Initialized True
Ready True
ContainersReady True
PodScheduled True
Volumes:
kube-api-access-mfjjp:
Type: Projected (a volume that contains injected data from multiple sources)
TokenExpirationSeconds: 3607
ConfigMapName: kube-root-ca.crt
ConfigMapOptional: <nil>
DownwardAPI: true
QoS Class: BestEffort
Node-Selectors: <none>
Tolerations: node.kubernetes.io/not-ready:NoExecute op=Exists for 300s
node.kubernetes.io/unreachable:NoExecute op=Exists for 300s
Events:
Type Reason Age From Message
---- ------ ---- ---- -------
Normal Scheduled 6m22s default-scheduler Successfully assigned default/deployment-7f4786db9c-8jw22 to k8s-node1
Normal Pulled 6m22s kubelet Container image "myapp:v2" already present on machine
Normal Created 6m21s kubelet Created container myapp
Normal Started 6m21s kubelet Started container myapp
#但是更新镜像和修改资源并没有触发更新
[root@k8s2 pod]# kubectl rollout history deployment deployment-example
deployment.apps/deployment-example
REVISION CHANGE-CAUSE
3 <none>
4 <none>#恢复后开始触发更新
[root@k8s2 pod]# kubectl rollout resume deployment deployment-example[root@k8s2 pod]# kubectl rollout history deployment deployment-example
deployment.apps/deployment-example
REVISION CHANGE-CAUSE
3 <none>
4 <none>
5 <none>#回收
[root@k8s2 pod]# kubectl delete -f deployment-example.yaml
Deamonset控制器
DaemonSet 确保全部(或者某些)节点上运行一个 Pod 的副本。当有节点加入集群时, 也会为他们新增一个 Pod ,当有节点从集群移除时,这些 Pod 也会被回收。删除 DaemonSet 将会删除它创建的所有 Pod
DaemonSet 的典型用法:
-
在每个节点上运行集群存储 DaemonSet,例如 glusterd、ceph。
-
在每个节点上运行日志收集 DaemonSet,例如 fluentd、logstash。
-
在每个节点上运行监控 DaemonSet,例如 Prometheus Node Exporter、zabbix agent等
-
一个简单的用法是在所有的节点上都启动一个 DaemonSet,将被作为每种类型的 daemon 使用
-
一个稍微复杂的用法是单独对每种 daemon 类型使用多个 DaemonSet,但具有不同的标志, 并且对不同硬件类型具有不同的内存、CPU 要求
过滤一下污点信息

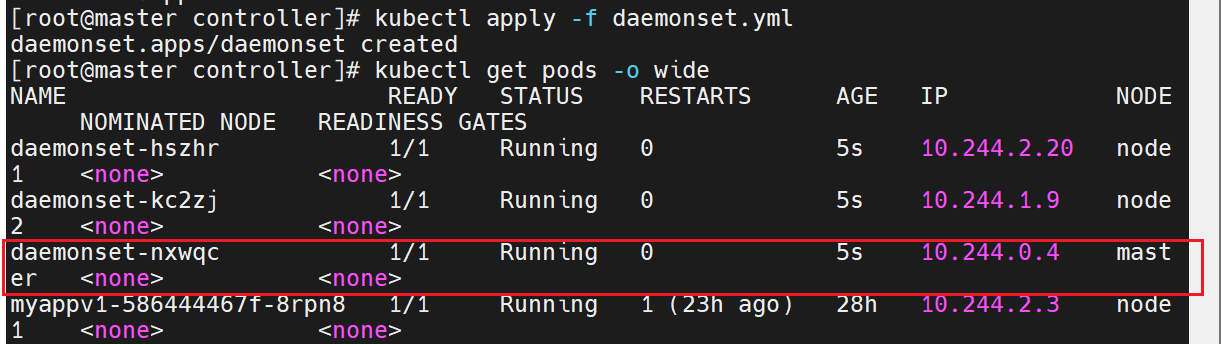
现在只在master设定了污点,默认是不被调用的
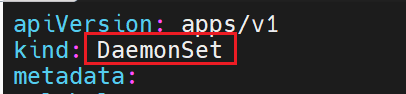
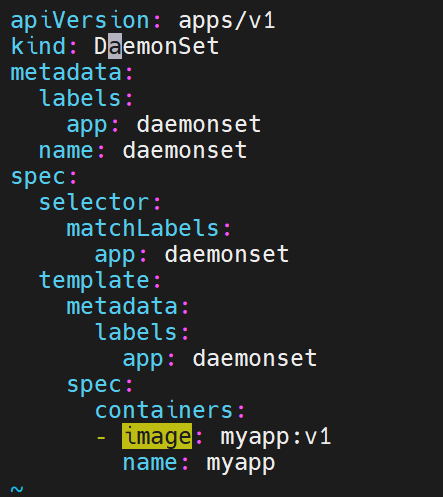
我们的myapp是会在node1&2上都会有,但是master上是默认不会有的,因为是有污点的

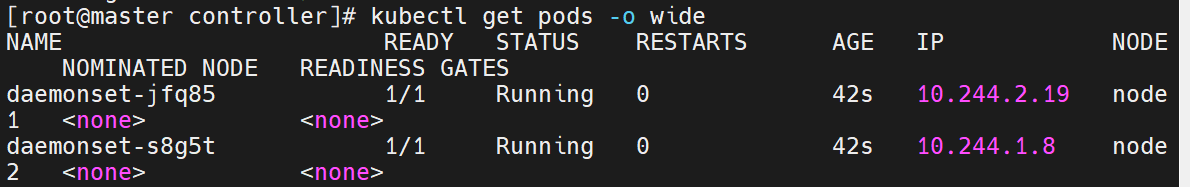
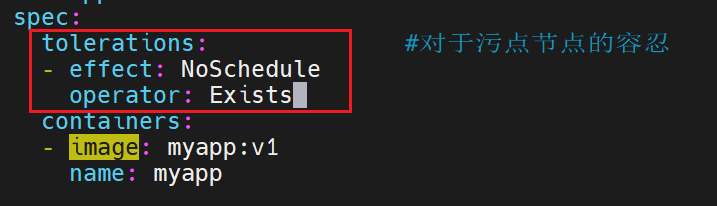
但是master上也不是不可以有,可以设置对污点的容忍度,就可以运行了
强容忍,即便有也不在乎
job 控制器
Job,主要用于负责批量处理(一次要处理指定数量任务)短暂的一次性(每个任务仅运行一次就结束)任务
Job特点如下:
-
当Job创建的pod执行成功结束时,Job将记录成功结束的pod数量
-
当成功结束的pod达到指定的数量时,Job将完成执行

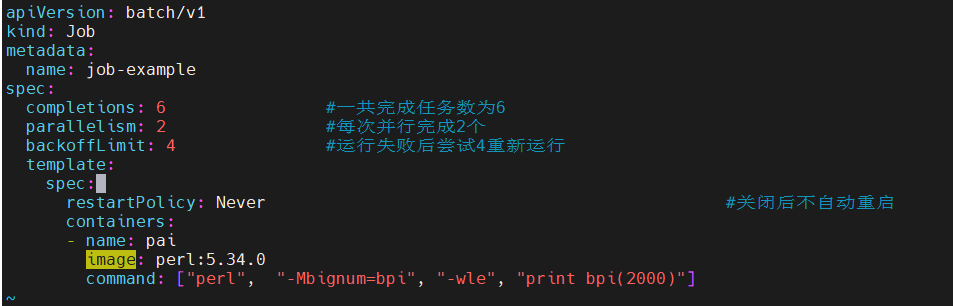
一共有几次任务,每次开机个pod,一共几轮完成,当pod运行了四次,都没成功就重新计数再来
退出了,做什么处理,如果停掉了,就什么都不做了

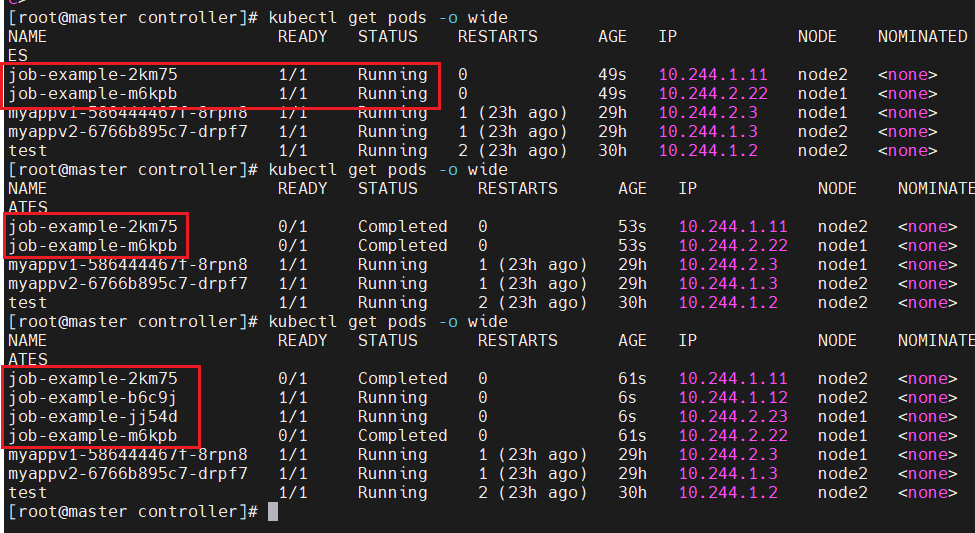
此时运行就是两个两个开始建立
直到完成6个的创建
cronjob控制器
-
Cron Job 创建基于时间调度的 Jobs。
-
CronJob控制器以Job控制器资源为其管控对象,并借助它管理pod资源对象,
-
CronJob可以以类似于Linux操作系统的周期性任务作业计划的方式控制其运行时间点及重复运行的方式。
-
CronJob可以在特定的时间点(反复的)去运行job任务。
job是一次性的,需要周期进行的话,需要加上时间
示例

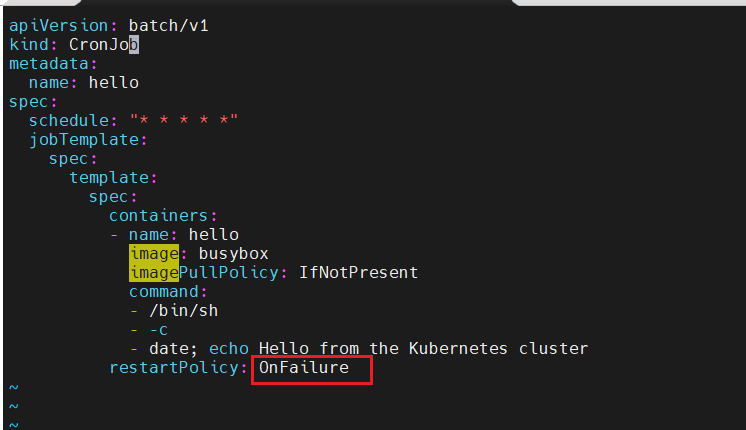
先显示系统时间
如果本地有镜像就不拉,没有就拉取
如果挂了,就重新开启

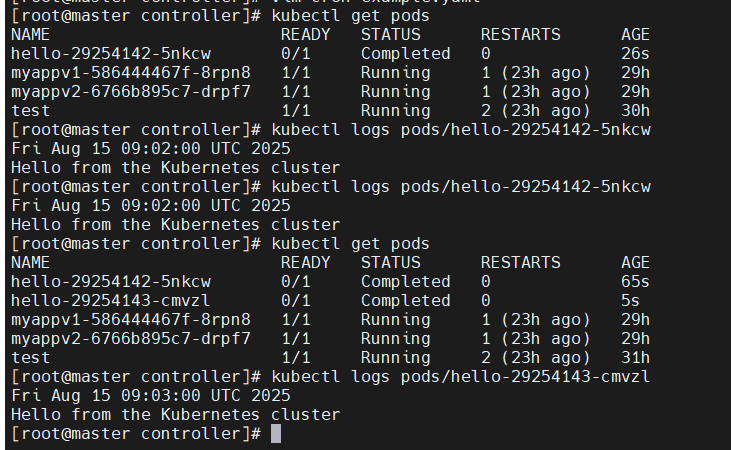
每隔一分钟,会新建一个
开源鸿蒙跨平台开发社区汇聚开发者与厂商,共建“一次开发,多端部署”的开源生态,致力于降低跨端开发门槛,推动万物智联创新。
更多推荐


 25
 0
- 0


 已为社区贡献1条内容

所有评论(0)