一文读懂循环神经网络—机器翻译(编码器-解码器架构+序列到序列学习(seq2seq)+束搜索)
目录
5. 序列标准化(truncate_pad和build_array_nmt函数)
四、核心架构:编码器-解码器(encoder-decoder)架构
六、关键改进:注意力机制(Attention Mechanism)
七、主流模型:Transformer(基于自注意力)(见后文)
机器翻译(Machine Translation,简称 MT)是指利用计算机技术将一种自然语言(源语言)自动转换为另一种自然语言(目标语言)的过程。
一、数据处理流程(以英法翻译为例)
机器翻译对数据质量要求极高,流程可概括为 “数据获取→预处理→标准化→批次生成”,对应你之前代码中的核心步骤:
1. 平行语料库(核心数据)
- 定义:由 “源语言句子 - 目标语言句子” 对组成的数据集(如 “Hello Bonjour”)。
- 来源:双语网站(如欧盟议会文件)、书籍翻译、人工标注等。
- 示例:你代码中使用的
fra-eng数据集,包含英语 - 法语平行句对。
2. 预处理(preprocess_nmt函数)
- 目标:统一格式,减少噪声,便于后续词元化。
- 关键操作:
- 大小写标准化(如转为小写,避免 “Hello” 和 “hello” 被视为不同词);
- 特殊字符处理(如替换窄空格
\u202f为普通空格,统一符号格式); - 标点分割(如 “hello.world”→“hello . world”,确保标点被正确词元化)。
3. 词元化(tokenize_nmt函数)
- 目标:将句子拆分为最小语义单元(词元),便于模型处理。
- 操作:按空格分割(如英语 “i love you”→
["i", "love", "you"],法语 “je t'aime”→["je", "t'aime"])。 - 注意:双语分别词元化(因语法规则不同,拆分逻辑可能差异,如中文需用分词工具而非空格)。
4. 词表构建(d2l.Vocab)
- 目标:将词元映射为整数索引(模型仅能处理数值输入)。
- 关键设计:
- 特殊标记:
<unk>:未知词(处理训练集中未出现的词);<pad>:填充标记(统一序列长度);<bos>/<eos>:序列开始 / 结束标记(帮助模型识别句子边界);
- 过滤低频词:如
min_freq=2(仅保留出现≥2 次的词元,减少词表大小,提升泛化)。
- 特殊标记:
- 示例:英语词表中 “i”→3,“love”→5;法语词表中 “je”→2,“t'aime”→7。
5. 序列标准化(truncate_pad和build_array_nmt函数)
- 目标:将所有序列长度统一为
num_steps(模型要求固定输入长度)。 - 操作:
- 截断:长于
num_steps的序列保留前num_steps个词元; - 填充:短于
num_steps的序列用<pad>补足; - 有效长度:记录每个序列的实际长度(不含
<pad>),用于过滤无效计算(如损失函数忽略填充部分)。
- 截断:长于
6. 批次生成(load_data_nmt函数)
- 目标:将数据按
batch_size分组,生成可直接输入模型的张量。 - 输出格式:每个批次含 4 个张量:
X:源语言序列(如英语),形状[batch_size, num_steps];X_valid_len:源序列有效长度,形状[batch_size];Y:目标语言序列(如法语),形状[batch_size, num_steps];Y_valid_len:目标序列有效长度,形状[batch_size]。
二、完整代码
"""
文件名: 9.5 机器翻译与数据集
作者: 墨尘
日期: 2025/7/16
项目名: dl_env
备注:
"""
import matplotlib.pyplot as plt
import os
import torch
from d2l import torch as d2l  # 导入d2l库的PyTorch工具函数


# ---------------------------------------------------------------------------下载和预处理数据集--------------------------------------------
# @save  # 标记为可保存的函数(d2l库特性,便于后续调用)
def read_data_nmt():
    """载入“英语-法语”平行语料库(机器翻译任务的标准数据集)"""
    # 下载并解压数据集:'fra-eng'是数据集名称,返回解压后的文件夹路径
    data_dir = d2l.download_extract('fra-eng')
    # 拼接文件路径:数据集文件夹下的'fra.txt'是英法对照文本
    # 每行格式为“英语句子\t法语句子”(制表符分隔)
    with open(os.path.join(data_dir, 'fra.txt'), 'r', encoding='utf-8') as f:
        return f.read()  # 返回整个文本内容(字符串形式)


# @save
def preprocess_nmt(text):
    """
    预处理“英语-法语”数据集,将文本规范化为模型可处理的格式
    机器翻译预处理的核心目标:统一格式,减少噪声,便于后续词元化
    """

    def no_space(char, prev_char):
        """
        判断当前字符是否需要在前面加空格(针对标点符号的特殊处理)
        规则:如果是标点符号(,.!?)且前一个字符不是空格,则需要加空格
        例如:"hello.world" → "hello . world"
        """
        return char in set(',.!?') and prev_char != ' '

    # 1. 替换特殊空格:
    # \u202f是窄不换行空格,\xa0是不换行空格,统一替换为普通空格
    # 2. 转为小写:将所有大写字母转为小写(如"Hello"→"hello"),减少词元数量
    text = text.replace('\u202f', ' ').replace('\xa0', ' ').lower()

    # 处理标点符号:为标点前添加空格(通过列表推导式遍历每个字符)
    # 逻辑:如果是标点且前一个字符不是空格,则在当前字符前加空格
    out = [' ' + char if i > 0 and no_space(char, text[i - 1]) else char
           for i, char in enumerate(text)]
    return ''.join(out)  # 将列表拼接为字符串


# ---------------------------------------------------------------------------词元化--------------------------------------------
# @save
def tokenize_nmt(text, num_examples=None):
    """
    词元化(Tokenization):将预处理后的文本拆分为最小语义单元(词元)
    机器翻译中需分别处理源语言(英语)和目标语言(法语)
    """
    source, target = [], []  # source存储英语词元列表,target存储法语词元列表
    # 按换行符分割文本,遍历每一行(每行是一对英法句子)
    for i, line in enumerate(text.split('\n')):
        # 如果指定了最大样本数,且当前行数超过,则停止处理(控制数据规模)
        if num_examples and i > num_examples:
            break
        # 按制表符分割一行文本:英语句子和法语句子用\t分隔
        parts = line.split('\t')
        # 确保每行确实包含两个部分(避免空行或格式错误的行)
        if len(parts) == 2:
            # 英语句子按空格分割为词元(如"hello world"→["hello", "world"])
            source.append(parts[0].split(' '))
            # 法语句子同理(如"bonjour monde"→["bonjour", "monde"])
            target.append(parts[1].split(' '))
    return source, target  # 返回两个列表:源语言词元列表和目标语言词元列表


# @save
def show_list_len_pair_hist(legend, xlabel, ylabel, xlist, ylist):
    """
    可视化源语言和目标语言的序列长度分布(直方图)
    机器翻译中需分析两种语言的句子长度关系,指导后续序列截断/填充参数设置
    """
    d2l.set_figsize()  # 设置图表大小(d2l库封装的matplotlib函数)
    # 绘制直方图:
    # xlist是源语言序列列表,ylist是目标语言序列列表
    # 对每个序列取长度,得到两个长度列表:[len(l) for l in xlist]和[len(l) for l in ylist]
    _, _, patches = d2l.plt.hist(
        [[len(l) for l in xlist], [len(l) for l in ylist]])
    d2l.plt.xlabel(xlabel)  # x轴标签:每个序列的词元数量
    d2l.plt.ylabel(ylabel)  # y轴标签:该长度的序列出现次数
    # 为第二个直方图(目标语言)添加斜线填充,区分两个分布
    for patch in patches[1].patches:
        patch.set_hatch('/')
    d2l.plt.legend(legend)  # 添加图例(源语言和目标语言)


# ---------------------------------------------------------------------------加载数据集--------------------------------------------
# @save
def truncate_pad(line, num_steps, padding_token):
    """
    截断或填充序列,使所有序列长度统一为num_steps(机器翻译模型要求固定输入长度)
    参数:
        line:原始序列(词元索引列表)
        num_steps:目标长度
        padding_token:填充标记(如<pad>的索引)
    """
    if len(line) > num_steps:
        return line[:num_steps]  # 序列过长:截断为前num_steps个词元
    else:
        # 序列过短:用填充标记补足到num_steps(填充在末尾)
        return line + [padding_token] * (num_steps - len(line))


# @save
def build_array_nmt(lines, vocab, num_steps):
    """
    将词元列表转换为模型可处理的张量(Tensor),是从文本到数值的关键步骤
    参数:
        lines:词元列表(如source或target)
        vocab:对应的词表(如src_vocab或tgt_vocab)
        num_steps:序列固定长度
    返回:
        array:形状为[样本数, num_steps]的张量(词元索引)
        valid_len:形状为[样本数]的张量(每个序列的有效长度,不含填充)
    """
    # 1. 词元→索引:将每个词元转换为词表中的整数索引
    # 例如:["hello", "world"] → [3, 5](假设词表中"hello"对应3,"world"对应5)
    lines = [vocab[l] for l in lines]  # vocab[l]是对列表l中的每个词元取索引

    # 2. 添加结束标记:每个序列末尾添加<eos>(end of sequence)标记的索引
    # 模型通过<eos>判断序列结束,例如:[3,5] → [3,5,2](假设<eos>对应2)
    lines = [l + [vocab['<eos>']] for l in lines]

    # 3. 统一长度:对每个序列进行截断或填充,确保长度为num_steps
    # 例如:长度为5的序列在num_steps=8时,填充3个<pad>
    array = torch.tensor([truncate_pad(
        l, num_steps, vocab['<pad>']) for l in lines])  # vocab['<pad>']是填充标记的索引

    # 4. 计算有效长度:每个序列中非填充标记的数量(即实际词元数+<eos>)
    # 例如:[3,5,2,0,0,0,0,0](0是<pad>)的有效长度为3
    valid_len = (array != vocab['<pad>']).type(torch.int32).sum(1)  # 按行求和
    return array, valid_len


# ---------------------------------------------------------------------------训练模型--------------------------------------------
# @save
def load_data_nmt(batch_size, num_steps, num_examples=600):
    """
    整合数据处理全流程,返回可直接用于训练的迭代器和词表
    机器翻译数据加载的核心函数,封装了从原始文本到批次张量的所有步骤
    参数:
        batch_size:每个批次的样本数量(一次训练的样本数)
        num_steps:序列固定长度(所有样本都会被处理为该长度)
        num_examples:使用的样本总数(默认600,可根据内存调整)
    返回:
        data_iter:数据迭代器,每次迭代返回一个批次的数据(X, X_valid_len, Y, Y_valid_len)
        src_vocab:源语言(英语)词表
        tgt_vocab:目标语言(法语)词表
    """
    # 1. 数据预处理流水线:读取→预处理→词元化
    text = preprocess_nmt(read_data_nmt())  # 读取并预处理文本
    source, target = tokenize_nmt(text, num_examples)  # 得到词元列表

    # 2. 构建词表(Vocabulary):
    # 词表是词元与整数索引的映射,用于将文本转换为数值
    # min_freq=2:过滤出现次数<2的低频词(视为罕见词,映射为<unk>)
    # reserved_tokens:预留特殊标记:
    #   <pad>:填充标记,<bos>:序列开始标记(begin of sequence),<eos>:序列结束标记
    src_vocab = d2l.Vocab(source, min_freq=2,
                          reserved_tokens=['<pad>', '<bos>', '<eos>'])  # 英语词表
    tgt_vocab = d2l.Vocab(target, min_freq=2,
                          reserved_tokens=['<pad>', '<bos>', '<eos>'])  # 法语词表

    # 3. 转换为张量:词元列表→索引序列→统一长度→计算有效长度
    src_array, src_valid_len = build_array_nmt(source, src_vocab, num_steps)  # 英语张量
    tgt_array, tgt_valid_len = build_array_nmt(target, tgt_vocab, num_steps)  # 法语张量

    # 4. 创建数据迭代器:
    # 将所有数据打包为元组,通过d2l.load_array创建迭代器
    # 迭代器会自动打乱数据、按batch_size分组,返回可直接输入模型的批次
    data_arrays = (src_array, src_valid_len, tgt_array, tgt_valid_len)
    data_iter = d2l.load_array(data_arrays, batch_size)  # 类似PyTorch的DataLoader
    return data_iter, src_vocab, tgt_vocab


# ---------------------------------------------------------------------------主函数--------------------------------------------
def main():
    # 注册数据集:告诉d2l库数据集的下载地址和校验码(确保下载正确)
    d2l.DATA_HUB['fra-eng'] = (d2l.DATA_URL + 'fra-eng.zip',
                               '94646ad1522d915e7b0f9296181140edcf86a4f5')

    # 1. 读取原始数据并展示
    raw_text = read_data_nmt()  # 读取未处理的原始文本
    print("原始数据样例:", raw_text[:75])  # 打印前75个字符(展示原始格式)

    # 2. 展示预处理后的数据
    text = preprocess_nmt(raw_text)  # 应用预处理(小写、标点处理等)
    print("预处理后样例:", text[:80])  # 打印前80个字符(对比预处理效果)

    # 3. 展示词元化结果
    source, target = tokenize_nmt(text)  # 词元化得到英语和法语词元列表
    print("词元化样例 - 英语:", source[:6])  # 打印前6个英语句子的词元
    print("词元化样例 - 法语:", target[:6])  # 打印前6个法语句子的词元

    # 4. 可视化序列长度分布(指导后续num_steps参数设置)
    show_list_len_pair_hist(
        ['source', 'target'],  # 图例:源语言(英语)、目标语言(法语)
        '# tokens per sequence',  # x轴:每个序列的词元数量
        'count',  # y轴:该长度的序列数量
        source, target  # 源语言和目标语言的词元列表
    )

    # 5. 构建并展示源语言词表
    src_vocab = d2l.Vocab(
        source,  # 基于英语词元构建
        min_freq=2,  # 过滤低频词
        reserved_tokens=['<pad>', '<bos>', '<eos>']  # 特殊标记
    )
    print(f"英语词表大小: {len(src_vocab)}")  # 词表大小=有效词元数+特殊标记数

    # 6. 展示截断/填充操作的效果
    # 以第一个英语句子为例:将其词元索引序列调整为长度10
    # src_vocab[source[0]]:将第一个英语句子的词元转换为索引
    # src_vocab['<pad>']:填充标记的索引
    print("截断/填充示例:", truncate_pad(src_vocab[source[0]], 10, src_vocab['<pad>']))

    # 7. 加载数据迭代器(核心步骤:得到可用于训练的批次数据)
    # batch_size=2:每个批次含2个样本
    # num_steps=8:每个序列固定长度为8
    train_iter, src_vocab, tgt_vocab = load_data_nmt(batch_size=2, num_steps=8)

    # 8. 展示一个批次的数据格式(机器翻译的输入输出格式)
    for X, X_valid_len, Y, Y_valid_len in train_iter:
        print('\n批次数据示例:')
        # X:源语言(英语)输入张量,形状[batch_size, num_steps]
        # 每个元素是词元在src_vocab中的索引
        print('X (英语输入):\n', X.type(torch.int32))
        # X_valid_len:每个英语序列的有效长度(不含填充),形状[batch_size]
        print('X的有效长度:', X_valid_len)
        # Y:目标语言(法语)目标张量,形状[batch_size, num_steps]
        # 每个元素是词元在tgt_vocab中的索引(模型需要预测的目标)
        print('Y (法语目标):\n', Y.type(torch.int32))
        # Y_valid_len:每个法语序列的有效长度,形状[batch_size]
        print('Y的有效长度:', Y_valid_len)
        break  # 只展示第一个批次

    plt.show()  # 保持图像窗口打开(matplotlib在脚本中需显式调用)


if __name__ == "__main__":
    main()  # 执行主函数
三、实验结果
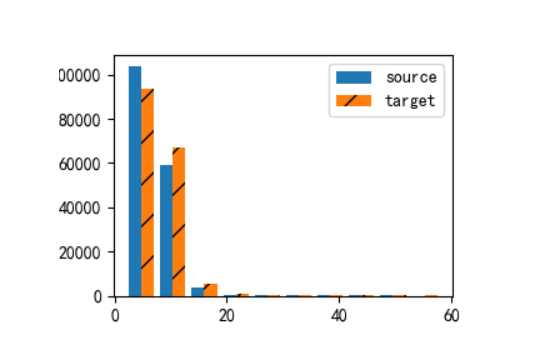
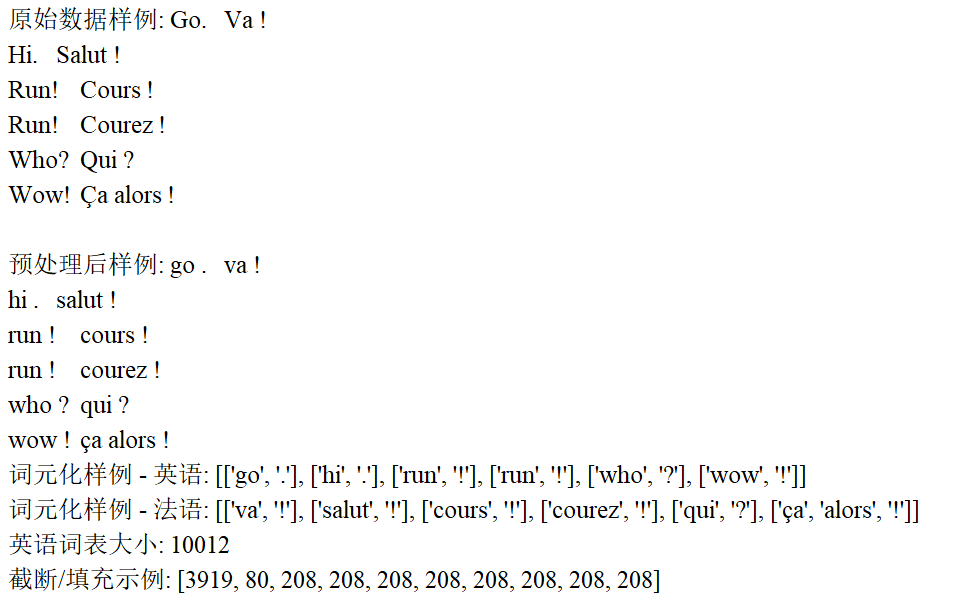
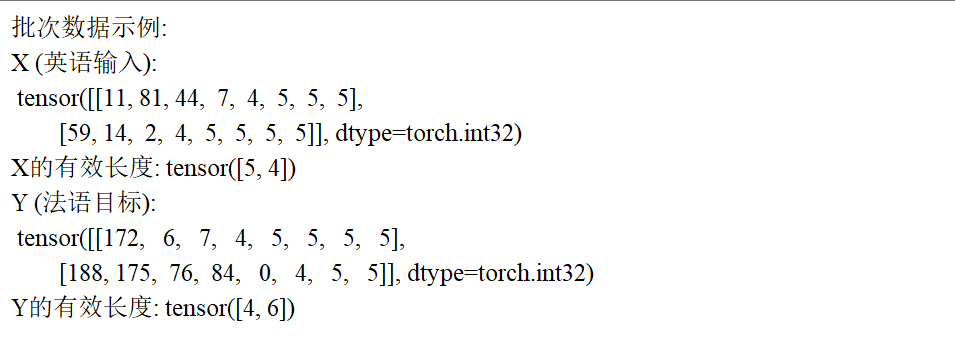 四、核心架构:编码器-解码器(encoder-decoder)架构
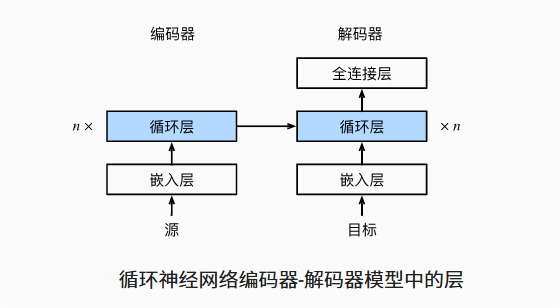
1. 编码器(Encoder)
- 作用:将输入序列(如源语言句子、语音波形)转换为一个固定长度的上下文向量(Context Vector),也称为 “语义向量”,其本质是对输入序列的 “语义压缩”。
- 输入:长度为n的输入序列
(如单词、语音帧)。
- 输出:一个向量c(通常是编码器最后一个时间步的隐藏状态),包含输入序列的整体语义信息。
举例:在机器翻译中,编码器接收英文句子 “我爱你” 的词向量序列,输出一个向量c,这个向量需要 “记住”“我”“爱”“你” 的语义和关系。
实现:早期编码器多用循环神经网络(RNN)的变体(LSTM 或 GRU),因为 RNN 天然适合处理序列数据(通过 “记忆” 前序信息)。例如,LSTM 编码器会逐词处理输入序列,每个时间步的隐藏状态依赖于前一步的隐藏状态
和当前输入
,最终输出最后一个隐藏状态作为上下文向量
。
2. 解码器(Decoder)
- 作用:根据编码器输出的上下文向量c,生成目标序列(如目标语言句子、摘要)。
- 输入:上下文向量c + 解码器自身的前序输出(生成序列的历史信息)。
- 输出:长度为m的目标序列
(如翻译后的单词、摘要的句子)。
举例:机器翻译中,解码器接收编码器的上下文向量c(包含 “我爱你” 的语义),先输出 “Je”(法语 “我”),再根据c和 “Je” 输出 “t'aime”(“爱你”),最终生成 “Je t'aime”。
实现:解码器也多用 LSTM/GRU,其初始隐藏状态由上下文向量c初始化,每个时间步的输出依赖于当前隐藏状态和前一步的输出
(或输入),通过 softmax 层预测下一个词的概率。
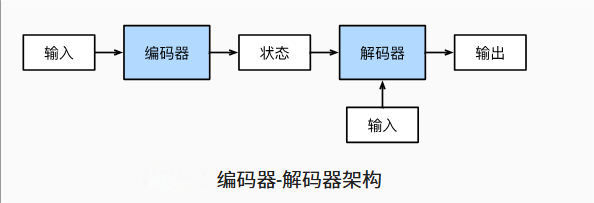
3.编码器-解码器(encoder-decoder)架构图
五、为什么需要 seq2seq?
传统的机器学习模型(如 CNN、普通 RNN)更擅长 “固定输入→固定输出” 的任务(如图片分类、单标签预测),但现实中存在大量 “序列→序列” 的转换需求,且输入和输出的长度往往不同:
- 机器翻译:输入 “Hello world”(2 个词),输出 “你好世界”(2 个词,长度相同但语言不同);输入 “我爱自然语言处理”(5 个词),输出 “I love natural language processing”(5 个词,长度相同);但更多时候长度不同(如 “今天天气真好,适合出去玩”→“It's a nice day today, perfect for going out”)。
- 文本摘要:输入一篇 1000 字的文章,输出 100 字的摘要(输入长、输出短)。
- 语音识别:输入一段 10 秒的语音波形(序列长度由采样率决定),输出对应的文字(长度由字数决定,通常更短)。
- 问答系统:输入 “李白的代表作有哪些?”(6 个词),输出 “《静夜思》《望庐山瀑布》等”(7 个词)。
这些任务的共性是 “输入和输出都是序列,且长度可变”,而 seq2seq 正是为解决这类问题设计的架构。
六、关键改进:注意力机制(Attention Mechanism)
早期的 seq2seq 存在一个严重缺陷:上下文向量c是固定长度的,当输入序列很长(如一篇长文章)时,c无法完整 “记住” 所有信息,导致输出序列质量下降(如翻译长句时漏译、错译)。
为解决这个问题,2014 年 Bahdanau 等人提出注意力机制,核心思想是:解码器在生成每个输出词时,不依赖固定的c,而是 “关注” 输入序列中与当前输出相关的部分。
注意力机制的原理
- 编码器不再只输出一个固定向量c,而是保留所有时间步的隐藏状态
(每个
对应输入序列的第i个元素)。
- 解码器生成第t个词时,计算当前隐藏状态
与编码器所有隐藏状态
(所有
- 用权重对H加权求和,得到上下文向量
(仅针对当前输出词
的上下文),再结合
举例:翻译 “我昨天去北京” 为英文时,解码器生成 “Beijing”(第 5 个词)时,注意力权重会集中在输入序列的 “北京”(第 4 个词)对应的上,即 “关注” 输入中与 “Beijing” 相关的部分。
七、主流模型:Transformer(基于自注意力)(见后文)
Transformer模型彻底改变了 seq2seq 架构:它完全抛弃了 RNN,改用自注意力机制(Self-Attention) 处理序列依赖,成为目前 NLP 的主流框架(如 BERT、GPT、T5 等均基于 Transformer)。
Transformer 的编码器 - 解码器结构
- 编码器:由N个相同的层堆叠而成,每层包含 “多头自注意力” 和 “前馈神经网络”。通过自注意力,编码器能捕捉输入序列内部的依赖关系(如 “我” 和 “爱” 的关系)。
- 解码器:也由N个相同的层堆叠而成,每层包含 “掩码多头自注意力”(防止关注未来的词)、“编码器 - 解码器注意力”(关注输入序列的相关部分)和 “前馈神经网络”。
优势:
- 并行计算:RNN 需按时间步顺序计算,而 Transformer 的自注意力可并行处理所有序列元素,训练速度更快。
- 长距离依赖:RNN 对长序列的远距离依赖捕捉能力弱(梯度消失),而自注意力通过直接计算任意两个元素的相关性,能更好处理长序列。
八、训练与推理
1. 训练过程
- 输入:输入序列X和对应的目标序列
- 目标:最大化条件概率
(通过交叉熵损失优化)。
- 技巧:使用 “教师强制(Teacher Forcing)”—— 解码器在训练时,输入的是真实的前序词
(而非自己生成的
),加速训练收敛。
2. 推理过程(生成输出序列)
训练完成后,需根据输入序列生成输出序列,常用束搜索(Beam Search)():
- 从初始状态(如
<START>符号)开始,每次生成多个候选词(如束宽为 2,保留概率最高的 2 个候选序列)。 - 重复生成,直到出现
<END>符号或达到最大长度,最终选择概率最高的序列作为输出。
九、完整代码
"""
文件名: 9.7
作者: 墨尘
日期: 2025/7/16
项目名: dl_env
备注:
"""
import collections
import math

# -------------------------- 基础工具库导入 --------------------------
import torch
from torch import nn
from d2l import torch as d2l
# 图像显示相关库(解决中文和符号显示问题)
import matplotlib.pyplot as plt
import matplotlib.text as text


# -------------------------- 核心解决方案:解决文本显示问题 --------------------------
def replace_minus(s):
    """
    解决Matplotlib中Unicode减号(U+2212)显示为方块的问题
    原理:将特殊减号替换为普通ASCII减号('-'),确保所有环境都能正常显示
    """
    if isinstance(s, str):  # 仅处理字符串类型
        return s.replace('\u2212', '-')  # 替换Unicode减号为ASCII减号
    return s  # 非字符串直接返回


# 重写matplotlib的Text类的set_text方法,实现全局生效
original_set_text = text.Text.set_text  # 保存原始方法(避免覆盖后无法恢复)


def new_set_text(self, s):
    s = replace_minus(s)  # 先处理减号
    return original_set_text(self, s)  # 调用原始方法设置文本


text.Text.set_text = new_set_text  # 应用重写后的方法(所有文本显示都会经过此处理)

# -------------------------- 字体配置(确保中文和数学符号正常显示)--------------------------
plt.rcParams["font.family"] = ["SimHei"]  # 设置中文字体(SimHei支持中文显示,避免中文乱码)
plt.rcParams["text.usetex"] = True  # 使用LaTeX渲染文本(提升数学符号显示美观度)
plt.rcParams["axes.unicode_minus"] = True  # 确保负号正确显示(避免负号显示为方块)
plt.rcParams["mathtext.fontset"] = "cm"  # 数学符号使用Computer Modern字体(LaTeX标准字体,更专业)
d2l.plt.rcParams.update(plt.rcParams)  # 让d2l库的绘图工具继承上述配置(保持显示一致性)


#---------------------------------------------------------------编码器--------------------------------------------
#@save
class Seq2SeqEncoder(d2l.Encoder):
    """用于序列到序列学习的循环神经网络编码器"""
    def __init__(self, vocab_size, embed_size, num_hiddens, num_layers,
                 dropout=0, **kwargs):
        super(Seq2SeqEncoder, self).__init__(** kwargs)
        # 嵌入层:将词索引转换为词向量
        self.embedding = nn.Embedding(vocab_size, embed_size)
        # GRU层:处理序列并提取特征
        self.rnn = nn.GRU(embed_size, num_hiddens, num_layers,
                          dropout=dropout)

    def forward(self, X, *args):
        # 输入X形状:(batch_size, num_steps)
        # 输出'X'的形状:(batch_size, num_steps, embed_size)
        X = self.embedding(X)
        # 在循环神经网络模型中,第一个轴对应于时间步
        # 转换为:(num_steps, batch_size, embed_size)
        X = X.permute(1, 0, 2)
        # 如果未提及状态,则默认为0
        output, state = self.rnn(X)
        # output的形状:(num_steps, batch_size, num_hiddens)
        # state的形状:(num_layers, batch_size, num_hiddens)
        return output, state

# ---------------------------------------------------------------解码器--------------------------------------------
class Seq2SeqDecoder(d2l.Decoder):
    """用于序列到序列学习的循环神经网络解码器"""
    def __init__(self, vocab_size, embed_size, num_hiddens, num_layers,
                 dropout=0, **kwargs):
        super(Seq2SeqDecoder, self).__init__(** kwargs)
        # 嵌入层:将目标语言词索引转换为词向量
        self.embedding = nn.Embedding(vocab_size, embed_size)
        # GRU层:结合编码器状态和当前输入生成输出
        self.rnn = nn.GRU(embed_size + num_hiddens, num_hiddens, num_layers,
                          dropout=dropout)
        # 全连接层:将隐藏状态映射到词汇表大小的输出空间
        self.dense = nn.Linear(num_hiddens, vocab_size)

    def init_state(self, enc_outputs, *args):
        # 从编码器输出中提取初始状态
        return enc_outputs[1]

    def forward(self, X, state):
        # 输入X形状:(batch_size, num_steps)
        # 输出'X'的形状:(batch_size, num_steps, embed_size)
        X = self.embedding(X).permute(1, 0, 2)
        # 广播context,使其具有与X相同的num_steps
        context = state[-1].repeat(X.shape[0], 1, 1)
        # 结合输入嵌入和上下文向量
        X_and_context = torch.cat((X, context), 2)
        # 通过GRU处理序列
        output, state = self.rnn(X_and_context, state)
        # 转换回(batch_size, num_steps, vocab_size)的形状
        output = self.dense(output).permute(1, 0, 2)
        # output的形状:(batch_size, num_steps, vocab_size)
        # state的形状:(num_layers, batch_size, num_hiddens)
        return output, state

# ---------------------------------------------------------------损失函数相关--------------------------------------------
# 修复缩进:将sequence_mask定义为全局函数,而非Seq2SeqDecoder的内部方法
def sequence_mask(X, valid_len, value=0):
    """在序列中屏蔽不相关的项"""
    maxlen = X.size(1)
    # 创建掩码矩阵,标记有效位置
    mask = torch.arange((maxlen), dtype=torch.float32,
                        device=X.device)[None, :] < valid_len[:, None]
    # 将无效位置填充为指定值
    X[~mask] = value
    return X

#@save
class MaskedSoftmaxCELoss(nn.CrossEntropyLoss):
    """带遮蔽的softmax交叉熵损失函数"""
    # pred的形状:(batch_size, num_steps, vocab_size)
    # label的形状:(batch_size, num_steps)
    # valid_len的形状:(batch_size,)
    def forward(self, pred, label, valid_len):
        # 创建权重矩阵,初始全为1
        weights = torch.ones_like(label)
        # 应用序列掩码,将无效位置权重设为0
        weights = sequence_mask(weights, valid_len)
        self.reduction='none'
        # 计算未加权的交叉熵损失
        unweighted_loss = super(MaskedSoftmaxCELoss, self).forward(
            pred.permute(0, 2, 1), label)  # 调整维度以匹配CrossEntropyLoss要求
        # 应用权重并计算平均损失
        weighted_loss = (unweighted_loss * weights).mean(dim=1)
        return weighted_loss

# ---------------------------------------------------------------训练--------------------------------------------
# @save
def train_seq2seq(net, data_iter, lr, num_epochs, tgt_vocab, device):
    """训练序列到序列模型"""

    def xavier_init_weights(m):
        """使用Xavier初始化方法初始化模型权重"""
        if type(m) == nn.Linear:
            nn.init.xavier_uniform_(m.weight)
        if type(m) == nn.GRU:
            for param in m._flat_weights_names:
                if "weight" in param:
                    nn.init.xavier_uniform_(m._parameters[param])

    # 应用权重初始化
    net.apply(xavier_init_weights)
    net.to(device)
    optimizer = torch.optim.Adam(net.parameters(), lr=lr)
    loss = MaskedSoftmaxCELoss()
    net.train()
    # 创建动画绘制器,用于可视化训练过程
    animator = d2l.Animator(xlabel='epoch', ylabel='loss',
                            xlim=[10, num_epochs])
    for epoch in range(num_epochs):
        timer = d2l.Timer()
        metric = d2l.Accumulator(2)  # 训练损失总和,词元数量
        for batch in data_iter:
            optimizer.zero_grad()
            # 获取批次数据并移至设备
            X, X_valid_len, Y, Y_valid_len = [x.to(device) for x in batch]
            # 准备解码器输入(添加<bos>标记并移除最后一个词元)
            bos = torch.tensor([tgt_vocab['<bos>']] * Y.shape[0],
                               device=device).reshape(-1, 1)
            dec_input = torch.cat([bos, Y[:, :-1]], 1)  # 强制教学

            # 前向传播
            encoder_output, encoder_state = net.encoder(X)
            decoder_state = net.decoder.init_state((encoder_output, encoder_state))
            decoder_output, _ = net.decoder(dec_input, decoder_state)

            # 确保Y_hat是三维张量 (batch_size, num_steps, vocab_size)
            Y_hat = decoder_output

            # 检查维度
            if Y_hat.dim() != 3:
                print(f"警告: Y_hat维度异常 - {Y_hat.shape}")
                # 尝试调整维度
                if Y_hat.dim() == 2:
                    Y_hat = Y_hat.unsqueeze(1)  # 添加序列维度

            # 计算带掩码的损失
            l = loss(Y_hat, Y, Y_valid_len)
            l.sum().backward()  # 损失函数的标量进行“反向传播”
            # 梯度裁剪,防止梯度爆炸
            d2l.grad_clipping(net, 1)
            # 计算当前批次中有效词元的总数
            num_tokens = Y_valid_len.sum()
            # 更新参数
            optimizer.step()
            with torch.no_grad():
                metric.add(l.sum(), num_tokens)
        # 每10个epoch更新一次动画
        if (epoch + 1) % 10 == 0:
            animator.add(epoch + 1, (metric[0] / metric[1],))
    print(f'loss {metric[0] / metric[1]:.3f}, {metric[1] / timer.stop():.1f} '
          f'tokens/sec on {str(device)}')


# ---------------------------------------------------------------预测 --------------------------------------------
#@save
def predict_seq2seq(net, src_sentence, src_vocab, tgt_vocab, num_steps,
                    device, save_attention_weights=False):
    """序列到序列模型的预测"""
    # 在预测时将net设置为评估模式
    net.eval()
    # 预处理输入句子,转换为词元索引并添加<eos>标记
    src_tokens = src_vocab[src_sentence.lower().split(' ')] + [
        src_vocab['<eos>']]
    # 计算有效长度
    enc_valid_len = torch.tensor([len(src_tokens)], device=device)
    # 截断或填充到固定长度
    src_tokens = d2l.truncate_pad(src_tokens, num_steps, src_vocab['<pad>'])
    # 添加批量轴
    enc_X = torch.unsqueeze(
        torch.tensor(src_tokens, dtype=torch.long, device=device), dim=0)
    # 通过编码器处理输入
    enc_outputs = net.encoder(enc_X, enc_valid_len)
    # 初始化解码器状态
    dec_state = net.decoder.init_state(enc_outputs, enc_valid_len)
    # 添加批量轴,初始输入为<bos>标记
    dec_X = torch.unsqueeze(torch.tensor(
        [tgt_vocab['<bos>']], dtype=torch.long, device=device), dim=0)
    output_seq, attention_weight_seq = [], []
    # 逐词生成翻译结果
    for _ in range(num_steps):
        Y, dec_state = net.decoder(dec_X, dec_state)
        # 我们使用具有预测最高可能性的词元,作为解码器在下一时间步的输入
        dec_X = Y.argmax(dim=2)
        pred = dec_X.squeeze(dim=0).type(torch.int32).item()
        # 保存注意力权重(稍后讨论)
        if save_attention_weights:
            attention_weight_seq.append(net.decoder.attention_weights)
        # 一旦序列结束词元被预测,输出序列的生成就完成了
        if pred == tgt_vocab['<eos>']:
            break
        output_seq.append(pred)
    # 将词元索引转换为文本
    return ' '.join(tgt_vocab.to_tokens(output_seq)), attention_weight_seq

# ---------------------------------------------------------------预测序列的评估--------------------------------------------
def bleu(pred_seq, label_seq, k):  #@save
    """计算BLEU (Bilingual Evaluation Understudy) 分数"""
    # 将预测和参考序列分词
    pred_tokens, label_tokens = pred_seq.split(' '), label_seq.split(' ')
    len_pred, len_label = len(pred_tokens), len(label_tokens)
    # 长度惩罚因子,防止过短的翻译获得过高分数
    score = math.exp(min(0, 1 - len_label / len_pred))
    # 计算n-gram匹配率,n从1到k
    for n in range(1, k + 1):
        num_matches, label_subs = 0, collections.defaultdict(int)
        # 统计参考序列中所有n-gram的出现次数
        for i in range(len_label - n + 1):
            label_subs[' '.join(label_tokens[i: i + n])] += 1
        # 统计预测序列中匹配的n-gram数量
        for i in range(len_pred - n + 1):
            if label_subs[' '.join(pred_tokens[i: i + n])] > 0:
                num_matches += 1
                label_subs[' '.join(pred_tokens[i: i + n])] -= 1
        # 更新分数,使用几何平均组合不同n-gram的匹配率
        score *= math.pow(num_matches / (len_pred - n + 1), math.pow(0.5, n))
    return score

def main():
    # 测试编码器解码器形状
    encoder = Seq2SeqEncoder(vocab_size=10, embed_size=8, num_hiddens=16,
                             num_layers=2)
    encoder.eval()
    X = torch.zeros((4, 7), dtype=torch.long)
    output, state = encoder(X)
    print("编码器输出形状:", output.shape)
    print("编码器状态形状:", state.shape)

    decoder = Seq2SeqDecoder(vocab_size=10, embed_size=8, num_hiddens=16,
                             num_layers=2)
    decoder.eval()
    state = decoder.init_state(encoder(X))
    output, state = decoder(X, state)
    print("解码器输出形状:", output.shape)
    print("解码器状态形状:", state.shape)

    # 测试序列掩码
    X = torch.tensor([[1, 2, 3], [4, 5, 6]])
    print("序列掩码测试1:\n", sequence_mask(X, torch.tensor([1, 2])))

    X = torch.ones(2, 3, 4)
    print("序列掩码测试2:\n", sequence_mask(X, torch.tensor([1, 2]), value=-1))

    # 测试损失函数
    loss = MaskedSoftmaxCELoss()
    print("损失函数测试:", loss(torch.ones(3, 4, 10), torch.ones((3, 4), dtype=torch.long), torch.tensor([4, 2, 0])))

    # 训练模型
    embed_size, num_hiddens, num_layers, dropout = 32, 32, 2, 0.1
    batch_size, num_steps = 64, 10
    lr, num_epochs, device = 0.005, 300, d2l.try_gpu()

    # 加载训练数据和词表
    train_iter, src_vocab, tgt_vocab = d2l.load_data_nmt(batch_size, num_steps)
    # 初始化编码器和解码器
    encoder = Seq2SeqEncoder(len(src_vocab), embed_size, num_hiddens, num_layers,
                             dropout)
    decoder = Seq2SeqDecoder(len(tgt_vocab), embed_size, num_hiddens, num_layers,
                             dropout)
    # 组合编码器和解码器为完整模型
    net = d2l.EncoderDecoder(encoder, decoder)
    # 训练模型
    train_seq2seq(net, train_iter, lr, num_epochs, tgt_vocab, device)
    # 显示训练过程的动画图(阻塞模式,确保图不闪退,便于观察)
    plt.show(block=True)

    # 测试翻译功能
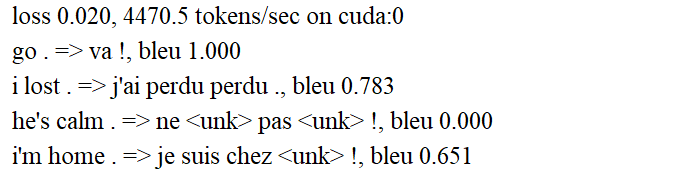
    engs = ['go .', "i lost .", 'he\'s calm .', 'i\'m home .']
    fras = ['va !', 'j\'ai perdu .', 'il est calme .', 'je suis chez moi .']
    for eng, fra in zip(engs, fras):
        translation, attention_weight_seq = predict_seq2seq(
            net, eng, src_vocab, tgt_vocab, num_steps, device)
        # 计算BLEU分数评估翻译质量
        print(f'{eng} => {translation}, bleu {bleu(translation, fra, k=2):.3f}')

if __name__ == '__main__':
    main()
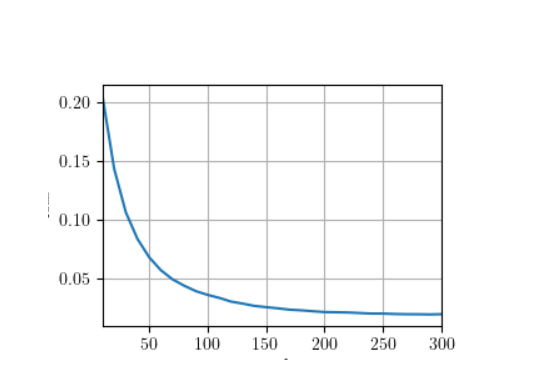
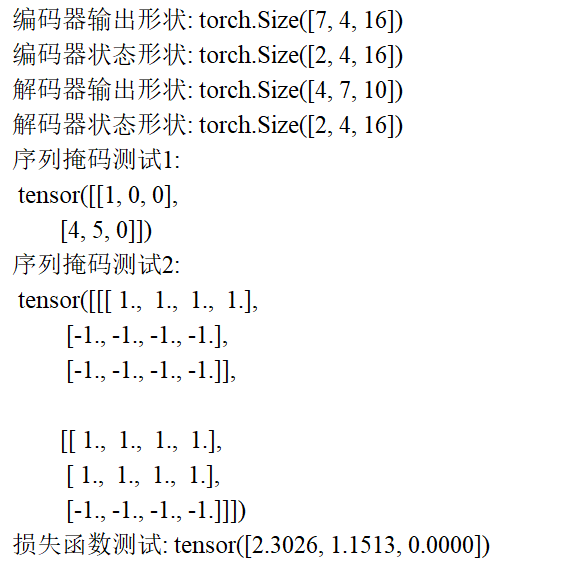
十、实验结果
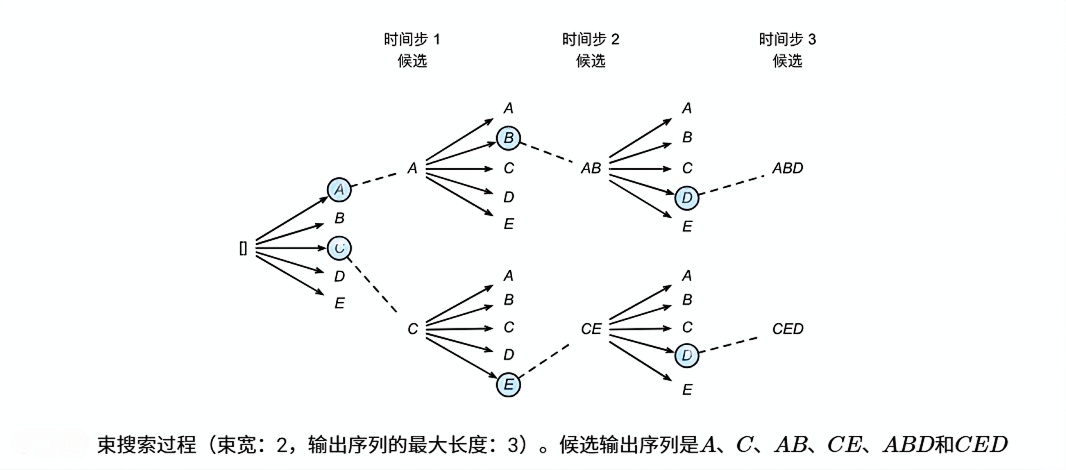
十一、束搜索的基本概念与定位
在序列生成任务中(如用模型生成句子 “我爱自然语言处理”),模型需要从第一个词开始,逐步预测下一个词,直到生成结束符(如<EOS>)或达到最大长度。此时的核心问题是:如何从所有可能的序列中,找到概率最高(最合理)的序列?
束搜索是解决这一问题的折中方案,其定位可通过对比另外两种极端策略理解:
- 穷举搜索(Exhaustive Search):遍历所有可能的序列(如词汇表大小为 V,长度为 T 的序列有 V^T 种可能),选择概率最高的。但计算量随序列长度呈指数增长,完全不可行。
- 贪婪搜索(Greedy Search):每次只选择当前概率最高的下一个词(如第一步选概率最高的词 1,第二步基于词 1 选概率最高的词 2,以此类推)。计算量小,但可能陷入 “局部最优”(如某一步选了次优词,后续却能生成更优整体序列)。
束搜索通过引入束宽(beam size,记为 k),每次保留概率最高的 k 个候选序列,逐步扩展并筛选,兼顾了搜索质量和计算效率。
十二、束搜索的工作原理与步骤
束搜索的核心逻辑是:“逐步扩展候选序列,始终保留 top-k 个最优选项”。以下用一个具体例子(生成句子,词汇表为 {“我”“爱”“吃”“苹果”“香蕉”“<EOS>”},束宽 k=2)说明步骤:
步骤 1:初始化候选序列
- 起始状态:假设模型生成第一个词的概率分布为:
P (“我”)=0.5,P (“爱”)=0.3,P (“吃”)=0.2,其余词概率为 0。 - 筛选:保留概率最高的 k=2 个候选序列,即:
候选集 = [“我”(概率 0.5),“爱”(概率 0.3)]
步骤 2:扩展候选序列
基于当前候选集,为每个序列扩展下一个词(计算条件概率):
- 对于序列 “我”,模型预测下一个词的条件概率(如):
P (“爱”|“我”)=0.6,P (“吃”|“我”)=0.4。
扩展后序列及概率:
“我→爱”(0.5×0.6=0.3),“我→吃”(0.5×0.4=0.2)。 - 对于序列 “爱”,模型预测下一个词的条件概率(如):
P (“我”|“爱”)=0.1,P (“吃”|“爱”)=0.7。
扩展后序列及概率:
“爱→我”(0.3×0.1=0.03),“爱→吃”(0.3×0.7=0.21)。
步骤 3:筛选新候选集
将所有扩展后的序列(共 4 个)按概率排序,保留 top-k=2 个:
- 排序结果:“我→爱”(0.3)>“爱→吃”(0.21)>“我→吃”(0.2)>“爱→我”(0.03)。
- 新候选集 = [“我→爱”(0.3),“爱→吃”(0.21)]。
步骤 4:重复扩展与筛选,直到终止
- 继续基于新候选集扩展下一个词(如 “我→爱” 可能扩展出 “我→爱→苹果”“我→爱→香蕉” 等),再筛选 top-k 个。
- 终止条件:候选序列中出现结束符
<EOS>,或达到预设最大长度(如 20 个词)。 - 最终输出:所有终止序列中,概率最高的那个(如 “我→爱→苹果→<EOS>”)。
十三、关键参数与优化
束搜索的效果高度依赖参数设置,核心参数及优化方式如下:
1. 束宽 k(核心参数)
- 作用:控制每次保留的候选序列数量。
- 影响:
- k 太小(如 k=1):退化为贪婪搜索,易错过更优序列。
- k 太大(如 k=100):计算量显著增加(每次扩展需处理 k×V 个候选,V 为词汇表大小),但可能找到更优序列。
- 实践取值:平衡计算成本和质量,常用 k=5~10(如机器翻译中 k=5,文本摘要中 k=10)。
2. 长度惩罚(Length Penalty)
- 问题:模型可能倾向于生成短序列(因为短序列的概率乘积更高,如 “我吃” 比 “我吃苹果” 的概率乘积可能更大,但语义不完整)。
- 解决方案:通过长度惩罚调整序列评分,对长序列给予更高权重。公式示例:
调整后分数 = (序列对数概率和) / (序列长度 ^α)
(α 为惩罚系数,通常取 0.5~1.0,α 越大对长序列惩罚越轻) - 应用:机器翻译(避免译文过短)、文本摘要(保证信息完整)等任务中必用。
3. 对数概率计算
- 原因:序列概率是各词条件概率的乘积(如 P (序列)=P (w1)×P (w2|w1)×...×P (wT|w1...wT-1)),但概率乘积易因数值过小导致 “下溢”(如 0.1^20≈1e-20)。
- 优化:用对数概率相加替代乘积(log (a×b)=log a + log b),既避免下溢,又简化计算(加法比乘法高效)。
十四、变种与扩展
- 带热度的束搜索(Temperature Scaling + Beam Search):先通过 “热度参数” 调整词概率分布(如降低低概率词的权重),再进行束搜索,减少重复序列。
- 双向束搜索(Bidirectional Beam Search):从序列开头和结尾同时进行束搜索,在中间汇合,适合长序列生成(如文档级翻译)。
- 分层束搜索(Hierarchical Beam Search):先生成句子框架(如短语),再填充细节,减少搜索空间(适合结构化文本生成)。
十五、优缺点总结
| 优点 | 缺点 |
|---|---|
| 比贪婪搜索更可能找到全局较优序列 | 仍非全局最优(可能错过 k 之外的更优候选) |
| 计算量远小于穷举搜索,可落地 | 束宽 k 需调参(无通用最优值) |
| 结合长度惩罚后,生成序列更合理 | 可能生成重复或逻辑断层的序列(需额外去重逻辑) |
十六、束搜索结构图
十七、完整代码
"""
文件名: 9.8束搜索
作者: 墨尘
日期: 2025/7/16
项目名: dl_env
备注: 基于Seq2Seq的机器翻译模型,包含束搜索解码策略,用于生成更优的翻译结果
"""
import collections
import math
import torch
from torch import nn
from d2l import torch as d2l
import matplotlib.pyplot as plt
import matplotlib.text as text


# -------------------------- 核心解决方案:解决文本显示问题 --------------------------
def replace_minus(s):
    """
    解决Matplotlib中Unicode减号(U+2212)显示为方块的问题
    原理:将特殊减号替换为普通ASCII减号('-'),确保所有环境都能正常显示
    """
    if isinstance(s, str):  # 仅处理字符串类型
        return s.replace('\u2212', '-')  # 替换Unicode减号为ASCII减号
    return s  # 非字符串直接返回


# 重写matplotlib的Text类的set_text方法,实现全局生效
original_set_text = text.Text.set_text  # 保存原始方法(避免覆盖后无法恢复)


def new_set_text(self, s):
    s = replace_minus(s)  # 先处理减号
    return original_set_text(self, s)  # 调用原始方法设置文本


text.Text.set_text = new_set_text  # 应用重写后的方法(所有文本显示都会经过此处理)

# -------------------------- 字体配置(确保中文和数学符号正常显示)--------------------------
plt.rcParams["font.family"] = ["SimHei"]  # 设置中文字体(避免中文乱码)
plt.rcParams["text.usetex"] = True  # 使用LaTeX渲染文本(提升数学符号显示效果)
plt.rcParams["axes.unicode_minus"] = True  # 确保负号正确显示
plt.rcParams["mathtext.fontset"] = "cm"  # 数学符号使用Computer Modern字体(LaTeX标准)
d2l.plt.rcParams.update(plt.rcParams)  # 让d2l库的绘图工具继承上述配置


#---------------------------------------------------------------编码器--------------------------------------------
#@save
class Seq2SeqEncoder(d2l.Encoder):
    """用于序列到序列学习的循环神经网络编码器"""
    def __init__(self, vocab_size, embed_size, num_hiddens, num_layers,
                 dropout=0, **kwargs):
        super(Seq2SeqEncoder, self).__init__(** kwargs)
        # 嵌入层:将词索引转换为稠密词向量(解决离散词元的稀疏性问题)
        self.embedding = nn.Embedding(vocab_size, embed_size)
        # GRU层:处理序列数据,捕捉上下文依赖关系
        # 输入维度=词嵌入维度,隐藏层维度=num_hiddens,层数=num_layers
        self.rnn = nn.GRU(embed_size, num_hiddens, num_layers,
                          dropout=dropout)

    def forward(self, X, *args):
        # 输入X形状:(batch_size, num_steps),其中num_steps是序列长度
        # 词嵌入后形状:(batch_size, num_steps, embed_size)
        X = self.embedding(X)
        # GRU要求输入形状为(num_steps, batch_size, embed_size),故调整维度顺序
        X = X.permute(1, 0, 2)
        # 前向传播:output为所有时间步的隐藏状态,state为最后一层的隐藏状态和细胞状态
        output, state = self.rnn(X)
        # output形状:(num_steps, batch_size, num_hiddens)
        # state形状:(num_layers, batch_size, num_hiddens)(GRU返回(h_n,),LSTM返回(h_n, c_n))
        return output, state


# ---------------------------------------------------------------解码器--------------------------------------------
class Seq2SeqDecoder(d2l.Decoder):
    """用于序列到序列学习的循环神经网络解码器"""
    def __init__(self, vocab_size, embed_size, num_hiddens, num_layers,
                 dropout=0, **kwargs):
        super(Seq2SeqDecoder, self).__init__(** kwargs)
        # 嵌入层:目标语言词索引→词向量
        self.embedding = nn.Embedding(vocab_size, embed_size)
        # GRU层:输入=目标词嵌入+编码器上下文向量(维度=embed_size + num_hiddens)
        self.rnn = nn.GRU(embed_size + num_hiddens, num_hiddens, num_layers,
                          dropout=dropout)
        # 全连接层:将隐藏状态映射到目标词表大小(预测下一个词的概率分布)
        self.dense = nn.Linear(num_hiddens, vocab_size)

    def init_state(self, enc_outputs, *args):
        # 用编码器的最终状态初始化解码器(确保上下文信息传递)
        return enc_outputs[1]

    def forward(self, X, state):
        # 输入X形状:(batch_size, num_steps)
        # 词嵌入后形状:(batch_size, num_steps, embed_size),调整为GRU要求的(num_steps, batch_size, embed_size)
        X = self.embedding(X).permute(1, 0, 2)
        # 上下文向量:取编码器最后一层的隐藏状态,广播到与X相同的时间步长度
        # state[-1]形状:(batch_size, num_hiddens),repeat后为(num_steps, batch_size, num_hiddens)
        context = state[-1].repeat(X.shape[0], 1, 1)
        # 拼接目标词嵌入和上下文向量(融合当前输入与全局上下文)
        X_and_context = torch.cat((X, context), 2)  # 形状:(num_steps, batch_size, embed_size + num_hiddens)
        # 解码器前向传播:输出为所有时间步的隐藏状态,state为更新后的状态
        output, state = self.rnn(X_and_context, state)
        # 映射到词表空间,并调整为(batch_size, num_steps, vocab_size)
        output = self.dense(output).permute(1, 0, 2)
        return output, state


# ---------------------------------------------------------------损失函数相关--------------------------------------------
def sequence_mask(X, valid_len, value=0):
    """在序列中屏蔽不相关的填充项(仅计算有效词元的损失)"""
    maxlen = X.size(1)  # 序列最大长度(含填充)
    # 创建掩码矩阵:shape=(batch_size, maxlen),有效位置为True,填充位置为False
    mask = torch.arange((maxlen), dtype=torch.float32,
                        device=X.device)[None, :] < valid_len[:, None]
    X[~mask] = value  # 将填充位置的值设为指定值(如0)
    return X


class MaskedSoftmaxCELoss(nn.CrossEntropyLoss):
    """带遮蔽的交叉熵损失函数(忽略填充项对损失的影响)"""
    # pred形状:(batch_size, num_steps, vocab_size) → 模型预测的词概率分布
    # label形状:(batch_size, num_steps) → 真实标签
    # valid_len形状:(batch_size,) → 每个序列的有效长度(不含填充)
    def forward(self, pred, label, valid_len):
        weights = torch.ones_like(label)  # 初始化权重矩阵(全1)
        weights = sequence_mask(weights, valid_len)  # 有效位置权重为1,填充位置为0
        self.reduction = 'none'  # 不自动缩减,保留每个位置的损失
        # CrossEntropyLoss要求输入形状为(batch_size, vocab_size, num_steps),故调整维度
        unweighted_loss = super(MaskedSoftmaxCELoss, self).forward(
            pred.permute(0, 2, 1), label)
        # 加权平均:仅对有效位置的损失求和,再除以有效长度
        weighted_loss = (unweighted_loss * weights).mean(dim=1)
        return weighted_loss


# ---------------------------------------------------------------束搜索(Beam Search)实现--------------------------------------------
def beam_search(net, src_sentence, src_vocab, tgt_vocab, num_steps, device,
                beam_size=3, save_attention_weights=False):
    """
    束搜索:生成序列时保留概率最高的beam_size个候选序列,提升生成质量
    参数:
        net:训练好的seq2seq模型
        src_sentence:输入的源语言句子(字符串)
        src_vocab/tgt_vocab:源/目标语言词表
        num_steps:最大生成长度
        device:计算设备
        beam_size:束宽(保留的候选序列数量,k=3~5常用)
        save_attention_weights:是否保存注意力权重
    返回:
        最优生成序列(字符串)、注意力权重列表
    """
    net.eval()  # 模型设为评估模式(关闭dropout等)
    # 1. 预处理输入句子:转为词元索引→添加<eos>→截断/填充→转为张量
    src_tokens = src_vocab[src_sentence.lower().split(' ')] + [src_vocab['<eos>']]
    enc_valid_len = torch.tensor([len(src_tokens)], device=device)  # 编码器有效长度
    src_tokens = d2l.truncate_pad(src_tokens, num_steps, src_vocab['<pad>'])  # 统一长度
    enc_X = torch.unsqueeze(torch.tensor(src_tokens, dtype=torch.long, device=device), dim=0)  # 加batch维度

    # 2. 编码器处理输入,获取初始状态
    with torch.no_grad():  # 推理时不计算梯度
        enc_outputs = net.encoder(enc_X, enc_valid_len)
    dec_state = net.decoder.init_state(enc_outputs, enc_valid_len)  # 解码器初始状态

    # 3. 初始化束搜索候选集:每个候选为(序列词元索引, 累积对数概率, 解码器状态, 注意力权重)
    # 初始序列为[<bos>],累积概率为0.0(log(1)=0)
    bos = torch.tensor([tgt_vocab['<bos>']], device=device)
    candidates = [( [bos.item()], 0.0, dec_state, [] )]  # 列表存储候选序列
    attention_weight_seq = []  # 存储注意力权重(如需)

    # 4. 逐步扩展候选序列
    for _ in range(num_steps):
        new_candidates = []  # 存储当前步扩展后的所有候选
        for seq, log_prob, state, attn in candidates:
            # 若序列已包含<eos>,直接保留(不再扩展)
            if seq[-1] == tgt_vocab['<eos>']:
                new_candidates.append( (seq, log_prob, state, attn) )
                continue

            # 以当前序列的最后一个词作为解码器输入(形状:(1, 1),加batch维度)
            dec_X = torch.unsqueeze(torch.tensor([seq[-1]], dtype=torch.long, device=device), dim=0)
            # 解码器前向传播:获取下一个词的概率分布
            with torch.no_grad():
                Y, new_state = net.decoder(dec_X, state)
                if save_attention_weights:
                    attention_weight_seq.append(net.decoder.attention_weights)

            # 计算下一个词的对数概率(避免数值下溢,用对数概率累加)
            log_probs = torch.log_softmax(Y[0, 0, :], dim=0)  # Y[0,0,:]为当前步的词概率分布
            # 取概率最高的beam_size个词作为候选扩展
            top_vals, top_indices = torch.topk(log_probs, beam_size)  # 前beam_size个最高概率的词

            # 扩展候选序列:为每个候选添加新词,并更新累积概率
            for val, idx in zip(top_vals, top_indices):
                new_seq = seq + [idx.item()]  # 扩展序列
                new_log_prob = log_prob + val.item()  # 累积对数概率(log(a*b)=log(a)+log(b))
                new_candidates.append( (new_seq, new_log_prob, new_state, attn) )

        # 5. 筛选候选:保留总概率最高的beam_size个序列
        # 按累积对数概率降序排序(值越大,概率越高)
        sorted_candidates = sorted(new_candidates, key=lambda x: x[1], reverse=True)
        # 截取前beam_size个候选
        candidates = sorted_candidates[:beam_size]

        # 6. 若所有候选都已包含<eos>,提前终止
        if all(seq[-1] == tgt_vocab['<eos>'] for seq, _, _, _ in candidates):
            break

    # 7. 选择最优序列:从候选中取概率最高的序列(若有<eos>则截断)
    best_seq, best_log_prob, _, _ = candidates[0]
    # 截断<eos>后的部分
    if tgt_vocab['<eos>'] in best_seq:
        eos_idx = best_seq.index(tgt_vocab['<eos>'])
        best_seq = best_seq[:eos_idx]

    # 转换为目标语言词元字符串
    return ' '.join(tgt_vocab.to_tokens(best_seq)), attention_weight_seq


# ---------------------------------------------------------------预测函数(调用束搜索)--------------------------------------------
def predict_seq2seq(net, src_sentence, src_vocab, tgt_vocab, num_steps, device,
                    beam_size=3, save_attention_weights=False):
    """序列到序列模型的预测接口(封装束搜索)"""
    translation, attention_weights = beam_search(
        net, src_sentence, src_vocab, tgt_vocab, num_steps, device,
        beam_size, save_attention_weights
    )
    return translation, attention_weights


# ---------------------------------------------------------------训练函数--------------------------------------------
def train_seq2seq(net, data_iter, lr, num_epochs, tgt_vocab, device):
    """训练序列到序列模型"""
    # 权重初始化:Xavier初始化(适合激活函数为tanh/sigmoid的场景)
    def xavier_init_weights(m):
        if type(m) == nn.Linear:
            nn.init.xavier_uniform_(m.weight)  # 线性层权重初始化
        if type(m) == nn.GRU:
            for param in m._flat_weights_names:
                if "weight" in param:
                    nn.init.xavier_uniform_(m._parameters[param])  # GRU权重初始化

    net.apply(xavier_init_weights)  # 应用初始化
    net.to(device)  # 模型移至设备
    optimizer = torch.optim.Adam(net.parameters(), lr=lr)  # Adam优化器
    loss = MaskedSoftmaxCELoss()  # 带遮蔽的损失函数
    net.train()  # 训练模式
    animator = d2l.Animator(xlabel='epoch', ylabel='loss', xlim=[10, num_epochs])  # 可视化训练损失

    for epoch in range(num_epochs):
        timer = d2l.Timer()  # 计时
        metric = d2l.Accumulator(2)  # 累加器:(总损失, 总有效词元数)
        for batch in data_iter:
            optimizer.zero_grad()  # 清除梯度
            # 批量数据移至设备
            X, X_valid_len, Y, Y_valid_len = [x.to(device) for x in batch]
            # 解码器输入:在目标序列前添加<bos>,并移除最后一个词(强制教学)
            bos = torch.tensor([tgt_vocab['<bos>']] * Y.shape[0], device=device).reshape(-1, 1)
            dec_input = torch.cat([bos, Y[:, :-1]], 1)  # 形状:(batch_size, num_steps)

            # 前向传播:编码器→解码器
            encoder_output, encoder_state = net.encoder(X)
            decoder_state = net.decoder.init_state((encoder_output, encoder_state))
            decoder_output, _ = net.decoder(dec_input, decoder_state)
            Y_hat = decoder_output  # 模型预测的目标序列

            # 计算损失
            l = loss(Y_hat, Y, Y_valid_len)
            l.sum().backward()  # 损失求和并反向传播
            d2l.grad_clipping(net, 1)  # 梯度裁剪(防止梯度爆炸)
            num_tokens = Y_valid_len.sum()  # 有效词元总数(用于计算平均损失)
            optimizer.step()  # 更新参数

            # 累加损失和词元数
            with torch.no_grad():
                metric.add(l.sum(), num_tokens)

        # 每10轮可视化损失
        if (epoch + 1) % 10 == 0:
            animator.add(epoch + 1, (metric[0] / metric[1],))  # 平均损失=总损失/总词元数

    # 输出训练结果
    print(f'最终损失: {metric[0] / metric[1]:.3f}')
    print(f'训练速度: {metric[1] / timer.stop():.1f} tokens/sec on {str(device)}')


# ---------------------------------------------------------------BLEU评分(评估翻译质量)--------------------------------------------
def bleu(pred_seq, label_seq, k):
    """
    计算BLEU(Bilingual Evaluation Understudy)评分:评估机器翻译质量
    基于n-gram(n=1~k)的匹配率,结合长度惩罚(避免过短翻译)
    """
    pred_tokens, label_tokens = pred_seq.split(' '), label_seq.split(' ')
    len_pred, len_label = len(pred_tokens), len(label_tokens)
    # 长度惩罚:若预测序列过短,分数降低(exp(1 - 参考长度/预测长度),最大为1)
    score = math.exp(min(0, 1 - len_label / len_pred))

    # 计算1~k-gram的匹配率
    for n in range(1, k + 1):
        num_matches, label_subs = 0, collections.defaultdict(int)
        # 统计参考序列中所有n-gram的出现次数
        for i in range(len_label - n + 1):
            ngram = ' '.join(label_tokens[i: i + n])
            label_subs[ngram] += 1
        # 统计预测序列中匹配的n-gram数量(不重复计数)
        for i in range(len_pred - n + 1):
            ngram = ' '.join(pred_tokens[i: i + n])
            if label_subs[ngram] > 0:
                num_matches += 1
                label_subs[ngram] -= 1  # 避免重复匹配
        # 累积n-gram分数(几何平均)
        score *= math.pow(num_matches / max(len_pred - n + 1, 1), math.pow(0.5, n))
    return score


# ---------------------------------------------------------------主函数--------------------------------------------
def main():
    # 1. 测试编码器/解码器形状(验证维度正确性)
    encoder = Seq2SeqEncoder(vocab_size=10, embed_size=8, num_hiddens=16, num_layers=2)
    encoder.eval()
    X = torch.zeros((4, 7), dtype=torch.long)  # 测试输入:batch_size=4, seq_len=7
    output, state = encoder(X)
    print("编码器输出形状:", output.shape)  # 预期:(7, 4, 16)(num_steps, batch_size, num_hiddens)
    print("编码器状态形状:", state.shape)  # 预期:(2, 4, 16)(num_layers, batch_size, num_hiddens)

    decoder = Seq2SeqDecoder(vocab_size=10, embed_size=8, num_hiddens=16, num_layers=2)
    decoder.eval()
    state = decoder.init_state(encoder(X))  # 用编码器状态初始化解码器
    output, state = decoder(X, state)
    print("解码器输出形状:", output.shape)  # 预期:(4, 7, 10)(batch_size, num_steps, vocab_size)
    print("解码器状态形状:", state.shape)  # 预期:(2, 4, 16)

    # 2. 测试序列掩码(验证填充项是否被正确屏蔽)
    X = torch.tensor([[1, 2, 3], [4, 5, 6]])
    print("序列掩码测试1:\n", sequence_mask(X, torch.tensor([1, 2])))  # 预期:第一行[1,0,0],第二行[4,5,0]

    X = torch.ones(2, 3, 4)
    print("序列掩码测试2:\n", sequence_mask(X, torch.tensor([1, 2]), value=-1))  # 填充位置设为-1

    # 3. 测试损失函数(验证带遮蔽的损失计算)
    loss = MaskedSoftmaxCELoss()
    print("损失函数测试:", loss(torch.ones(3, 4, 10), torch.ones((3, 4), dtype=torch.long), torch.tensor([4, 2, 0])))
    # 预期:第三样本损失为0(有效长度0),第二样本仅前2步计算损失

    # 4. 训练模型
    # 超参数设置
    embed_size, num_hiddens, num_layers, dropout = 32, 32, 2, 0.1
    batch_size, num_steps = 64, 10  # 序列最大长度
    lr, num_epochs, device = 0.005, 300, d2l.try_gpu()  # 优先使用GPU

    # 加载数据和词表(英法平行语料)
    train_iter, src_vocab, tgt_vocab = d2l.load_data_nmt(batch_size, num_steps)
    # 初始化模型
    encoder = Seq2SeqEncoder(len(src_vocab), embed_size, num_hiddens, num_layers, dropout)
    decoder = Seq2SeqDecoder(len(tgt_vocab), embed_size, num_hiddens, num_layers, dropout)
    net = d2l.EncoderDecoder(encoder, decoder)  # 组合编码器和解码器

    # 训练模型
    print("\n开始训练...")
    train_seq2seq(net, train_iter, lr, num_epochs, tgt_vocab, device)
    plt.show(block=True)  # 显示训练损失曲线

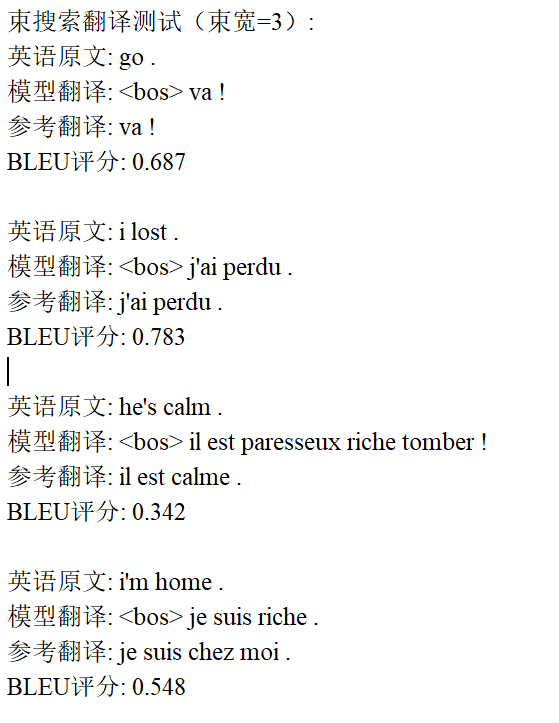
    # 5. 束搜索翻译测试(束宽=3)
    engs = ['go .', "i lost .", 'he\'s calm .', 'i\'m home .']  # 测试的英语句子
    fras = ['va !', 'j\'ai perdu .', 'il est calme .', 'je suis chez moi .']  # 参考法语翻译
    print("\n束搜索翻译测试(束宽=3):")
    for eng, fra in zip(engs, fras):
        # 使用束搜索生成翻译
        translation, _ = predict_seq2seq(
            net, eng, src_vocab, tgt_vocab, num_steps, device, beam_size=3
        )
        # 计算BLEU评分(k=2表示考虑1-gram和2-gram)
        print(f'英语原文: {eng}')
        print(f'模型翻译: {translation}')
        print(f'参考翻译: {fra}')
        print(f'BLEU评分: {bleu(translation, fra, k=2):.3f}\n')


if __name__ == '__main__':
    main()
十八、实验结果

开源鸿蒙跨平台开发社区汇聚开发者与厂商,共建“一次开发,多端部署”的开源生态,致力于降低跨端开发门槛,推动万物智联创新。
更多推荐
 24
 0
- 0


 已为社区贡献1条内容

所有评论(0)