【图像恢复】论文精读:Omni-Kernel Network for Image Restoration
前言
论文题目:Omni-Kernel Network for Image Restoration —— 用于图像恢复的全核网络
论文地址:Omni-Kernel Network for Image Restoration
论文源码:https://github.com/c-yn/OKNet
AAAI 2024
文章目录
Abstract
图像恢复旨在从退化的低质量观察中重建高质量图像。最近,Transformer模型在图像恢复任务中取得了很好的性能,因为它们具有强大的建模长期依赖关系的能力。然而,相对于输入大小,二次增长的复杂性使它们不适用于实际应用。本文通过增强多尺度表示学习,开发了一种用于图像恢复的高效卷积网络。为此,我们提出了一个由三个分支组成的泛核模块,即全局、大型和局部分支,以有效地学习全局到局部的特征表示。具体而言,全局分支通过双域通道注意力和频率门控机制实现了全局感知场。此外,为了提供多粒度的感受野,大分支是通过具有异常大的核大小的不同形状的深度卷积来构建的。此外,我们使用逐点深度卷积来补充局部信息。最后,通过将全核模块插入瓶颈位置以提高效率,建立了所提出的网络,称为OKNet。大量实验表明,我们的网络在11个基准数据集上实现了最先进的性能,用于三个代表性的图像恢复任务,包括图像去锯齿、图像去锯齿和图像散焦去模糊。
Introduction
图像恢复旨在从低质量的图像中恢复清晰的图像,这些图像会受到雾霾、雪花和模糊等劣化的影响。为了解决这个长期存在的不适定问题,传统方法利用各种手工制作的特征和假设来限制解决方案空间。然而,这些方法不适用于更具挑战性的现实世界场景(Zhang等人,2022)。
近年来,卷积神经网络(CNN)通过从收集的大规模数据集中学习可推广先验,在图像恢复任务上取得了优于传统算法的性能(Chen等人,2019)。为了进一步提高性能,许多先进的功能单元已经开发出来或从其他领域借用用于图像恢复,例如编码器-解码器架构(Cho等人,2021)、残差连接(Mao等人,2021年)和注意力机制(Cui等人,2023c)。最近,Transformer模型已被引入图像恢复,并显著提高了最先进的性能(Zamir等人,2022)。尽管如此,核心组件自我关注的复杂性相对于输入大小呈二次增长,使得这些方法不适合实际应用。
与具有有限感受野的卷积算子相比,Transformer模型进行全局或基于大窗口的自我注意,使网络能够获得大的感受野。受此机制的启发,最近一些关于CNN的工作通过设计具有大内核的高效CNN框架进行了反击,例如RepLKNet中的31×31(Ding等人,2022)和SLaK中的51×51(Liu等人,2023)。在图像恢复的背景下,LKDNet(Luo等人,2022)将21×21卷积分解为较小的深度方向卷积和深度方向扩展卷积,用于图像去噪。LaKDNet(Ruan等人,2023)利用大核大小的卷积(例如,9×9),然后进行逐点卷积,以获得用于图像去模糊的大有效感受野。MAN(Wang等人,2022b)将大核大小卷积分解为三个分量,即深度卷积、深度扩展卷积卷积和逐点卷积。然而,这些方法产生的感受野仍然有限,它们不能提供全局感受野。
本文探讨了使用63×63深度卷积进行异常大核卷积进行图像恢复的潜力。此外,我们利用基于大条带的卷积来进一步增强表示学习,以实现高质量的图像重建。为了抑制这些大卷积带来的计算开销,我们只在瓶颈中部署它们。此外,我们采用双域通道注意力和频率门控机制来提供全局感受野。除了追求大的感受野外,我们还利用1×1的深度卷积来补充小尺寸退化的局部信息。最后,通过并行组织上述设计形成所提出的全核模块(OKM),使网络具有处理多尺度退化的能力。
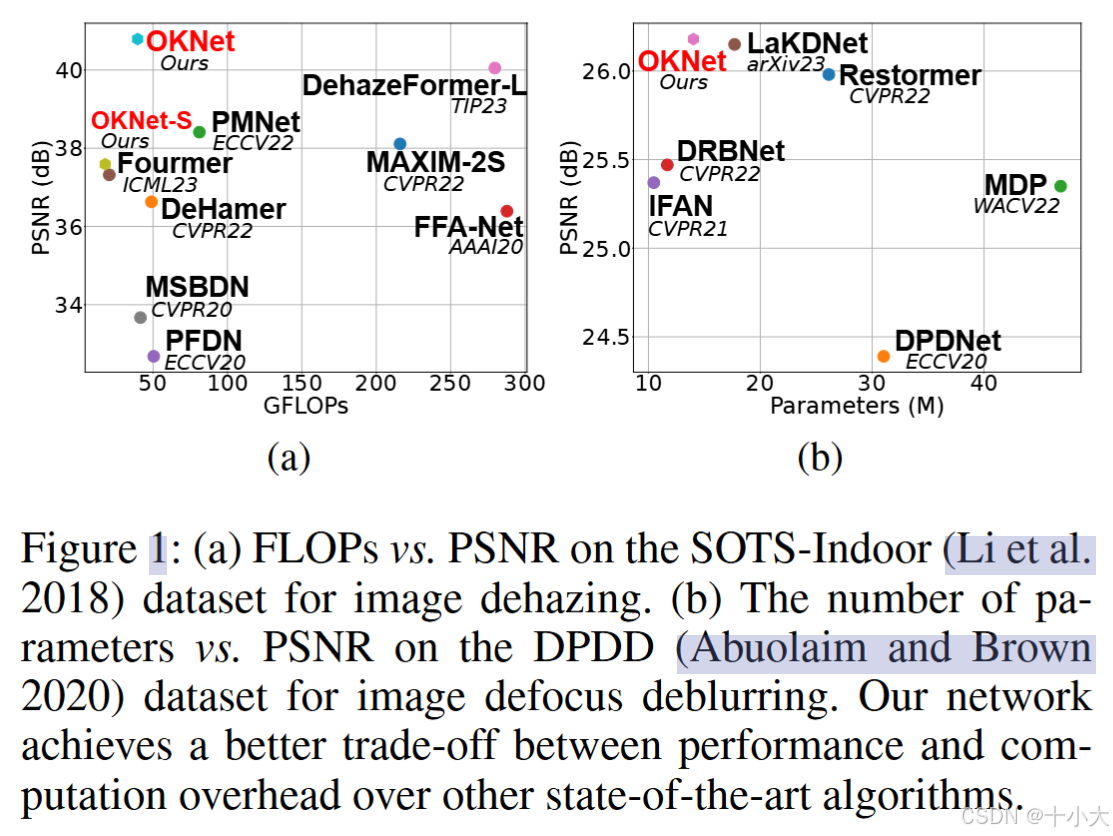
我们的简单卷积网络在瓶颈处配备了OKM,在11个不同的数据集上实现了最先进的性能,用于三个具有代表性的图像恢复任务。更具体地说,如图1(a)所示,OKNet在SOTS Indoor(Li等人,2018)数据集上的复杂度相当的情况下,显著优于最近的Transformer模型Fourmer(Zhou等人,2023)3.47 dB PSNR。对于单图像散焦去模糊,在DPDD(Abuolaim和Brown 2020)数据集的组合类别中,我们的模型比强Transformer模型Restormer(Zamir等人,2022)的性能提高了0.2 dB PSNR,参数减少了46%。此外,所提出的模型还代表了图像去知识任务的强大能力,在CSD(Chen等人,2021b)数据集上比最近的算法IRNeXt(Cui等人,2023c)高出0.7 dB PSNR。总体而言,本文的贡献可以总结如下:
- 我们提出了一种全核模块,能够有效地捕获多尺度感受野进行图像恢复,其中大规模信息是通过双域处理和不同形状的大核尺寸深度卷积进行调制的。
- 在11个广泛使用的基准数据集上进行的广泛实验表明,所提出的模型,即OKNet,在三个代表性的图像恢复任务上达到了最先进的性能,即图像散焦去模糊、图像去模糊和图像去模糊。
Related Works
Image Restoration
作为一个长期存在的问题,图像恢复旨在从退化的图像中重建出干净的图像,在许多场景中发挥着重要作用,如监控、自动驾驶技术、遥感和医学成像。由于其高度不适定的特性,许多传统算法主要是基于假设和手工制作的特征开发的,这不适用于更具挑战性的实际应用。近年来,深度学习方法通过从大规模数据集中学习可泛化先验,取得了明显优于传统竞争对手的性能。这些方法大致可分为两类:基于CNN的方法和基于Transformer的方法。多年来,基于CNN的方法通过设计或借鉴其他领域的先进功能单元主导了图像恢复(Cui等人,2023b;Cui和Knoll 2023)。例如,FFA-Net(Qin等人,2020)利用通道注意力和像素注意力模块,对通道和像素特征进行不平等处理,以获得不均匀的雾度分布。SDWNet (Zou et al. 2021)利用多个扩张率不同的扩张卷积并行获得较大的感受野。SFNet (Cui et al. 2023d) 使用动态选择性频率模块来选择信息量最大的频率来恢复。为了更有效地建模远程依赖关系,Transformer (Vaswani et al. 2017)被引入到图像恢复中(Chen et al. 2021a;Liang et al. 2021)。为了提高自我注意的效率,常见的策略是限制自我注意区域(Wang et al. 2022c;Tsai et al. 2022),并将自我注意从空间维度切换到通道维度(Zamir et al. 2022)。尽管有这些努力,Transformer 模型在实际应用中仍然很昂贵,并牺牲了远程信号建模能力。此外,Transformer 模型无法捕获多尺度感受野。在本文中,我们提出了一种有效的卷积网络,能够学习多尺度表示。
Large Kernel Network
最近,受 Transformer 成功背后的合理原因的启发,即远程依赖建模能力,基于 CNN 的方法通过使用大内核卷积返回。例如,RepLKNet (Ding et al. 2022) 遵循设计大卷积的几个指南实现了 31 × 31 内核,大大缩小了 CNN 和 Transformer 模型之间的性能差距。SLaK (Liu et al. 2023) 利用稀疏分解 51 × 51 内核来对抗 Transformer 方法。在图像恢复领域,LaKDNet (Ruan et al. 2023) 通过大核 (9×9) 深度卷积和逐点卷积的组合来扩大有效感受野。MAN (Wang et al. 2022b) 通过将大内核卷积分解为三种不同的卷积来呈现大内核注意力。LKD-Net (Luo et al. 2022)将深度卷积分解为更小的深度卷积和深度扩展卷积。我们的方法与上述图像恢复算法有四个不同之处:(a)我们探索了异常大的内核大小卷积用于图像恢复的潜力,即63 × 63;(b)除了常规的方形深度卷积外,我们在不同的方向上使用基于条带的版本,为高质量的图像重建提供不同的接受域形状;©我们通过双域处理提供全尺寸的接受域;(d)我们通过极其简单的1 × 1深度卷积来补充局部信息。仅在瓶颈中部署所提出的方法,我们高效的 OKNet 可以与最先进的 Transformer 模型相当或更好。
Methodology
在本节中,我们首先描述提议的 OKNet 的整体管道。然后,我们描述了我们的全内核模块 (OKM) 的架构细节。最后,我们介绍了训练阶段使用的损失函数。
Overall Pipeline
整个管道如图 2 (a) 所示。如图所示,OKNet 采用编码器-解码器架构,该架构由编码器和解码器阶段的三个尺度组成。ResGroup 由多个残差块组成,每个块包括两个 3 × 3 卷积,中间具有 GELU (Hendrycks and Gimpel 2016) 非线性。OVM 仅插入瓶颈位置,其中特征的分辨率最低,以节省计算开销。
给定一个输入退化图像 I ∈ R3×H×W ,我们首先利用 3×3 卷积将图像投影到大小为 C × H × W 的嵌入特征中,其中 C 表示通道数,H × W 表示像素的空间位置。接下来,将生成的特征输入编码器阶段以提取深度表示。下采样操作由跨步卷积 (kernel=3, stride=2) 实现,它在减少空间维度的同时扩展了通道数。在提出的OKM处理后,特征通过解码器网络恢复高分辨率表示。在此过程中,解码器特征与编码器特征连接起来以帮助恢复,然后进行 1×1 卷积以将通道减少一半。上采样层由转置卷积(kernel=4,stride=2)完成,以扩大空间维度并将通道数减半。最后,使用 3 × 3 卷积生成学习到的残差图像,其中添加输入图像以产生最终恢复的输出。接下来,我们将详细介绍所提出的 OVM。
Omni-Kernel Module (OKM)
OKM 的示意图如图 2 (b) 所示。给定输入特征 X ∈ RC×H×W ,经过 1×1 卷积处理后,特征被馈送到三个分支,即局部分支、大分支和全局分支,以增强多尺度表示。然后通过加法融合三个分支的结果,并通过另一个 1×1 卷积调制。在下文中,我们将介绍每个分支的内部组件。
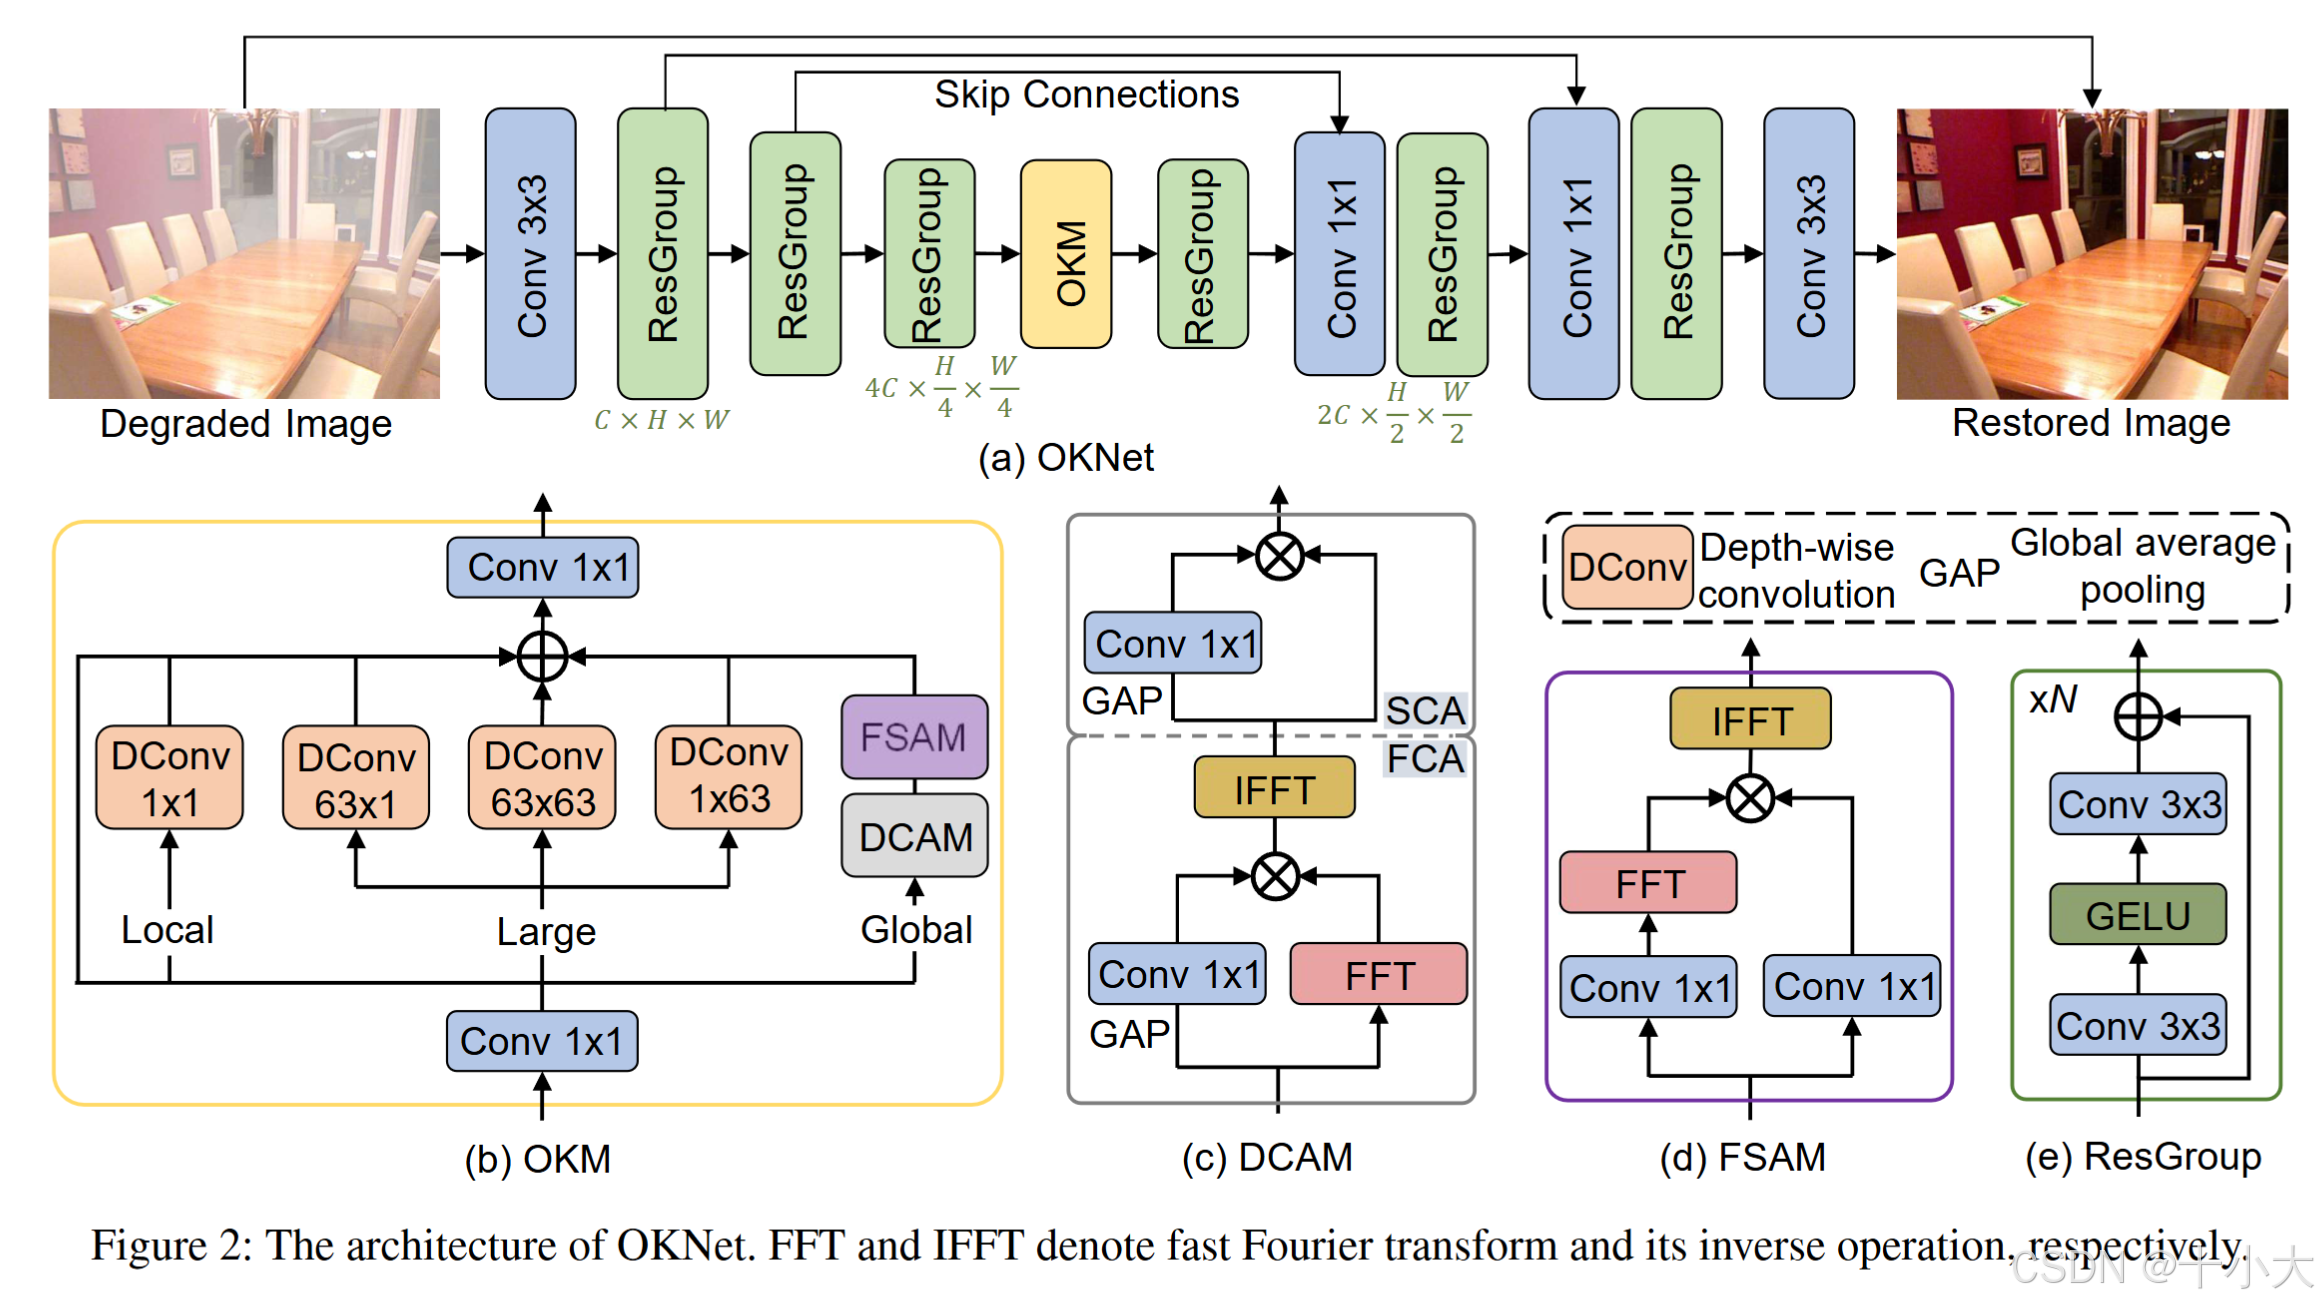
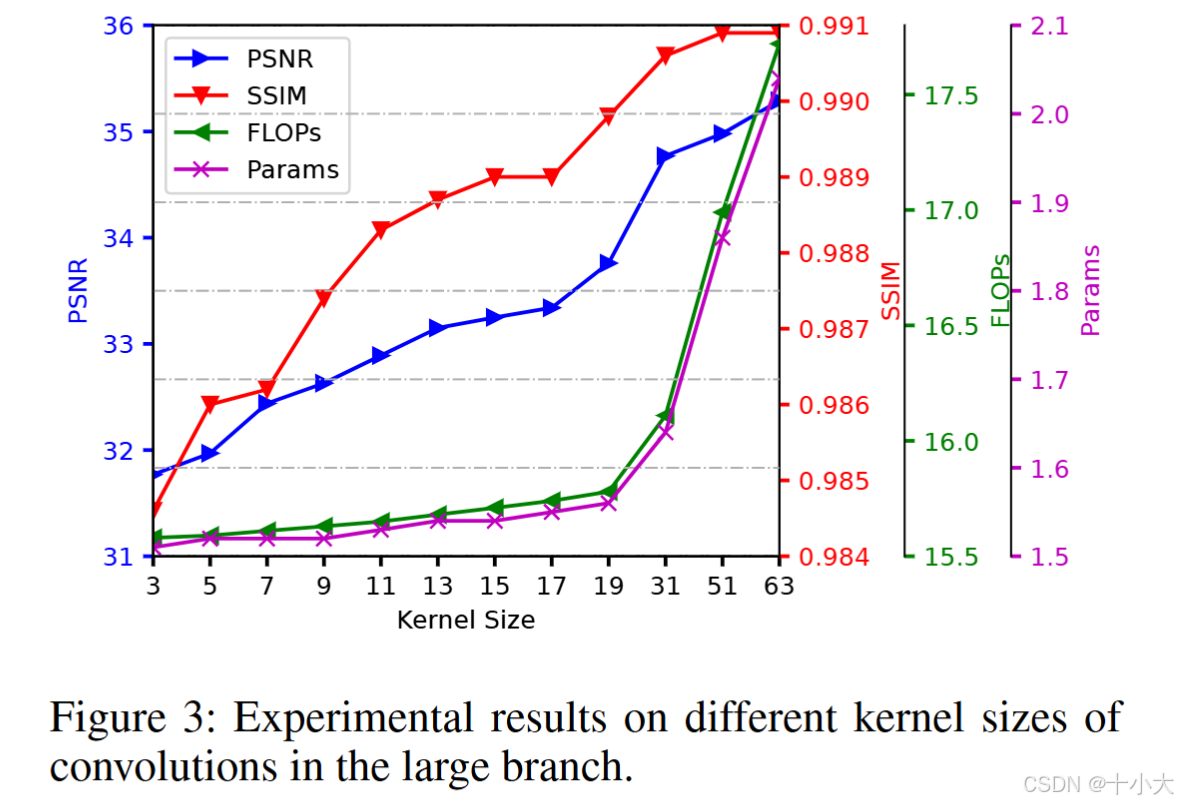
大分支 在这个分支中,我们应用一个廉价的核大小K ×K深度卷积来追求大的接受域。除了常规的深度卷积外,受基于条带的自我注意的启发(Dong et al. 2022;Tsai et al. 2022;Li et al. 2023),我们还采用了1 × K和K × 1深度卷积与正方形卷积并行,以获取条带状的上下文信息。为了避免引入由大内核大小卷积引起的大量计算开销,我们将模块放置在瓶颈位置。然后,我们通过逐渐增加 K 来探索使用非常大的卷积进行图像恢复的可能性。实验结果如表3所示。一般来说,随着内核大小从K = 3扩大到K = 63,峰值信噪比(PSNR)和结构相似性指数(SSIM)指标增加。我们模块的位置允许我们采用异常大的内核大小来捕获大规模的不同引入参数少、复杂度低的接收域形状。我们最终在大分支中选择 K = 63 以获得更好的性能。
全局分支 OKNet主要在裁剪的3 ×256 × 256图像补丁上进行训练,瓶颈特征空间大小为64×64,因此我们在大分支中采用了最大的奇数内核大小。然而,在推理阶段,输入退化图像远大于训练补丁。因此,63 × 63 内核无法覆盖全局字段。为了缓解这个问题,我们通过诉诸双域处理在全局分支中叠加全局建模能力。具体来说,全局分支由双域通道注意模块 (DCAM) 和基于频率的空间注意模块 (FSAM) 组成。接下来,我们依次介绍这两个模块。给定输入特征XGlobal∈RC×H×W,DCAM首先将频率通道注意(FCA)应用于XGlobal,如下所示:
X
F
C
A
=
I
F
(
F
(
X
Global
)
⊗
W
1
×
1
F
C
A
(
GAP
(
X
Global
)
)
)
(1)
X_{\mathrm{FCA}}=\mathcal{I F}\left(\mathcal{F}\left(X_{\text {Global }}\right) \otimes W_{1 \times 1}^{\mathrm{FCA}}\left(\operatorname{GAP}\left(X_{\text {Global }}\right)\right)\right)\tag{1}
XFCA=IF(F(XGlobal )⊗W1×1FCA(GAP(XGlobal )))(1)
其中 F 和 IF 分别是快速傅里叶变换及其逆运算; XFCA、W1×1 和 GAP 分别表示 FCA 的输出、1×1 卷积层和全局平均池化; ⊗ 表示逐元素乘法运算。通过傅里叶处理,根据谱卷积定理有效地细化全局特征。在谱域全局调制后,将得到的特征进一步输入到空间通道注意模块(SCA)中,其形式可表示为:
X
D
C
A
M
=
X
F
C
A
⊗
W
1
×
1
S
C
A
(
GAP
(
X
F
C
A
)
)
(2)
X_{\mathrm{DCAM}}=X_{\mathrm{FCA}} \otimes W_{1 \times 1}^{\mathrm{SCA}}\left(\operatorname{GAP}\left(X_{\mathrm{FCA}}\right)\right)\tag{2}
XDCAM=XFCA⊗W1×1SCA(GAP(XFCA))(2)
其中 XDCAM 是 DCAM 的输出。DCAM 仅在通道粗粒度上增强了双域特征。然后,我们在空间维度上应用基于频率的注意模块来细化细粒度级别的频谱,其形式表示为:
X
F
S
A
M
=
I
F
(
F
(
W
1
×
1
1
(
X
D
C
A
M
)
)
⊗
W
1
×
1
2
(
X
D
C
A
M
)
)
(3)
X_{\mathrm{FSAM}}=\mathcal{I F}\left(\mathcal{F}\left(W_{1 \times 1}^{1}\left(X_{\mathrm{DCAM}}\right)\right) \otimes W_{1 \times 1}^{2}\left(X_{\mathrm{DCAM}}\right)\right)\tag{3}
XFSAM=IF(F(W1×11(XDCAM))⊗W1×12(XDCAM))(3)
其中 XFSAM 是 FSAM 的结果。通过这样做,该模型关注信息频率分量进行高质量的图像重建。
局部分支 受局部信息在图像恢复中起着至关重要的作用这一事实的启发(Zamir et al. 2022;Wang et al. 2022c),除了捕获大规模接受域的大型全局分支外,我们还设计了一个极其简单而有效的局部分支,通过使用1 × 1深度卷积层进行局部信号调制,如图2 (b)所示。我们在表 5 中展示了它的有效性。
Loss Function
为了恢复忠实的高质量图像,一种简单的方法是使预测图像的内容更接近地面真实图像的内容:
L
c
=
∥
I
^
−
Y
∥
1
(4)
\mathcal{L}_{c}=\|\hat{I}-Y\|_{1}\tag{4}
Lc=∥I^−Y∥1(4)
其中 ^I 和 Y 分别表示预测图像和地面实况。除了空间域对齐之外,所提出的网络还促进了频率信号学习。因此,我们还应用频域L1损失(Cho et al. 2021)进行训练:
L
f
=
∥
F
(
I
^
)
−
F
(
Y
)
∥
1
(5)
\mathcal{L}_{f}=\|\mathcal{F}(\hat{I})-\mathcal{F}(Y)\|_{1}\tag{5}
Lf=∥F(I^)−F(Y)∥1(5)
最后,整体损失函数由下式给出:
L
o
=
1
E
(
L
c
+
λ
L
f
)
(6)
\mathcal{L}_{o}=\frac{1}{E}\left(\mathcal{L}_{c}+\lambda \mathcal{L}_{f}\right)\tag{6}
Lo=E1(Lc+λLf)(6)
其中 E 表示输出中元素的数量,λ 设置为 0.1 以平衡双域训练。
Experiments
在本节中,我们对 11 个不同的基准数据集进行了实验,以证明我们的网络在三个具有代表性的图像恢复任务中的有效性:图像去雾、图像散焦去模糊和图像去雪。在表中,最佳和次最佳结果以粗体和下划线标记。
Implementation Details
我们为不同的数据集训练单独的模型。根据任务复杂性,我们通过在每个 ResGroup 中设置不同数量的残差块来扩展 OKNet(图 2 (e)),即去雾和去雾的 N = 4,去模糊的 N = 16。此外,我们通过设置 N = 1 以更好地与最近的算法(Zhou et al. 2023)进行比较,为图像去雾提供了一个小版本,称为 OKNet-S。除非另有说明,否则采用以下超参数。这些模型使用 Adam 优化器(Kingma 和 Ba 2014)进行训练,β1 = 0.9 和β2 = 0.999。批量大小设置为 8。学习率最初设置为 2e-4,并使用余弦退火衰减策略逐渐降低到 1e-6(Loshchilov 和 Hutter 2016)。对于数据增强,大小为 256 × 256 的裁剪补丁以 0.5 的概率随机水平翻转。 FLOP 在 256 × 256 补丁大小上测量。
Experimental Results
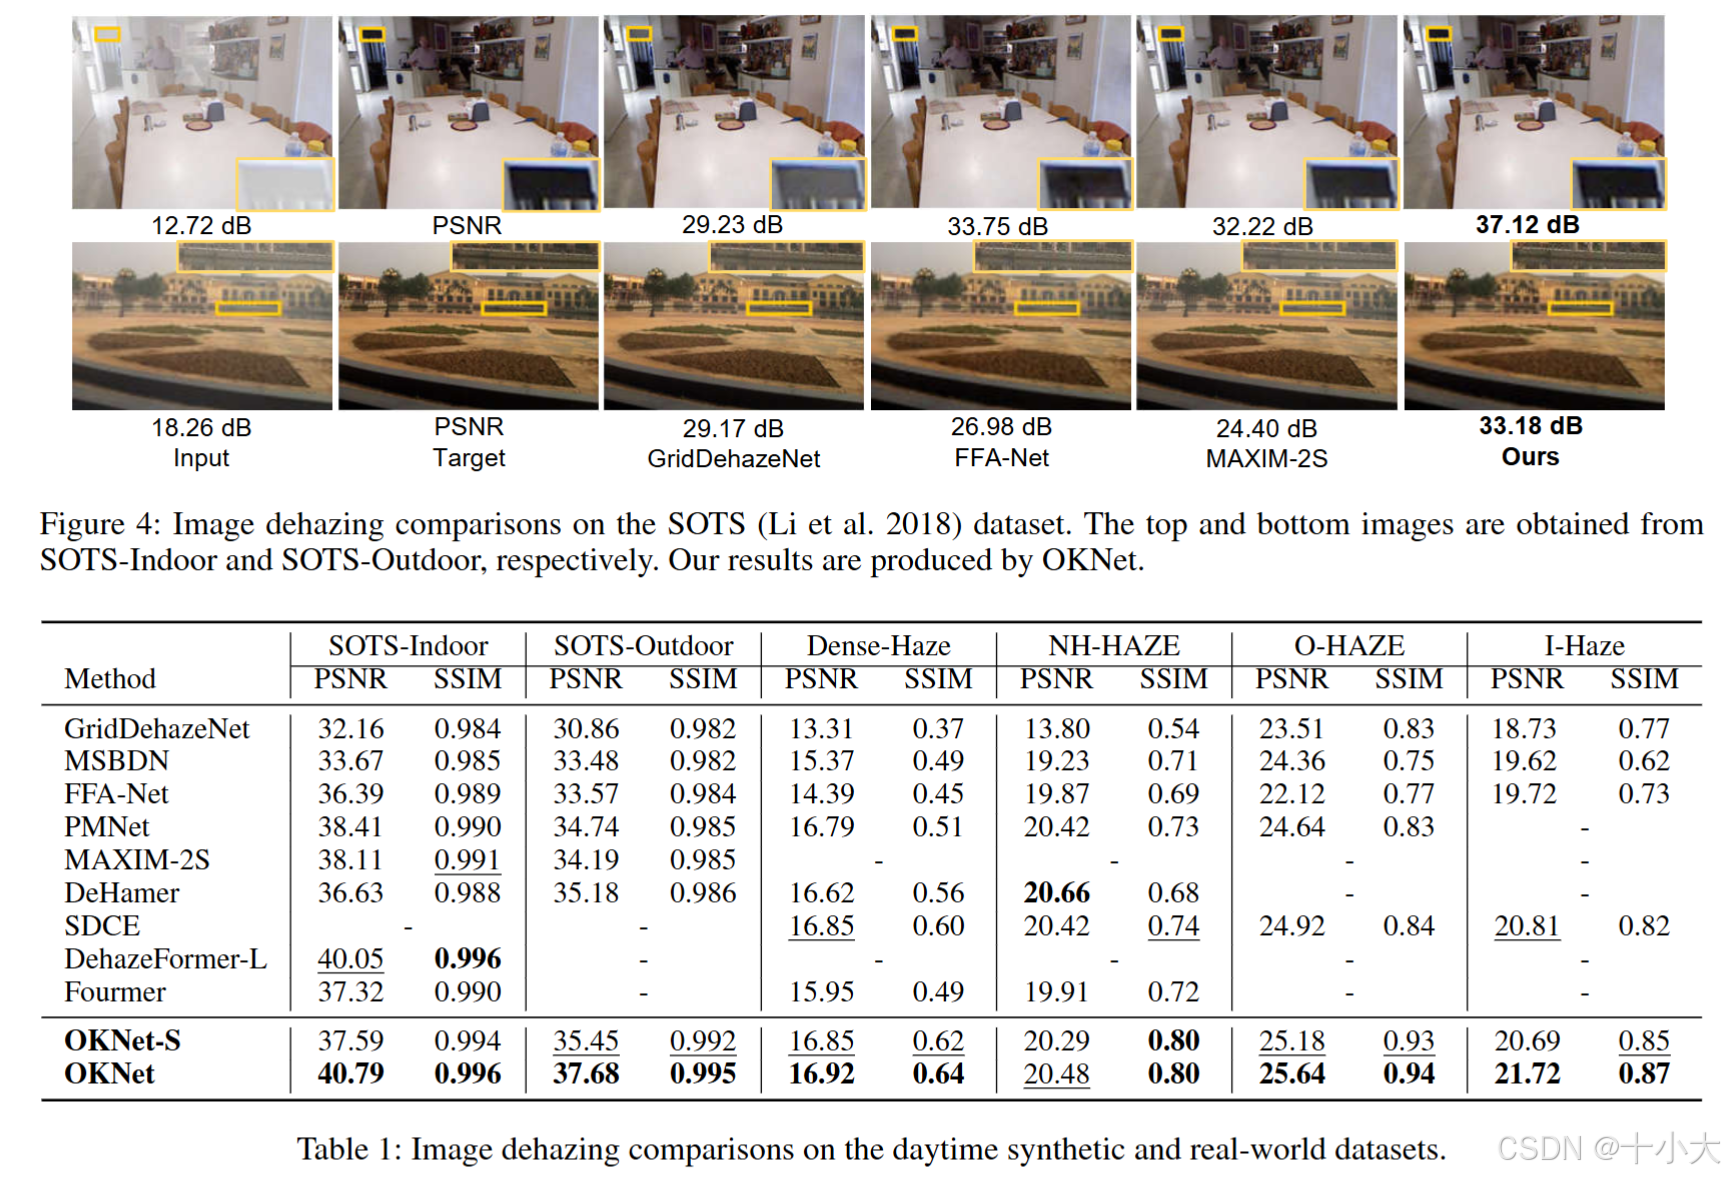
图像去雾结果 我们在三个数据集上进行了广泛的实验:白天合成数据集(resider (Li et al. 2018))、白天真实数据集(Dense-Haze (Ancuti et al. 2019)、NH-HAZE (Ancuti, Ancuti和Timofte 2020)、O-Haze (Ancuti et al. 2018b)和I-Haze (Ancuti et al. 2018a)和夜间数据集(NHR (Zhang et al. 2020))。对于白天数据集,我们将我们的模型与 9 个具有代表性的最先进技术进行比较GridDehazeNet (Liu et al. 2019)、MSBDN (Dong et al. 2020)、FFA-Net (Qin et al. 2020)、PMNet (Ye et al. 2022)、MAXIM-2S (Tu et al. 2022)、DeHamer (Guo et al. 2022)、SDCE (Zhu et al. 2023)、DehazeFormer-L (Song et al. 2023)和Fourmer (Zhou et al. 2023)。结果如表1所示。我们的OKNet在大多数指标上都取得了最好的结果。具体来说,OKNet 在 SOTS-Indoor (Li et al. 2018) 数据集上优于昂贵的基于 Transformer 的模型 DehazeFormer-L 0.74 dB PSNR,只有 14% 的 FLOP,如图 1 (a) 所示。此外,我们的OKNet在SDCE上的所有真实数据集上产生了更好的性能,这些数据集是为现实场景精心设计的。此外,与最近的算法 Fourmer 相比,我们的 OKNet-S 在 SOTS-Indoor 上实现了 0.27 dB PSNR 的显着增益,FLOPs 减少了 13%。SOTS-Indoor 和 SOTS-Outdoor 的视觉比较如图 4 所示。我们的 OKNet 产生的结果比其他竞争算法。
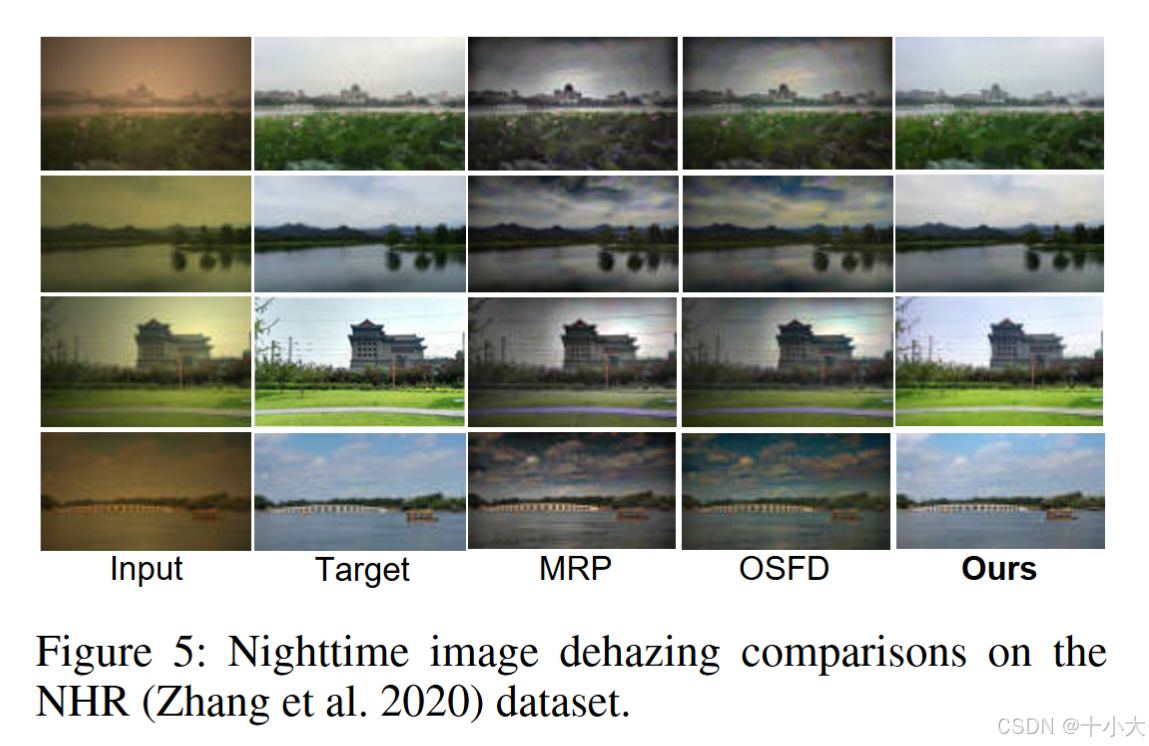
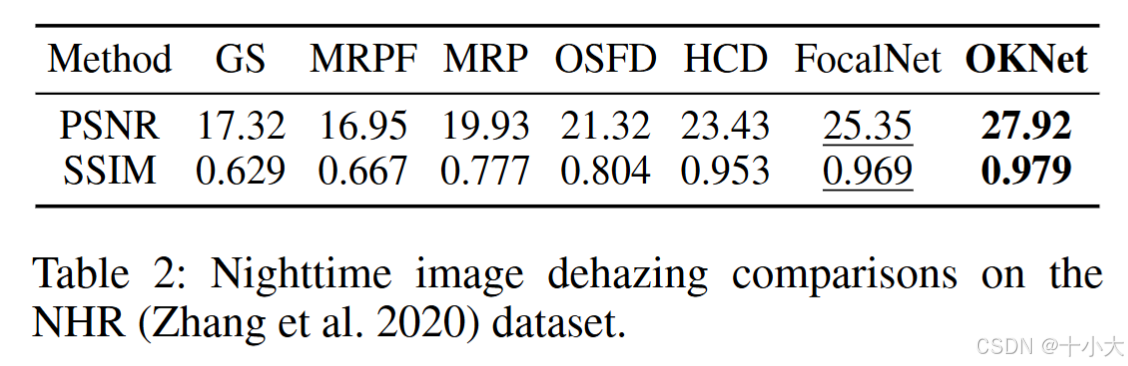
我们进一步展示了夜间图像去雾数据集NHR (Zhang et al. 2020)与6种最先进的方法的比较:GS (Li, Tan和Brown 2015), MRPF (Zhang et al. 2017), MRP (Zhang et al. 2017), OSFD (Zhang et al. 2020), HCD (Wang et al. 2022a)和FocalNet (Cui et al. 2023a)。表 2 显示我们的方法优于最近的 FocalNet 2.57 dB PSNR 和 0.01 SSIM。图 5 说明了我们的网络产生的结果更接近真实目标。
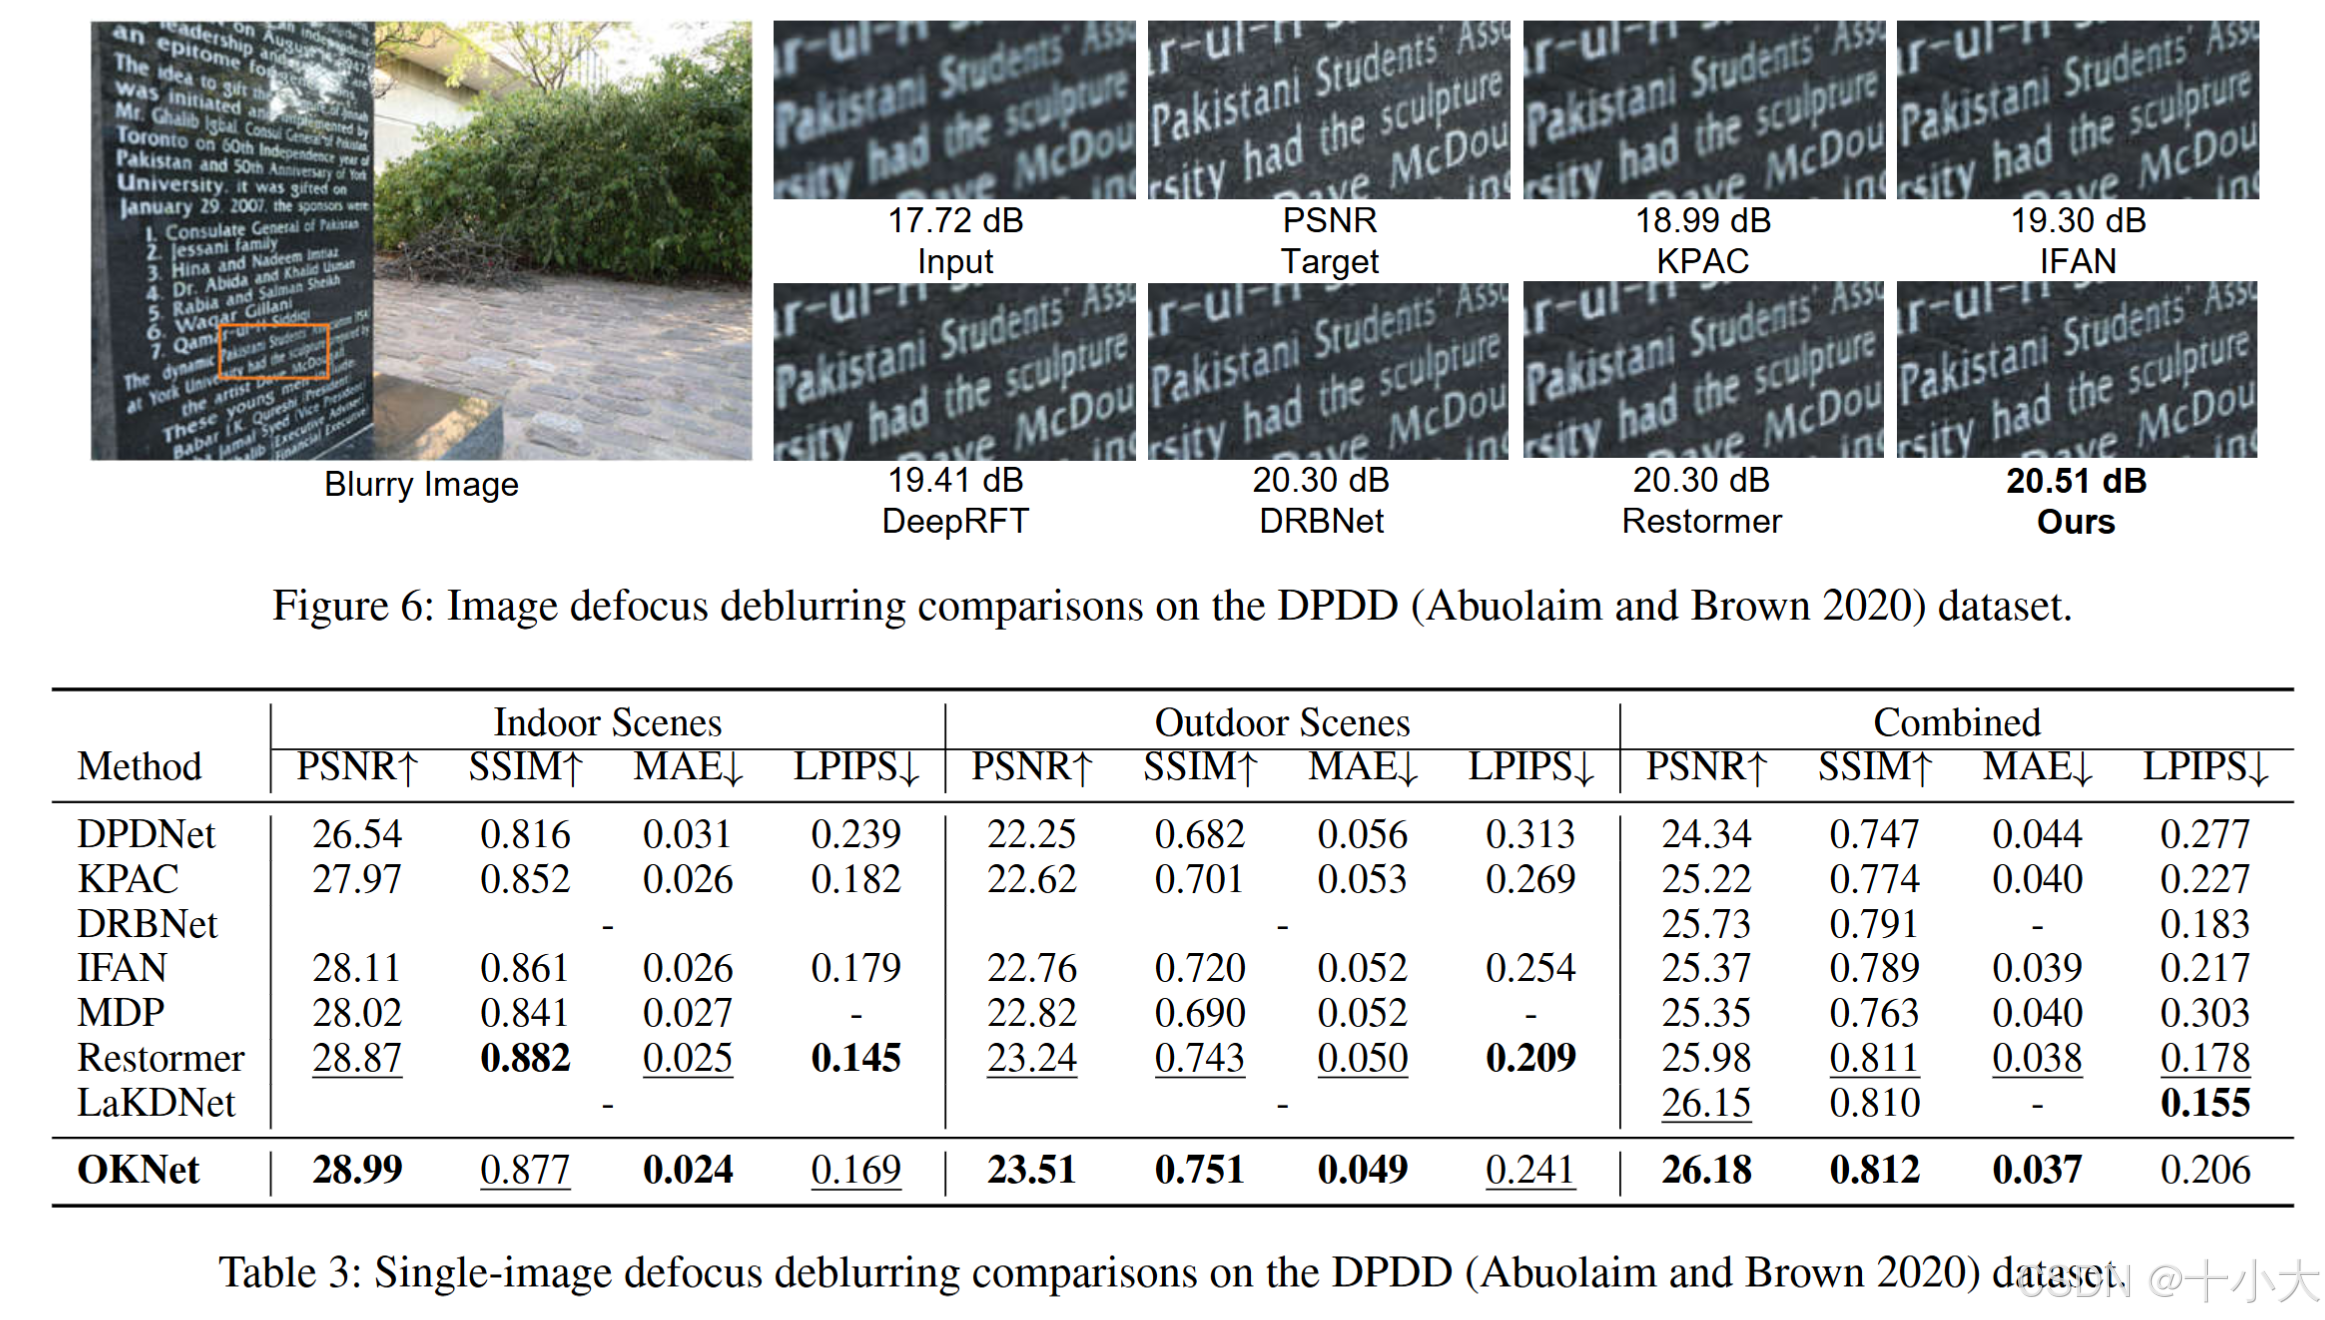
图像散焦去模糊 结果我们使用广泛使用的 DPDD (Abuolaim and Brown 2020) 数据集验证了所提出的网络对单幅图像散焦去模糊的有效性,并将结果与 7 种代表性算法进行了比较:DPDNet (Abuolaim and Brown 2020)、KPAC (Son et al. 2021)、DRBNet (Ruan et al. 2022)、IFAN (Lee et al. 2021)、MDP (Abuolaim, Afifi, and Brown 2022)、Restormer (Zamir et al. 2022) 和 LaKDNet (Ruan et al. 2023)。结果如表3所示。可以看出,我们的模型在大多数指标上都比其他方法取得了更好的性能。具体来说,OKNet 在户外场景中比基于 Transformer 的模型 Restormer 获得了 0.27 dB PSNR 的显着增益。此外,与使用大内核卷积的 LaKDNet 相比,我们的模型在组合类别上的性能提高了 0.03 dB PSNR 和 0.002 SSIM,参数减少了 21%,如图 1 (b) 所示。视觉比较如图6所示。我们的方法比其他竞争对手产生了更清晰、更直观、更忠实的结果。
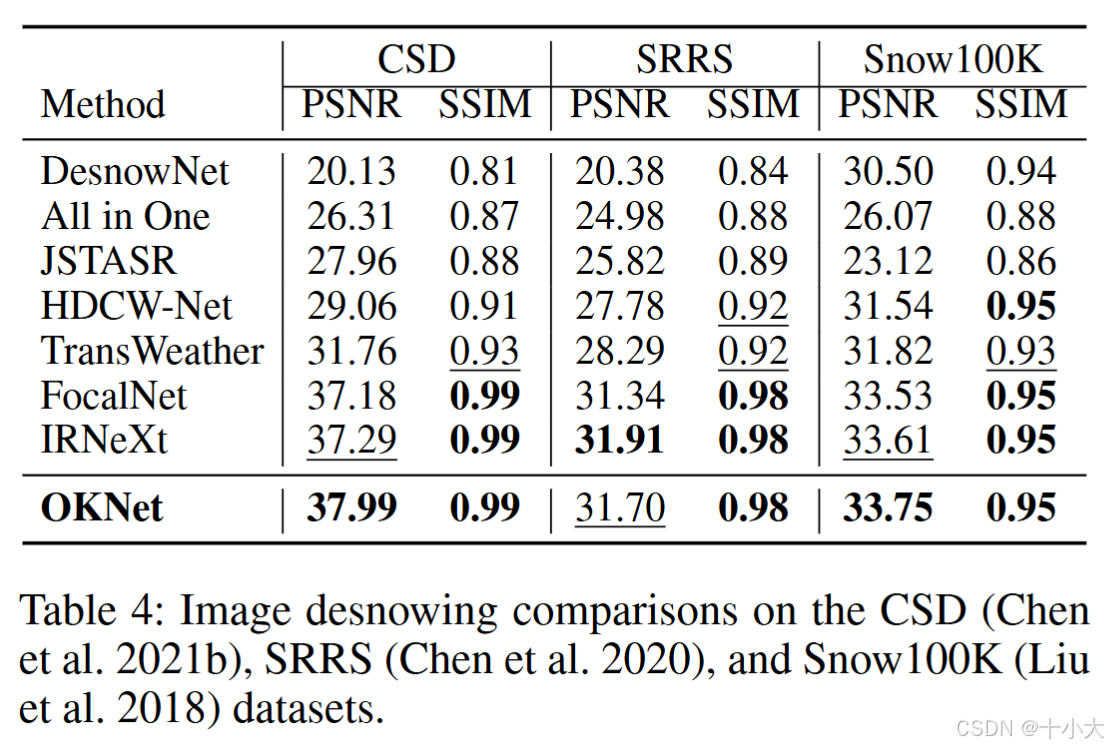
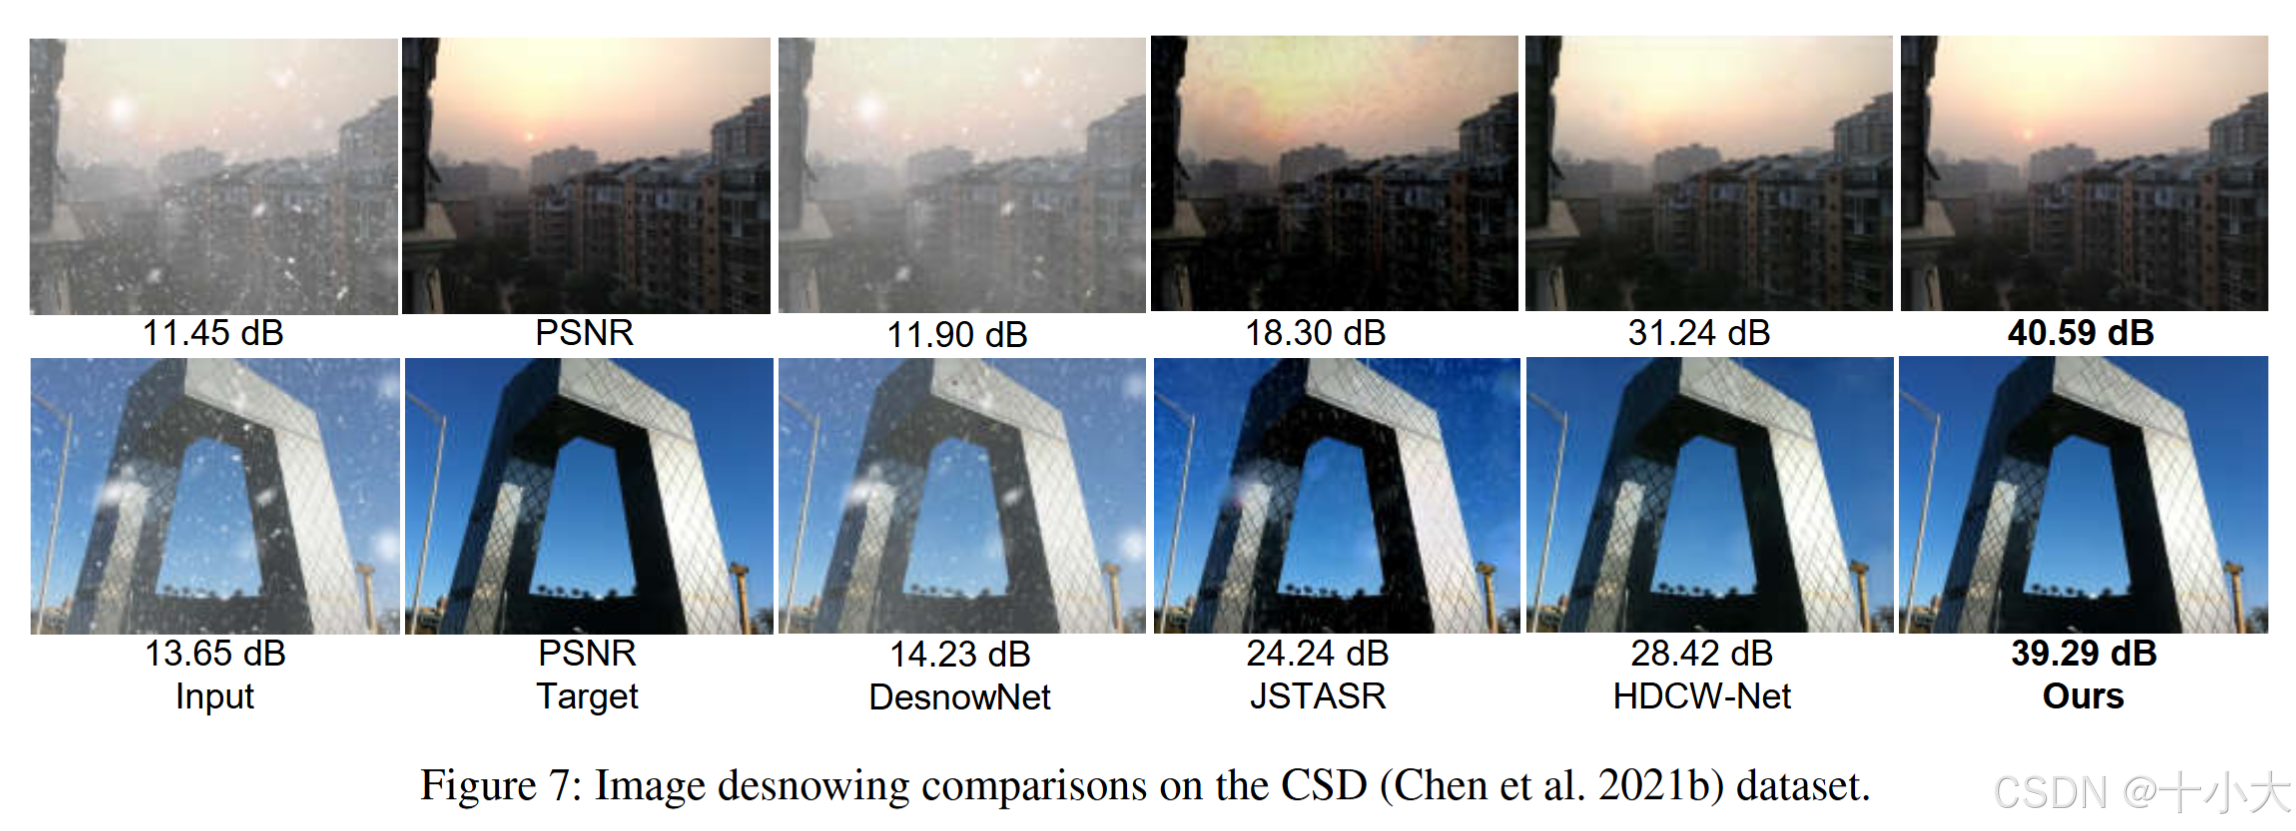
图像去雪结果 我们在三个广泛使用的图像去雪数据集上评估所提出的模型,包括 Snow100K (Liu et al. 2018)、SRRS (Chen et al. 2020) 和 CSD (Chen et al. 2021b)。然后,我们将我们的结果与8种最先进的算法进行了比较:DesnowNet (Liu et al. 2018)、CycleGAN (Engin, Genc和Kemal Ekenel 2018)、All in One (Li, Tan和Cheong 2020)、JSTASR (Chen et al. 2020)、HDCW-Net (Chen et al. 2021b)、TransWeather (Valanarasu, Yasarla和Patel 2022)、FocalNet (Cui et al. 2023a)和IRNeXt (Cui et al. 2023c)。表4显示,该网络具有较强的积雪去除能力。具体来说,OKNet在Snow100K数据集上的性能比最近的算法IRNeXt高出0.14 dB PSNR。在更复杂的 CSD 数据集上,优势变得更大,表明有效性我们方法的。图 7 显示我们的结果比其他结果在视觉上更令人愉悦。
Ablation Studies
我们通过将 OKNet-S 在 RESIDE-Indoor (Li et al. 2018) 数据集上训练 300 个 epoch 并在 SOTS-Indoor 上进行评估来执行消融研究(Li et al. 2018)。基线模型是通过从我们的模型中删除 OKM 获得的。
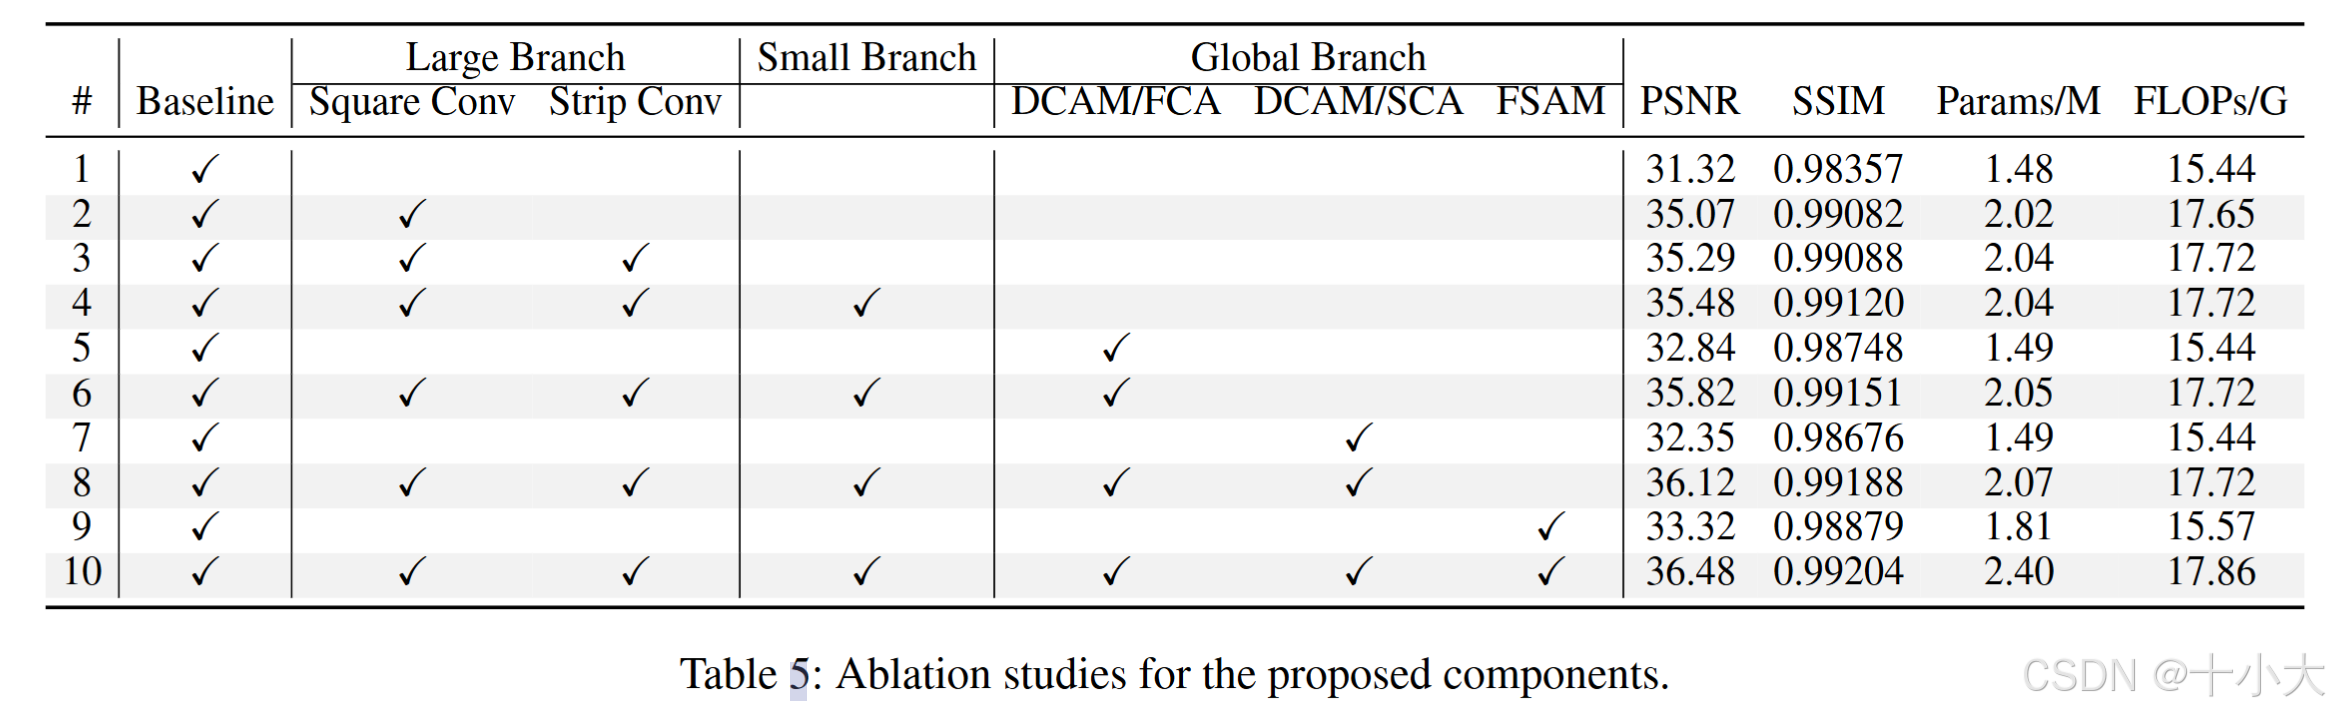
我们将设计的大分支、小分支和全局分支逐步添加到基线模型中。结果如表5所示。基线模型达到31.32 dB PSNR。异常大的常规卷积比基线显着提高了 3.75 dB,而基于条带的卷积进一步将性能提高到 35.29 dB,证明了捕获不同形状的感受野的有效性。非常简单的小分支通过增强局部信息将准确率提高到 35.48 dB。最后,我们研究了各个组件在全局分支中的功效。FCA、SCA 和 FSAM 比基线模型实现了 1.52 dB、1.03 dB 和 2 dB 的性能增益。FCA 和 SCA 的组合 (#8) 产生比仅使用 FCA (#6) 更高的分数,这表明我们的设计的兼容性。配备 FSAM,完整模型产生了最好的结果,比基线模型高 5.16 dB。
Conclusion
在本文中,我们提出了一种高效的卷积网络OKNet,它能够捕获多尺度的接受域。核心组件OKM由三个分支组成,用于对本地、大型和全局依赖项进行建模。大分支是通过探索异常大的基于规则和条带的深度卷积来进行图像恢复而设计的。新的全局分支利用双域通道注意和基于频率的空间注意来调节全局表示。此外,极其轻量级的本地分支给模型带来了局部性。将简单而有效的OKM插入到瓶颈中,OKNet在三个图像恢复任务的11个不同的数据集上实现了最先进的性能。
回顾一下网络结构:
用实践巩固理论!请马不停蹄地来到复现文章吧!看看XX模型结构具体是如何实现的吧!
本文对应的复现文章:
至此本文结束。
如果本文对你有所帮助,请点赞收藏,创作不易,感谢您的支持!
点击下方👇公众号区域,扫码关注,可免费领取一份200+即插即用模块资料!

开源鸿蒙跨平台开发社区汇聚开发者与厂商,共建“一次开发,多端部署”的开源生态,致力于降低跨端开发门槛,推动万物智联创新。
更多推荐
 29
 0
- 0


 已为社区贡献1条内容

所有评论(0)