机器学习实战指南:从数据预处理到建模与评估
本文将介绍机器学习项目的基本流程,包括数据探索、预处理、建模和评估等关键步骤,并提供详细的Python代码示例。
构建和使用模型的四个核心步骤:
-
定义模型:确定模型类型及相关参数
-
拟合模型:从数据中学习模式
-
预测:使用模型进行预测
-
评估:评估模型预测的准确性
数据探索
# 导入数据
import pandas as pd
df = pd.read_csv(filepath)
df.head()
# 查看关于数据的信息
df.describe()
# 查看数据的列名
df.columns
选择数据
y = df.target

df_features = ['feature_1', 'feature_2']
X = df[df_features]
只选择数值型变量
y = df.target
df = data.drop(['targrt'], axis = 1)
X = df.select_dtypes(exclude = ['object'])
拆分数据
# 将数据拆分为训练数据和验证数据,比例为 8 : 2
from sklearn.model_selection import train_test_split

train_X, val_X, train_y, val_y = train_test_split(X, y, train_size = 0.8, test_size = 0.2,random_state = 0)
缺失值处理
- 删除缺失值
df = df.dropna(axis = 0)
- 删除包含缺失值的列
cols_with_missing = [col for col in train_X.columns
                     if train_X[col].isnull().any()]

reduced_train_X = train_X.drop(cols_with_missing, axis = 1)
reduced_val_X = val_X.drop(cols_with_missing, axis = 1)
- 填补缺失值
# 用平均数来填补缺失值

from sklearn.impute import SimpleImputer

my_imputer = SimpleImputer()
imputed_train_X = pd.DataFrame(my_imputer.fit_transform(train_X))
imputed_val_X = pd.DateFrame(my_imputer.transform(val_X))

imputed_train_X.columns = train_X.columns
imputed_val_X.columns = val_X.columns
# 添加一个新列,以显示填补的位置

train_X_plus = train_X.copy()
val_X_plus = val_X.copy()

for col in cols_with_missing:
    train_X_plus[col + '_was_missing'] = train_X_plus[col].isnull()
    val_X_plus[col + '_was_missing'] = val_X_plus[col].isnull()

from sklearn.impute import SimpleImputer

my_imputer = SimpleImputer()

imputed_train_X_plus = pd.DataFrame(
    my_imputer.fit_transform(train_X_plus)
)
imputed_val_X_plus = pd.DataFrame(
    my_imputer.transform(val_X_plus)
)

imputed_train_X_plus.columns = train_X_plus.columns
imputed_val_X_plus.columns = val_X_plus.columns
分类变量
- 找出分类变量
s = (train_X.dtypes == 'object')
object_cols = list(s[s].index)
- 处理分类变量
-
删除分类变量
drop_train_X = train_X.select_dtypes(exclude = ['object']) drop_val_X = val_X.select_dtypes(exclude = ['object']) -
序数编码(Ordinal Encoding)
from sklearn.preprocessing import OridinalEncoder label_train_X = train_X.copy() label_val_X = val_X.copy() ordinal_encoder = OrdinalEncoder() label_train_X[object_cols] = ordinal_encoder.fit_transform( X_train[object_cols] ) label_val_X[object_cols] = ordinal_encoder.transform( val_X[object_cols] ) -
独热编码(One-Hot Encoding)
from sklearn.preprocessing import OneHotEncoder

# 对每一列分类数据应用独热编码器
OH_encoder = OneHotEncoder(
    handle_unknown = 'ignore', sparse = False
)
OH_train_cols = pd.DataFrame(
    OH_encoder.fit_transform(train_X[object_cols])
)
OH_val_cols = pd.DataFrame(
    OH_encoder.transforms(val_X[object_cols])
)
# 独热编码移除了索引,现将其恢复
OH_train_cols.columns = train_X.columns
OH_val_cols.columns = val_X.columns

# 移除分类列,用独热编码替代
num_train_X = train_X.drop(object_cols, axis = 1)
num_val_X = val_X.drop(object_cols, axis = 1)

# 将独热编码列添加到数值特征中
OH_train_X = pd.concat([num_train_X, OH_train_cols], axis = 1)
OH_val_X = pd.concat([num_val_X, OH_val_cols], axis = 1)

# 确保所有列均为字符串类型
OH_train_X.columns = OH_train_X.columns.astype(str)
OH_val_X.columns = OH_val_X.columns.astype(str)
建模
- 决策树
scikit-learn’s documentation
from sklearn.tree import DecisionTreeRegressor

model = DecisionTreeRegressor(random_state = 1)

model.fit(train_X, train_y)
random_state = 1:随机种子参数,确保每一次运行能得到相同的结果。
- 随机森林
from sklearn.ensemble import RandomForestRegressor

model = RandomForestRegressor(random_state = 1)

model.fit(train_X, train_y)
预测
pred_y = model.predict(val_X)
模型检验
- MAE(Mean Absolute Error)
error=actual−predicted
from sklearn.metrics import mean_absolute_error

mean_absolute_error(val_y, pred_y)
# 使用辅助函数来帮助比较不同 max_leaf_nodes 值的 MAE

from sklearn.metrics import mean_absolute_error
from sklearn.tree import DecisionTreeRegressor

def get_mae(max_leaf_nodes, train_X, val_X, train_y, val_y):
    model = DecisionTreeRegressor(max_leaf_nodes = max_leaf_nodes, random_state = 0)
    model.fit(train_X, train_y)

    pred_y = model.predict(val_X)

    mae = mean_absolute_error(val_y, pred_y)

    return(mae)
欠拟合(Underfitting)
定义:模型太简单,无法捕捉数据中的基本规律。
模型“学得太少了”,连基本规律都没掌握。
表现:
- 训练集上表现差(高偏差)
- 测试集上也表现差
- 模型复杂度低(比如用线性模型拟合非线性数据)
原因:
- 模型太简单(如用直线拟合曲线)
- 特征太少或特征工程不到位
- 训练时间太短(如神经网络没训练够)
解决方法:
- 增加模型复杂度(如用多项式、树模型、神经网络)
- 增加更多有用特征
- 减少正则化强度
- 训练更久(对神经网络等)
过拟合(Overfitting)
定义:模型太复杂,把训练数据中的噪声也学进去了。
模型“学得太多了”,把噪声当成了规律。
表现:
- 训练集上表现很好(甚至完美)
- 测试集上表现差(高方差)
- 模型复杂度高(如深度神经网络、决策树太深)
原因:
- 模型太复杂(参数太多)
- 训练数据太少
- 噪声太多
- 没有正则化或正则化太弱
解决方法:
- 增加训练数据(最有效)
- 简化模型(减少参数、层数、树深度)
- 使用正则化(L1/L2、Dropout、早停)
- 交叉验证调参
- 数据清洗(减少噪声)
训练误差 ↓
|
|     欠拟合   理想模型   过拟合
|       ↑         ↑         ↑
|     高偏差    低偏差    低偏差
|     高方差    低方差    高方差
|
+----------------------------→ 模型复杂度 ↑
数据泄露
| 分类 | 核心问题 | 举例 |
|---|---|---|
| 信息泄露 | 特征里混入了与标签强相关、但未来拿不到的数据 | 用“月末股价”预测“当月是否上涨” |
| 时间泄露 | 训练集用了未来的信息去预测过去 | 用2025年数据预测2024年销量 |
任何在预测时间点之后才能产生、更新、或观测到的数据,一律不能放进特征。
常见问题
① 标签混入特征
- 例:预测“用户是否会退货”,结果特征里有一个“退货金额”。
- 泄露点:退货金额只在用户真正退货后才产生。
② 预处理阶段穿越
- 例:先对整个数据集做
StandardScaler.fit(X),再划分训练集/测试集。- 泄露点:测试集的均值、方差被提前带进了训练集。
③ 时间窗口没对齐
- 例:用“用户未来7天平均浏览次数”预测“今天是否购买”。
- 泄露点:训练时这7天数据在“今天”之后,现在拿不到。
④ 聚合统计越界
- 例:预测“2025年Q1销售额”,却用了“2025全年客户总消费”当特征。
- 泄露点:全年数据在Q1结束时并不存在。
检查清单
- 划分训练/测试前先按时间排序,再用“滚动窗口”或“ 时间切分”。
- 类别型编码:只在训练集上
fit,测试集仅用transform。- 缺失值填补、归一化、降维等任何统计量,都只在训练集计算。
- 上线前做一次时间模拟,用当时真实能拿到的数据跑一遍推理。
- 评估曲线“好得离谱”时,先怀疑泄露,再怀疑模型棒。
# 交叉验证
from sklearn.model_selection import cross_val_score
cv_scores = cross_val_score(
    my_pipeline, X, y,
    cv = 5,
    scoring = accuracy
)
# 删除可能存在数据泄露的列
X_1 = X.drop(potential_leaks, axis = 1)
# 再次进行交叉验证
from sklearn.model_selection import cross_val_score
cv_scores = cross_val_score(
    my_pipeline, X_1, y,
    cv = 5,
    scoring = accuracy
)
集成方法
管道(pipelines)
把“数据预处理 → 特征工程 → 模型训练”所有步骤像水管一样串起来,形成一个大模型对象。
Pipeline([('name', transformer), ('name2', estimator)])
- 定义预处理步骤
from sklearn.compose import ColumnTransformer
from sklearn.pipeline import Pipeline
from sklearn.impute import SimpleImputer
from sklearn.preprocessing import OneHotEncoder

numerical_cols = [cname for cname in train_X.columns
                 if train_X[cname].dtype in ['int64', 'float64']]
# 选择具有相对较低基数(Cardinality)的分类列(虽然方便但有些武断)
categorical_cols = [cname for cname in train_X.columns
                   if train_X[cname].unique() < 10 and
                   train_X[cname].dtype = 'object']

# 对数值型数据进行预处理
numerical_transformer = SimpleImputer(stategy = 'constant')

# 对分类数据进行预处理
categorical_transformer = Pipeline(steps = [
    ('imputer', SimpleImputer(stategy = 'most_frequent')),
    ('onehot', OneHotEncoder(handle_unknown = 'ignore'))
])

# 将数值型数据和分类数据的预处理捆绑在一起
preprocessor = ColumnTransformer(
    transformers = [
        ('num', numerical_transformer, numerical_cols),
        ('cat', categorical_transformer, categorical_cols)
    ])
strategy='constant':用常数(默认是 0)填补缺失值。
stategy = 'most_frequent':用出现频率最高的类别填补缺失值。
handle_unknown='ignore':如果测试集中出现训练集中没有的类别,忽略它而不是报错。
- 定义模型
# 随机森林
from sklearn.ensemble import RandomForestRegressor

model = RandomForestRegressor(n_estimators = 100, random_state = 0)
- 创建并评估
管道会在生成预测之前自动对特征进行预处理。但如果没有管道,必须要在进行预测之前对验证数据进行预处理。
from sklearn.metrics import mean_absolute_error

# 将预处理和建模代码捆绑到管道中
my_pipeline = Pipeline(steps = [
    ('preprocessor', preprocessor),
    ('model', model)
])
# 预处理训练数据,拟合模型
my_pipeline.fit(train_X, train_y)

# 预处理验证数据,获取预测结果
pred_y = my_pipeline.predict(val_X)

# 评估模型
score = mean_absolute_error(val_y, pred_y)

# 或使用交叉验证
交叉验证(cross-validation)
把训练集平均切成 k 份,轮流用 k-1 份训练、1 份验证,循环 k 次,把 k 个得分平均,得到对泛化误差更稳健的估计。
cross_val_score(estimator, X, y, cv=k)
# 搭管道

from sklearn.ensemble import RandomForestRegressor
from sklearn.pipeline import Pipeline
from sklearn.impute import SimpleImputer

my_pipeline = Pipeline(steps = [
    ('preprocessor', SimpleImputer()),
    ('model',
     RandomForestRegressor(n_estimators = 50, random_state = 0))
])
# 交叉验证

from sklearn.model_selection import cross_val_score

score = -1 * cross_val_score(
    my_pipeline, X, y, cv = k, score = 'neg_mean_absolute_error'
)
梯度提升(Gradient Boosting)
高精度、高速度、鲁棒性强
把很多棵弱决策树,按梯度提升框架,逐棵纠正前一棵的残差,同时把正则化、缺失值处理、并行化、缓存优化全部做到极致。
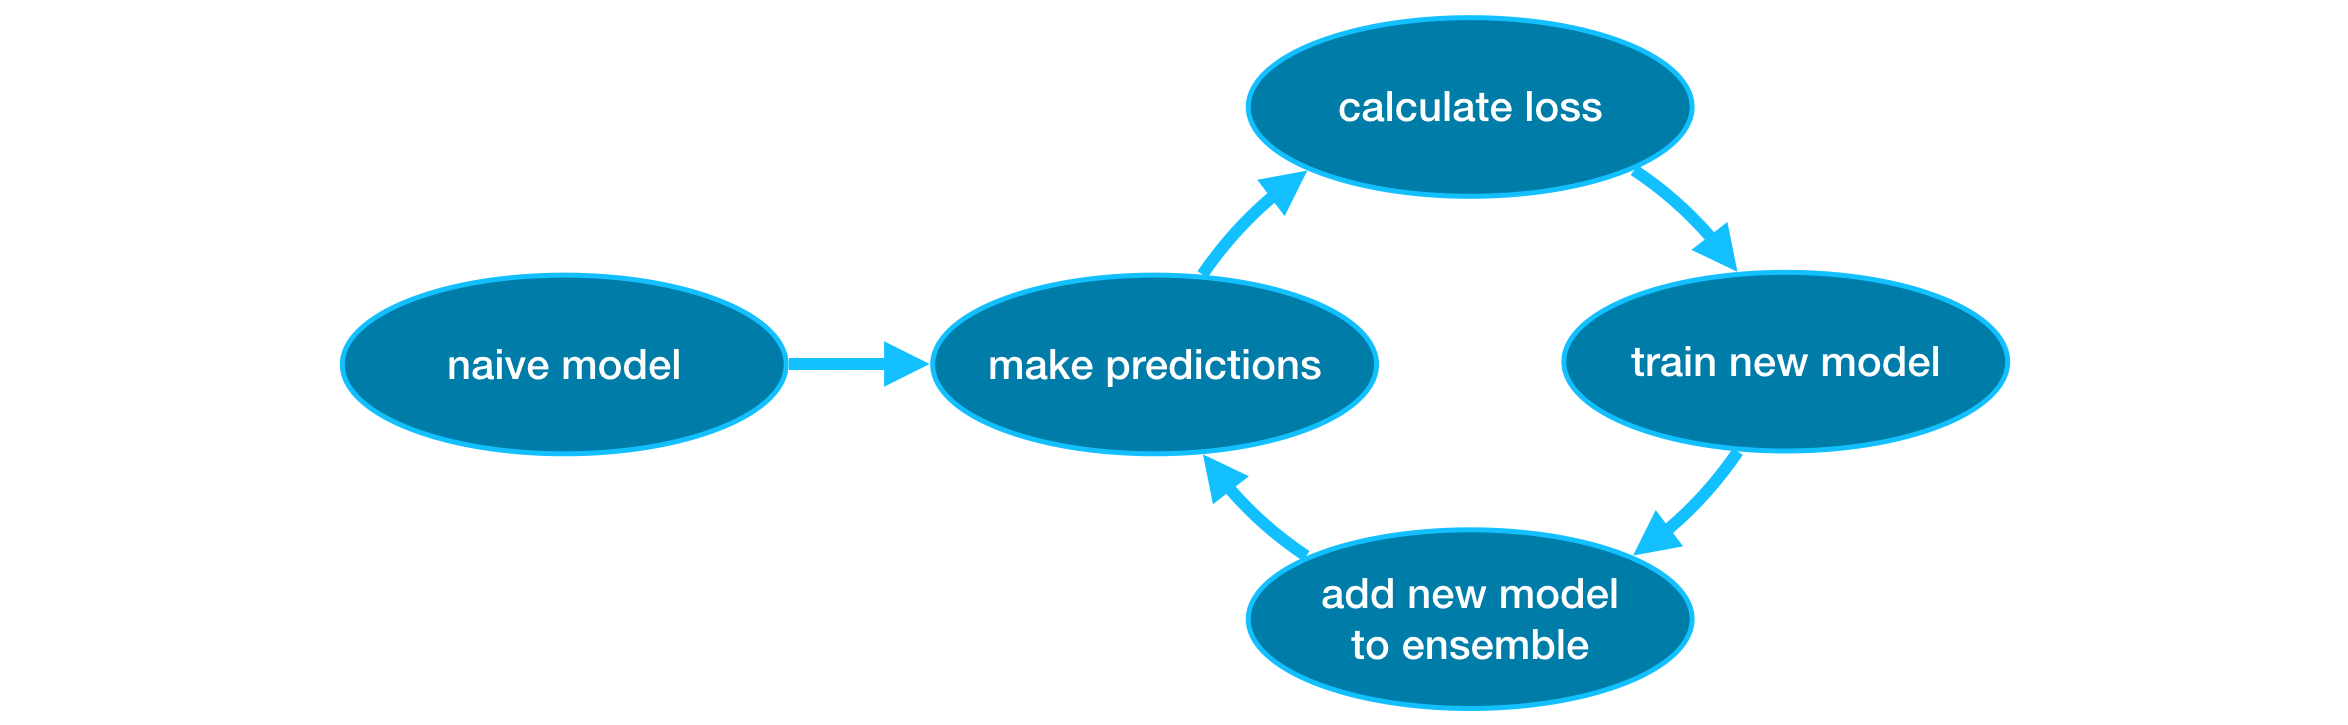
图源 Kaggle
from xgboost import XGBRegressor

model = XGBRegressor(
    n_estimators = 500,	# 最多训练 500 棵树(提升轮数)
    learning_rate = 0.05,	# 每棵树贡献的“步长”,小一点更稳健
    n_jobs = 4	# 并行训练用 4 个 CPU 核心
)

model.fit(
    train_X, train_y,
    early_stopping_rounds = 5,	 # 如果验证集性能连续 5 轮没有提升,就提前停止
    eval_set = [(val_X, val_y)],	# 用验证集评估性能
    verbose = False	# 训练过程不打印日志
         )
-
n_estimators:指定了要进行多少次上述建模循环。它等于包含在集成中的模型数量。-
如果值太低,会导致欠拟合,这会使训练数据和测试数据的预测都不够准确。
-
如果值太高,会导致过拟合,这会使训练数据的预测很准确,但测试数据的预测不准确。
-
典型值范围为 100 到 1000,但这很大程度上取决于
learning_rate参数。
-
-
learning_rate:- 一般来说,较小的
learning_rate和较多的n_estimators会得到更准确的 XGBoost 模型。 - 默认情况下,XGBoost 将
learning_rate设置为 0.1。
- 一般来说,较小的
-
n_jobs:- 通常会将参数
n_jobs设置为机器上的核心数。 - 在较小的数据集上,这样做并没有帮助。但在较大的数据集中,这很有用,否则在执行拟合命令时会花费很长时间等待。
- 通常会将参数
-
early_stopping_rounds在验证分数停止提升时停止模型的迭代,即使还没有达到n_estimators的硬性限制(允许连续恶化的轮数)。 -> 避免过拟合- 可以设置一个较高的
n_estimators值,然后使用early_stopping_rounds来找到停止迭代的最佳时机。
- 可以设置一个较高的
-
eval_set:指定验证集,用于监控模型在未见过的数据上的表现。 -
verbose = False:关闭训练日志输出,界面更干净。
# 做预测
pred_y = model.predict(val_X)

# 评估模型
from sklearn.metrics import  mean_absolute_error
mean_absolute_error(val_y, pred_y)
- 关键参数速查表
阶段 参数 作用 典型值 偏差 max_depth,n_estimators树深度、棵树 3-8, 300-1000 方差 subsample,colsample_bytree行/列采样 0.6-0.9 正则 gamma,min_child_weight,lambda,alpha剪枝+权重惩罚 0-1 学习率 learning_rate(eta)shrinkage 0.01-0.3 早停 early_stopping_rounds,eval_set防过拟合 50-100 调参顺序:先定
learning_rate和n_estimators,再调max_depth/min_child_weight,最后细调gamma/subsample/colsample+ 正则项。
内容参考:Kaggle
以上内容为参考网站资料后自己整理,如果有错误的地方,欢迎指出~
感谢阅读!
开源鸿蒙跨平台开发社区汇聚开发者与厂商,共建“一次开发,多端部署”的开源生态,致力于降低跨端开发门槛,推动万物智联创新。
更多推荐
 19
 0
- 0


 已为社区贡献2条内容

所有评论(0)