Kotlin 中的数据结构:数组 — [第一部分]
Kotlin 中的数据结构:数组 — [第一部分]
嘿大家!在本系列文章中,我们将探索数据结构及其在 Kotlin 中的实现。我们将探索不同类型的数据结构以及它们如何增强您的程序。当我们阐明数据结构背后的概念和技术时,我们将保持事情简单、谦虚和友好。
那么,让我们开始学习如何利用数据结构的力量。
什么是数据结构?
顾名思义,数据结构只是一种以易于访问和操作的方式构建或组织数据存储的方法。想想你如何整理你的衣柜。您是否按类型对项目进行分组或按颜色对它们进行排序?现在想象一下,您上班要迟到了,需要穿上合适的衣服。如果一切都一团糟,你将需要一些时间才能找到它(如果你能找到的话)。但如果你按照类型、颜色、风格和偏好来整理你的衣服,你可能会直接找到想要的物品,只需要几秒钟就可以拿到它。
结构化数据背后的想法本质上是相同的:组织存储的数据并优化访问和操作以有效地实现我们的目标。
当我们使用适当的数据结构时,我们可以以一种易于查找、插入、删除或修改数据中的信息的方式存储数据。这种结构化的数据组织可以更有效地执行操作,从而节省时间和资源。
因此,通过了解不同数据结构的特征和性能,可以选择一种优化在问题的特定上下文中最常执行的操作的数据结构。
连续数据结构与链接数据结构
数据结构可以分为两大类:连续的和链接的。连续的数据结构,例如数组、矩阵、堆和哈希表,由单个内存块组成,该内存块以连续的方式存储所有元素。这意味着元素在内存中彼此相邻放置,之间没有任何间隙。
另一方面,链接数据结构(例如列表、树和图邻接列表)由通过指针连接的单独内存块组成。每个块或节点都包含数据和指向结构中下一个节点的指针。
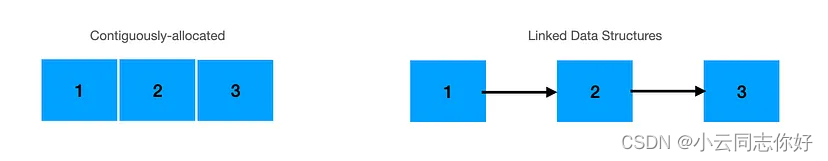
为了形象化这一点,可以将连续的结构想象为一长排依次放置的盒子,其中每个盒子都包含一个元素。在链接结构中,可以将其视为分散在各处的各个盒子的集合,每个盒子都有一个标签,指向序列中的下一个盒子。
这两类数据结构具有不同的特点,适用于不同的场景。连续结构允许使用索引有效地访问元素,但它们的大小一旦创建就固定了。另一方面,链接结构在大小和动态元素操作方面提供了更大的灵活性,但访问元素可能需要顺序遍历结构。
了解连续数据结构和链接数据结构之间的区别对于为特定数据操作需求选择正确的结构至关重要。
我们来谈谈连续分配的结构,数组。
什么是数组?
数组是一种基本的连续分配的数据结构,允许您存储相同类型的元素的集合。它提供了一种以系统的方式组织和访问这些元素的方法。
想象一下,您有一个架子,您想在其中整理不同类型的水果。每个水果代表我们数据结构中的一个元素。要创建此货架表示,您可以使用数组。
水果商品的货架展示
在数组中,您可以存储相同类型的元素,在本例中为水果。每个水果在数组中占据一个特定的位置或索引,就像架子上的每个隔间都装有一个特定的水果一样。该索引充当每种水果的唯一标识符,使我们能够单独定位和检索它们。
例如,让我们考虑一个名为 的数组fruits,它存储不同水果的名称:
val fruits: Array<String> = arrayOf("pear", "strawberry", "cherry", "apple", "banana")
在此数组中,每个水果或字符串都根据其索引分配一个位置。第一个水果“pear”的索引为 0,第二个水果“strawberry”的索引为 1,依此类推。
具有相应索引的水果商品的货架表示
要访问特定的水果或字符串,您可以参考其索引。例如,fruits[2]指索引为2的水果,即“樱桃”。通过使用适当的索引,您可以检索或修改数组中的单个水果或字符串。
访问元素
在数组中,元素存储在连续的内存位置中。这意味着元素在内存中被一个接一个地放置,它们之间没有任何间隙。每个元素占用固定数量的内存空间,由其数据类型决定。
为了访问特定元素,Kotlin 通过将索引乘以元素的大小来计算内存地址,从而产生偏移量。该偏移量表示从基地址到达所需元素所需的内存空间数量。
通过将此偏移量添加到基地址,我们获得了存储所需元素的精确内存地址。这使得我们能够直接访问内存中的元素,从而允许我们检索它的值或对其执行操作。
让我们考虑一个具有以下数组的示例:
val numbers: Array<Int> = arrayOf(10, 20, 30, 40, 50, 60)
在此数组中,第一个元素 10 存储在基内存地址 (201) 处。第二个元素 20 存储在下一个内存地址 (205),依此类推。
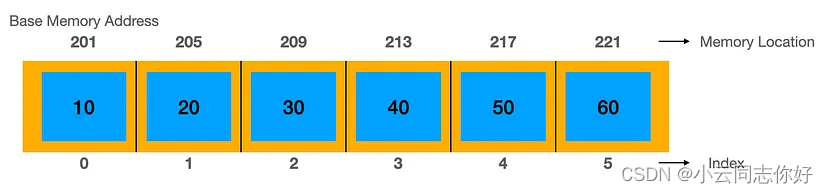
现在假设我们要访问索引 3 处的数组项的值。
1- 偏移量计算:由于我们使用的是整数数组,因此每个元素占用 4 个字节(假设是 32 位系统)。
-
Index: 3
-
Data type size: 4字节
-
Calculation: 3 * 4 = 12 bytes (索引 3 的偏移量)
2- 应用偏移量:我们将偏移量 (12) 添加到基地址,基地址是存储第一个元素 (10) 的内存位置 - 在本例中为 201。 -
基地址:第一个元素的内存位置 (10) = 201
-
计算:基地址 (201) + 偏移量 (12) = 内存位置 (213)
此过程允许高效且直接地访问数组中的特定元素。
需要注意的是,如果索引超出了数组的有效范围,则会抛出 IndexOutOfBoundsException。因此,在访问元素之前,请务必确保索引在有效范围内。
了解偏移量的计算方式及其与基地址的关系可以实现高效的数组元素访问。这种方法允许直接从内存中检索,而无需遍历整个数组。
特征
相同类型元素:数组中的所有元素必须具有相同的数据类型。例如,如果您有一个整数数组,则只能在其中放入整数。该规则确保数组可以有效地为元素分配内存并对它们执行操作。
固定大小:数组一旦创建,其大小就保持固定且无法更改。除非创建具有不同大小的新数组,否则无法在数组中添加或删除项目。
给定索引的恒定时间访问:数组中的每个元素都有一个唯一的索引,从 0 开始。这允许我们通过指定索引直接访问任何元素,而无需搜索或迭代整个数组。这就像通过知道其在盒子中的位置来立即找到您需要的物品一样。
性能考虑
🚀 空间效率:数组具有空间效率,因为它们纯粹由数据组成。链接或格式信息上不会浪费额外的空间。这就像有一个紧凑的盒子,可以有效地利用其所有可用空间来存储元素。
🚀 内存局部性:数组具有良好的内存局部性,这意味着访问数组中的连续元素速度更快。这是因为元素存储在连续的内存位置中,从而使计算机的高速缓存能够更有效地工作。
🚀 高效迭代:数组使用循环(例如 for 循环)提供对所有元素的高效迭代。元素可以被顺序地访问并一一处理。
🚀 访问时间复杂度为 O(1):由于数组的随机访问性质,通过索引访问元素的常量时间复杂度为 O(1)。这意味着无论数组的大小如何,访问元素所需的时间都保持不变。
🔻 内存开销:数组需要内存空间来将所有元素存储在连续位置。如果数组很大或者没有充分利用,这可能会导致内存开销。
🔻 插入和删除开销:在数组中间插入或删除元素需要移动后续元素以适应更改。这可能非常耗时,尤其是对于大型数组,因为它可能涉及移动许多元素,导致时间复杂度与数组大小 (O(n)) 成正比。
在 Kotlin 中的用法
在 Kotlin 中,表示数组的数据结构是类Array。该类Array是一个泛型类,可用于声明任何数据类型的数组,无论是原始数组还是对象数组。
要使用 Array 类声明数组,可以使用 arrayOf() 函数并指定括号内的元素。例如:
val array: Array<Int> = arrayOf(1, 2, 3, 4, 5)
Kotlin 还为原始数据类型的数组提供了专门的类,例如 IntArray、DoubleArray、BooleanArray 等。这些专门的类提供特定于每种数据类型的性能优化和附加功能。然而,由于对象表示,它们有一点额外的内存开销。
要声明基本类型的数组,可以使用相应的专用类。例如:
val intArray: IntArray = intArrayOf( 1 , 2 , 3 , 4 , 5 )
让我们看一个 Kotlin 中的示例,它演示了数组的各种属性:
fun  main () {
     // 创建整数数组
    val Numbers = arrayOf( 1 , 2 , 3 , 4 , 5 )

     // 通过索引访问元素
    val firstNumber = Numbers.first()
     val SecondNumber = Numbers[ 1 ]
     val LastNumber = Numbers.last()

     // 修改特定索引处的元素
    Numbers[ 3 ] = 10

    // 数组的长度
    val length = Numbers.size

     // 检查数组是否为空
    val isEmpty = Numbers.isEmpty()

     / / 迭代元素
    for (number in Numbers) {
        println(number)
    }

     // 查找特定元素的索引
    // 迭代数组直到找到该项目
    val index = Numbers.indexOf( 4 )

     // 检查 if数组中存在一个元素
    // 迭代数组,直到找到该项目
    val containsElement = Numbers.contains( 3 )

     // 将一个元素添加到数组
    // 创建另一个数组以重新分配项目
    val newArray = Numbers.plus( 6 )

     // 从数组中删除一个元素
    // 创建另一个数组来重新分配项目
    val returnedArray = Numbers.dropLast( 1 )

     // 打印数组
    println(numbers.contentToString())
}
该做什么和不该做什么
做:
- 当您有固定大小的相同类型元素集合时,请使用数组。
- 当您需要使用基于索引的检索直接有效地访问元素时,请使用数组。
- 当您想要以特定顺序存储元素时,请使用数组。
- 当您需要在循环中有效处理数据时,请使用数组,因为数组可以提供对元素的快速访问。
处理多维结构(例如矩阵或表)时使用数组。
不:
- 当数组的中间或开头有大量插入或删除时,不要使用数组。
- 当需要根据元素数量动态调整大小时,不要使用数组。
- 当需要复杂的搜索操作或自动排序时,不要使用数组。
- 当内存使用很关键并且数组大小未知时,不要使用数组。即使并非所有元素都被使用,数组也会分配内存,从而导致潜在的浪费。
请记住,数据结构的选择取决于您的具体需求和问题要求。在决定使用数组或探索替代数据结构之前,请考虑分析问题的特征。
现在就这样。
在接下来的文章中,我们将更深入地研究其他数据结构。我希望您觉得这个系列很有趣,并且在某种程度上对您有所帮助。

开源鸿蒙跨平台开发社区汇聚开发者与厂商,共建“一次开发,多端部署”的开源生态,致力于降低跨端开发门槛,推动万物智联创新。
更多推荐
 0
 0
- 0


 已为社区贡献3条内容

所有评论(0)